Un portrait de la santé britannique à 1,9 million de personnes
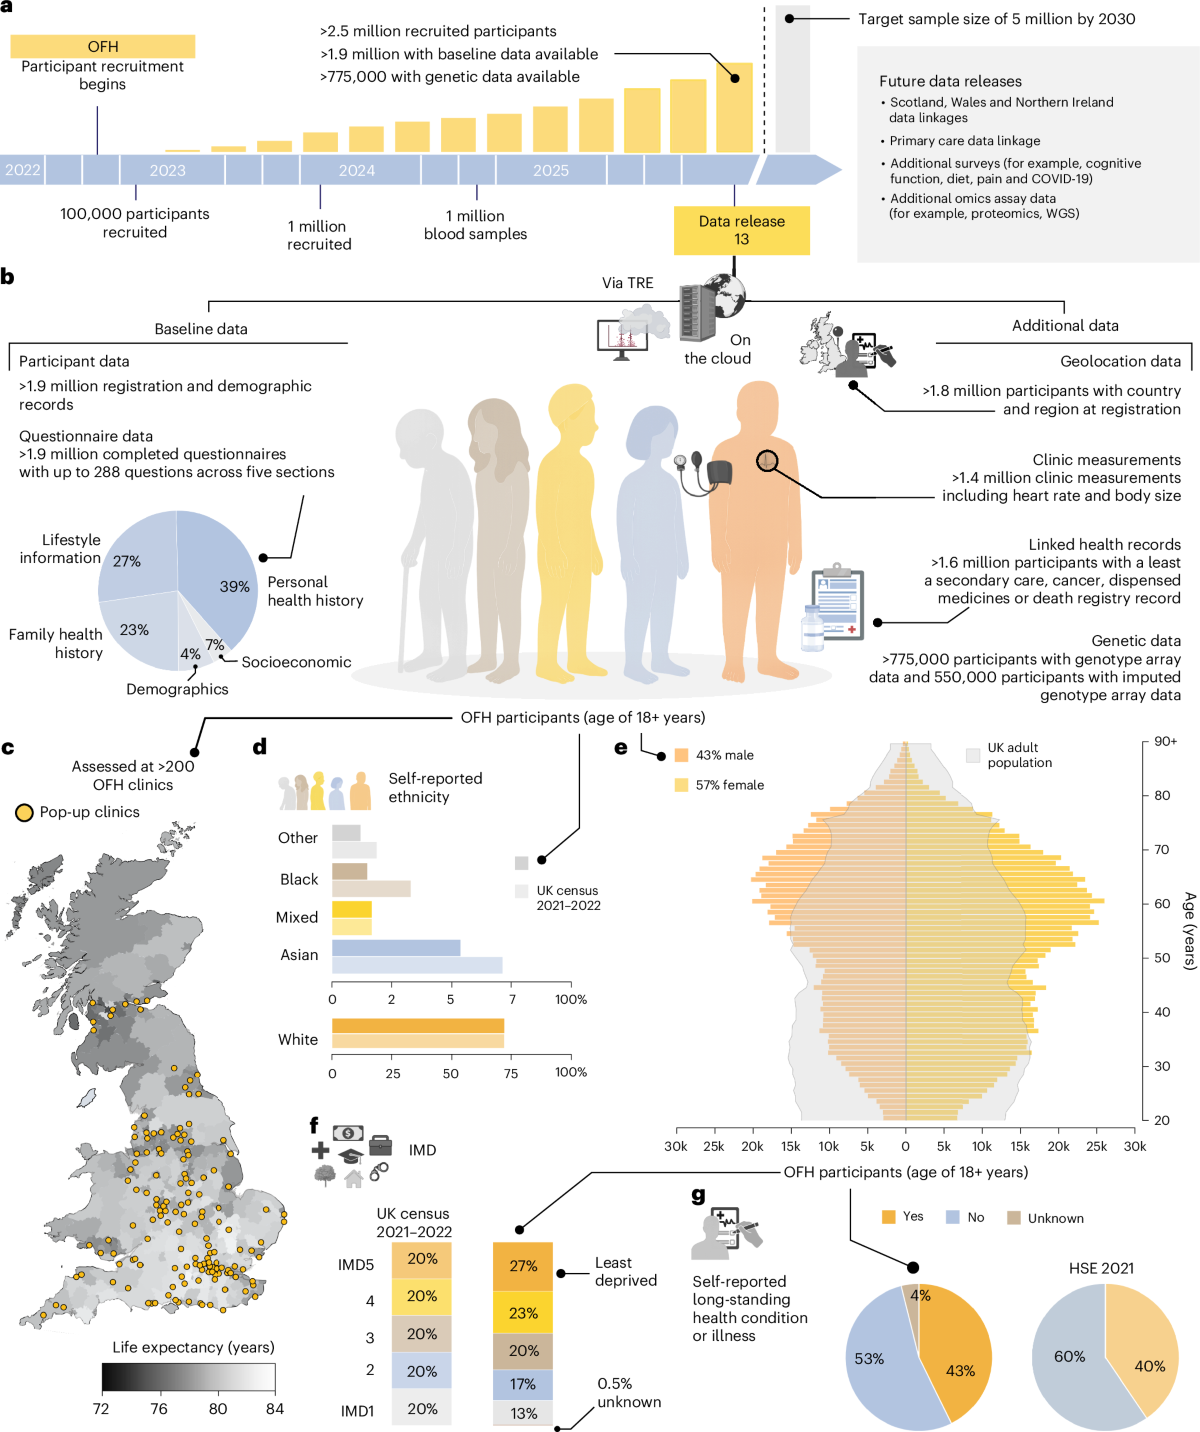
Une analyse publiée dans Nature Medicine le 10 septembre 2026 livre l'un des instantanés phénémiques les plus détaillés du Royaume-Uni assemblés à ce jour. Ces travaux proviennent d'Our Future Health, une cohorte prospective conçue pour recruter 5 millions d'adultes résidant au Royaume-Uni afin d'accélérer la découverte et la traduction de nouvelles approches de prévention, de détection et de traitement des maladies. Le recrutement a déjà dépassé 2,5 millions de personnes, et les dossiers phénotypiques initiaux sont désormais disponibles pour plus de 1,9 million d'entre elles. L'article est signé par Vincent J. Straub, Stefania Benonisdottir, Giovanni Scotti Bentivoglio, Neil Wary, Robert Campbell, Augustine Kong et Melinda C. Mills.
Plutôt que de se concentrer sur une seule pathologie, l'étude pose une question plus large : à quoi ressemble réellement cette population de volontaires en pleine croissance, et dans quelle mesure ses schémas de morbidité reflètent-ils le pays qu'elle est censée représenter ? Pour y répondre, les auteurs ont comparé la cohorte aux estimations nationales et à la cohorte plus ancienne de UK Biobank.
Ce que la cohorte enregistre réellement
L'effort de phénotypage constitue le fondement de tout ce qui suit. Les données initiales couvrent un large éventail de domaines pertinents pour la santé, en s'appuyant à la fois sur les déclarations des participants et sur le couplage avec des registres.
- Comportements liés à la santé autodéclarés, y compris les caractéristiques du mode de vie
- Informations de géolocalisation des participants
- Diagnostics et usages de médicaments autodéclarés
- Dossiers de consultations en hospitalisation et en ambulatoire
- Données des registres du cancer
- Informations sur les causes de décès
Cette combinaison est importante car elle permet aux chercheurs de dépasser une source de données unique. Comportements, diagnostics, prescriptions, recours aux soins et résultats de registres peuvent être évalués côte à côte, ce qui est précisément ce qu'exige la recherche en prévention à l'échelle des populations.
La cohorte ressemble-t-elle au pays ?
Sur les mesures sociodémographiques, de mode de vie et liées à la santé, le groupe de participants reflétait globalement les schémas de la population britannique — un signal encourageant pour une étude qui repose sur un recrutement volontaire à très grande échelle. Mais le tableau n'est pas uniforme. Tous les groupes ethniques minoritaires sauf un étaient sous-représentés par rapport à la population nationale, et les groupes les plus défavorisés sur le plan socioéconomique l'étaient également.
Cet écart n'est pas une simple note de bas de page. La défaveur socioéconomique et l'origine ethnique sont fortement liées à la charge de morbidité et à l'accès aux soins ; toute cohorte qui sous-échantillonne ces groupes risque donc de sous-estimer les inégalités mêmes que les programmes de prévention doivent cibler. Les auteurs affirment explicitement que l'évaluation systématique de ces biais reste une tâche ouverte à mesure que le recrutement se poursuit.
Les troubles de santé mentale se distinguent
Les estimations de prévalence de plusieurs pathologies majeures autodéclarées se situaient au-dessus des références nationales, les troubles de santé mentale — en particulier la dépression et l'anxiété — figurant parmi les exemples les plus nets. L'orientation de cet écart était cohérente avec ce que rapporte UK Biobank, avec une corrélation de 0,78 entre les deux cohortes pour l'ensemble des pathologies.
Plusieurs explications sont plausibles et non mutuellement exclusives : les cohortes de volontaires ont tendance à attirer des personnes déjà engagées dans la gestion de leur santé, l'autodéclaration capture des pathologies qui n'atteignent jamais un diagnostic formel, et les estimations nationales reposent sur des instruments de mesure différents. La concordance avec UK Biobank suggère que ce schéma est une propriété des grandes études de volontaires au Royaume-Uni plutôt qu'un artefact de ce jeu de données particulier.
Réplication des relations cliniques connues
L'analyse a également testé si les associations avec des corrélats cliniques établis se vérifiaient. Elles se sont vérifiées : la réplication entre les deux cohortes a atteint une corrélation de 0,80. En termes pratiques, les relations que les chercheurs s'attendent déjà à observer entre facteurs de risque, pathologies et résultats ont été reproduites à grande échelle — une étape de validation qui donne aux travaux de découverte en aval une base plus solide.
Usage des médicaments, cancer et gradients liés à l'âge
Les schémas d'usage des médicaments et la prévalence du cancer suivaient les gradients liés à l'âge que les cliniciens prédiraient, les participants plus âgés portant la charge la plus lourde. Une déviation notable est apparue pour le cancer du poumon, où les taux dans la cohorte étaient inférieurs aux données nationales — un résultat que les auteurs signalent plutôt qu'ils n'expliquent, et qui s'inscrit dans la question plus large de la manière dont l'échantillonnage de volontaires façonne ce qu'une cohorte observe.

Biais, dossiers électroniques et la route vers cinq millions
L'étude se présente comme une évaluation initiale plutôt qu'un verdict final. À mesure que le recrutement progresse, soutiennent les auteurs, les dossiers de santé électroniques peuvent aider à préciser les schémas de morbidité et permettre de mesurer systématiquement les biais plutôt que de les inférer. Relier les données de la cohorte aux dossiers de routine permettrait aux chercheurs de suivre les participants à travers le système de santé, de détecter les pathologies que l'autodéclaration manque et de quantifier dans quelle mesure la population recrutée s'écarte de la population nationale.
Cela importe pour la traduction. Si une cohorte doit soutenir la prévention et la détection précoce, ses estimations doivent être fiables au niveau de maladies spécifiques, de tranches d'âge spécifiques et de communautés spécifiques — pas seulement dans l'agrégat.
Pourquoi des cohortes comme celle-ci importent aujourd'hui
Les systèmes de santé subissent une pression croissante liée à une charge de maladies chroniques en augmentation, alimentée par le vieillissement, les changements de mode de vie et les expositions environnementales, ainsi que par des inégalités de santé persistantes et des données fragmentées. La recherche biomédicale a répondu en combinant divers types de données — multiomique, facteurs de mode de vie, déterminants sociaux et mesures environnementales — pour évaluer la santé des populations et identifier les groupes à risque plus élevé.
Les grandes études de cohorte et les biobanques occupent une place centrale dans cette évolution, en collectant, stockant et gérant systématiquement des données de santé et biologiques sur de longues périodes. L'ampleur d'Our Future Health, si la représentation s'améliore, en ferait l'un des instruments les plus puissants disponibles pour étudier comment les maladies émergent à l'échelle d'une population nationale entière.
Ce qu'il faut surveiller ensuite
- Si le recrutement comble les écarts pour les groupes ethniques minoritaires sous-représentés et les groupes défavorisés
- Dans quelle mesure le couplage avec les dossiers de santé électroniques modifie les estimations de prévalence de la dépression et de l'anxiété
- Si le signal d'un cancer du poumon inférieur à la moyenne nationale persiste à mesure que la cohorte vieillit
- Comment les couches génétiques et biologiques de la cohorte se connectent à la base phénotypique décrite ici
Pour l'instant, l'analyse fournit quelque chose de rare : une comptabilité transparente de ce que contient une très grande cohorte britannique, de la manière dont elle se compare à la nation et à une biobanque établie, et de l'endroit où subsistent ses angles morts.
Cet article est basé sur un reportage de Nature Medicine. Lire l'article original.
Originally published on nature.com