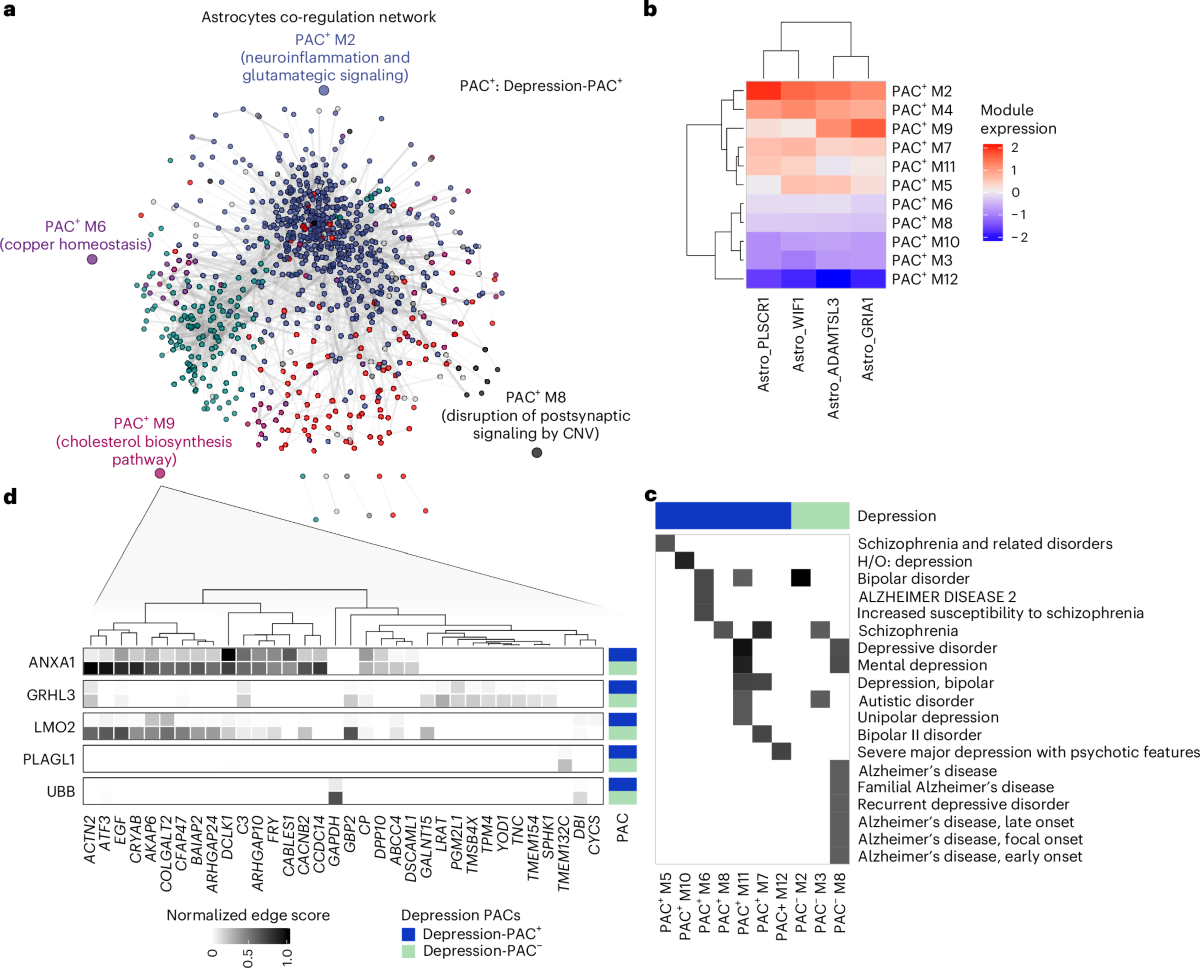
La maladie d'Alzheimer est l'une des énigmes les plus tenaces de la médecine. Deux patients peuvent porter le même diagnostic, obtenir des scores similaires aux mêmes tests de mémoire, et pourtant différer énormément quant aux cellules cérébrales qui défaillent en premier, aux voies moléculaires qui s'altèrent et à la rapidité du déclin. Une étude publiée en ligne dans Nature Medicine le 23 septembre 2026 soutient que l'intelligence artificielle peut aider à donner un sens à cette variabilité à une échelle que les méthodes antérieures ne pouvaient atteindre.
L'article, intitulé « AI-based characterization of Alzheimer's disease phenotypes from population-scale single-cell data », applique une analyse par apprentissage automatique à des mesures unicellulaires issues d'une cohorte de 584 donneurs de cerveau — un groupe qui comprend des patients atteints de la maladie d'Alzheimer ainsi que des donneurs de comparaison. L'ambition affichée est simple à décrire et difficile à exécuter : plutôt que de traiter la maladie d'Alzheimer comme une affection unique et uniforme, utiliser des méthodes computationnelles pour classer les profils moléculaires de cellules individuelles en phénotypes pathologiques reconnaissables.
Pourquoi le tissu cérébral en vrac brouille le tableau
Pendant la majeure partie de l'histoire de la recherche sur la maladie d'Alzheimer, les scientifiques ont étudié le tissu cérébral en vrac. Broyez une région du cortex, mesurez l'activité moyenne de milliers de gènes à travers des millions de cellules, et vous obtenez un chiffre propre et reproductible. Mais une moyenne décrit mal un voisinage. Si une petite population de cellules immunitaires déclenche une réponse inflammatoire tandis que la plupart des neurones vaquent simplement à leurs occupations, ce signal peut être dilué jusqu'à devenir invisible. Le même problème se pose en sens inverse : une mesure dominée par le type cellulaire le plus abondant peut masquer le comportement de tout le reste.
Les technologies unicellulaires ont changé l'arithmétique. Au lieu d'une mesure par région cérébrale, les chercheurs peuvent désormais capturer l'activité génique dans des milliers de cellules ou de noyaux individuels à la fois, donnant à chacun une identité moléculaire. Le résultat n'est pas une courbe unique mais une vaste matrice creuse de cellules et de gènes — un jeu de données dont la taille même est précisément ce qui rend l'apprentissage automatique attractif.
Les types cellulaires qui dominent la conversation
- Les neurones portent la machinerie électrique et synaptique dont dépend la mémoire, et leur vulnérabilité sélective dans différentes régions cérébrales est une caractéristique déterminante de la maladie.
- Les astrocytes soutiennent le métabolisme neuronal et aident à maintenir la barrière hémato-encéphalique, et ils peuvent basculer vers des états réactifs qui protègent ou endommagent les tissus environnants.
- Les microglies sont les cellules immunitaires résidentes du cerveau ; leurs états d'activation figurent parmi les variables les plus étudiées dans la recherche sur la maladie d'Alzheimer.
- Les oligodendrocytes et leurs précurseurs enveloppent les axones de myéline, et les modifications du soutien de la substance blanche peuvent altérer la vitesse de communication des circuits neuronaux.
- Les cellules vasculaires et de barrière tapissent l'approvisionnement sanguin du cerveau, où les fuites et les mécanismes d'élimination altérés sont depuis longtemps impliqués dans la progression de la maladie.
Ce que l'IA apporte réellement
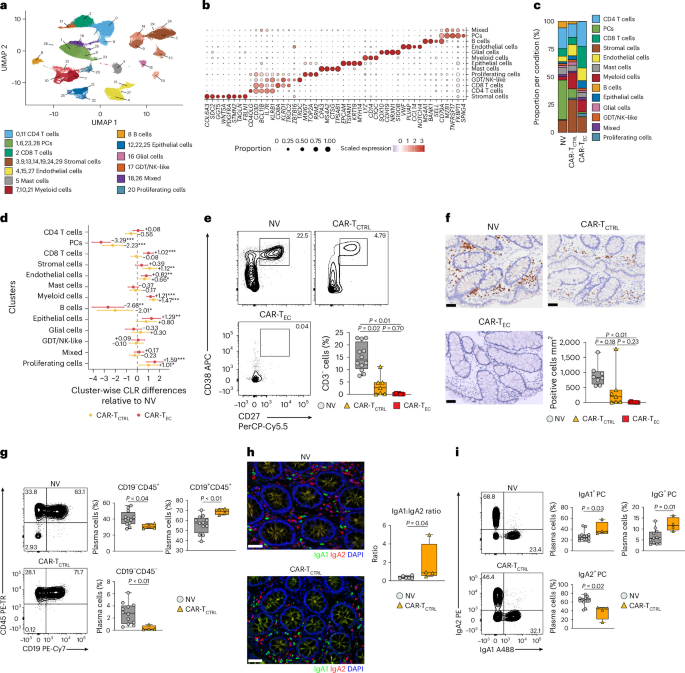
Une fois qu'un jeu de données contient des centaines de milliers de cellules, chacune décrite par des milliers de gènes, aucun humain ne peut l'examiner à l'œil nu. Des méthodes d'apprentissage automatique sont utilisées pour compresser cette dimensionnalité, regrouper les cellules aux profils similaires et rechercher une structure qui recoupe les catégories conventionnelles — par exemple, des états cellulaires situés entre deux types connus, ou des motifs au niveau des donneurs qui n'émergent que lorsque des centaines d'individus sont comparés simultanément.
Le mot « characterization » dans le titre de l'article compte. Il ne s'agit pas d'une prétention d'avoir construit un test diagnostique, ni d'une promesse qu'un modèle peut prédire qui développera la maladie d'Alzheimer. C'est un travail descriptif et organisationnel : prendre une maladie hautement hétérogène et demander si sa présentation moléculaire se résout en un plus petit nombre de phénotypes cohérents qui peuvent être nommés, comparés et finalement ciblés.
Le poids de 584 donneurs de cerveau
Le tissu cérébral humain est une ressource rare. Les programmes de dons nécessitent des années de coordination avec les familles, les cliniciens et les pathologistes, et chaque spécimen arrive avec son propre historique d'âge, de génétique, de médicaments et d'intervalle post-mortem. Assembler une cohorte de 584 donneurs est donc en soi une réalisation logistique substantielle, et c'est l'expression « population-scale » dans le titre qui signale pourquoi l'étude peut tenter quelque chose qu'un petit échantillon ne pourrait pas faire.
L'échelle achète la puissance statistique. Les états cellulaires rares, les décalages subtils dans la proportion d'un type cellulaire par rapport à un autre, et les interactions entre risque génétique et comportement cellulaire ne deviennent détectables que lorsque suffisamment de donneurs sont comparés. Elle permet aussi le type de réplication interne dont les études d'apprentissage automatique ont besoin : un motif trouvé dans un sous-ensemble de donneurs peut être testé contre un autre avant que quiconque affirme qu'il est réel.

Pourquoi les phénotypes comptent plus qu'une étiquette unique
Le développement de médicaments contre la maladie d'Alzheimer a été façonné par l'hypothèse qu'une maladie nécessite un mécanisme et un traitement. Cette hypothèse a produit des décennies de déceptions coûteuses. Si l'affection est en fait une famille de phénotypes moléculaires apparentés mais distinguables, alors moyenner les résultats sur tous les patients pourrait masquer de véritables bénéfices dans un sous-groupe — et pourrait tout aussi bien exposer les patients à des effets secondaires d'un traitement visant la mauvaise biologie.
La pensée « phénotype d'abord » n'est pas nouvelle en oncologie, où le profilage tumoral est une pratique standard avant la sélection du traitement. La question que pose cette ligne de recherche est de savoir si la neurodégénérescence peut être abordée de la même manière, en utilisant des signatures cellulaires et moléculaires plutôt que les seuls symptômes cliniques pour définir qui est un patient.
Limites et questions ouvertes
Le tissu post-mortem offre un instantané, souvent pris à la fin d'une longue maladie. Il peut révéler quels états cellulaires accompagnent la maladie avancée, mais il ne peut pas facilement établir quels changements sont survenus en premier ou lesquels sont des causes plutôt que des conséquences. Les cohortes de donneurs présentent aussi des biais bien connus des chercheurs : les personnes qui donnent leur cerveau ne constituent pas un échantillon aléatoire de la population, et la maladie elle-même peut altérer les profils cellulaires d'une manière sans rapport avec sa cause profonde.
Il y a aussi le danger familier d'appliquer des modèles puissants à une biologie complexe. L'apprentissage automatique peut trouver une structure qui reflète des artefacts techniques — des différences dans la façon dont les échantillons ont été traités, ou dans la façon dont les cellules ont été séquencées — plutôt que la maladie. La réplication indépendante dans des cohortes distinctes, et la validation par des méthodes complémentaires, sont ce qui sépare un motif convaincant d'une découverte durable.
Ce qu'il faut surveiller ensuite
- La réplication : si les mêmes phénotypes réapparaissent dans des collections de donneurs indépendantes et chez des patients vivants échantillonnés par le sang ou le liquide céphalorachidien.
- Le contexte spatial : si les états cellulaires identifiés dans un tissu dissocié peuvent être ramenés à leurs voisinages physiques, puisque l'emplacement façonne la fonction.
- La traduction clinique : si un phénotype correspond à une différence mesurable dans la progression ou la réponse au traitement.
- Le partage des données : si les données cellulaires sous-jacentes sont publiées sous une forme que d'autres groupes peuvent réutiliser, ce qui détermine la rapidité avec laquelle le domaine peut s'appuyer sur le résultat.
Le résumé publié de l'étude est délibérément compact, et le détail substantiel — quels phénotypes ont émergé, leur stabilité et leur relation avec les marqueurs génétiques et pathologiques existants — se trouve dans l'article complet. Ce que le résumé établit, c'est la forme de l'effort : une tentative pilotée par l'IA de remplacer une étiquette unique et grossière de la maladie d'Alzheimer par une description cellulaire plus précise, appliquée à une échelle qui n'était pas possible il y a une décennie. La solidité de cette description sera décidée par la réplication, non par l'élégance du modèle.
Cet article est basé sur un reportage de Nature Medicine. Lire l'article original.
Originally published on nature.com


