दो अलग-अलग सवालों के इर्द-गिर्द बना एक अध्ययन
Nature Medicine ने 13 सितंबर 2026 को यह पेपर ऑनलाइन "Clinical usability of an explainable AI decision support tool and evaluation of multimodal models in NSCLC" शीर्षक के तहत प्रकाशित किया। इस शीर्षक की शब्दावली उतनी ही मायने रखती है जितना इसके भीतर मौजूद कोई भी नतीजा। लेखकों ने एक साथ दो काम करने का लक्ष्य रखा: यह बेंचमार्क करना कि मल्टीमॉडल मॉडल नॉन-स्मॉल सेल लंग कैंसर को कितनी अच्छी तरह संभालते हैं, और यह परखना कि उस तरह के मॉडल पर बना निर्णय समर्थन उपकरण उन चिकित्सकों के लिए वास्तव में उपयोगी है या नहीं, जो उस पर निर्भर होंगे।
यह दोहरा ढांचा इस काम को उन लगातार आने वाले पेपरों से अलग करता है जो एक ही प्रदर्शन आंकड़ा बताकर रुक जाते हैं। कोई मॉडल किसी अलग रखे गए टेस्ट सेट पर प्रभावशाली स्कोर कर सकता है और फिर भी क्लिनिक में निराश कर सकता है — अगर उसके आउटपुट वर्कफ़्लो में बहुत देर से आते हैं, अगर इंटरफ़ेस यह छिपा देता है कि कोई सिफ़ारिश क्यों आई, या अगर व्याख्या इंजीनियरों के लिए लिखी गई हो, ऑन्कोलॉजिस्ट के लिए नहीं। प्रकाशन के साथ दिए गए सारांश के अनुसार, लेखकों के मूल्यांकन में मल्टीमॉडल व्याख्यायोग्य मॉडल आगे निकला। नैदानिक उपयोगिता में स्पष्ट रुचि यह संकेत देती है कि टीम ने उस नतीजे को अंतिम रेखा नहीं, बल्कि शुरुआती बिंदु माना।
इस संदर्भ में "मल्टीमॉडल" का अर्थ
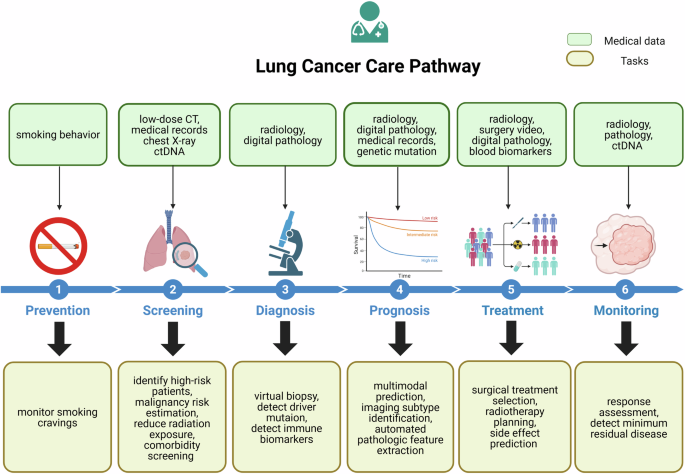
मल्टीमॉडल मॉडल एक साथ एक से अधिक प्रकार के इनपुट लेते हैं, बजाय इसके कि किसी एक स्कैन या किसी एक लैब पैनल को पूरी कहानी मान लें। नॉन-स्मॉल सेल लंग कैंसर में प्रासंगिक इनपुट असामान्य रूप से विविध होते हैं। इमेजिंग अध्ययन ट्यूमर के आकार, स्थान और फैलाव को दर्ज करते हैं। पैथोलॉजी स्लाइड्स ऊतक-स्तर का विवरण देती हैं कि कैंसर कोशिकाएं कैसी दिखती हैं और कितनी आक्रामक लगती हैं। क्लिनिकल रिकॉर्ड में परफ़ॉर्मेंस स्टेटस, धूम्रपान का इतिहास, पूर्व उपचार और सह-रुग्णताएं होती हैं। मॉलिक्यूलर टेस्टिंग ऐसे ड्राइवर परिवर्तन जोड़ती है जो तेजी से यह तय करते हैं कि मरीज़ को कौन-सी थेरेपी दी जाए।
वर्षों तक ये धाराएं अलग-अलग सिस्टमों में रहती थीं और चिकित्सक के दिमाग में मिलाई जाती थीं। एक मल्टीमॉडल मॉडल इन्हें जोड़ने का प्रयास करता है, इस आधार पर कि यह संयोजन ऐसी जानकारी रखता है जो कोई अकेला स्रोत नहीं रखता। कठिनाई यह है कि हर धारा के अपने गायब डेटा के पैटर्न, अपनी इकाइयां और अपनी विश्वसनीयता होती है। जब कोई मॉडल एक साथ इन सबका उपयोग करता है, तो यह सवाल कि किस इनपुट ने किसी आउटपुट को निर्धारित किया, जवाब देना कठिन हो जाता है — और यहीं व्याख्यायोग्यता की भूमिका शुरू होती है।

व्याख्यायोग्यता एक नैदानिक आवश्यकता के रूप में, न कि अतिरिक्त लाभ
व्याख्यायोग्य मॉडल वह होता है जिसके तर्क को किसी व्याख्यायोग्य रूप में मनुष्य के सामने प्रस्तुत किया जा सके। ऑन्कोलॉजी में यह कोई सौंदर्य-संबंधी पसंद नहीं है। NSCLC में उपचार के निर्णयों में वास्तविक विषाक्तता, वास्तविक लागत और वास्तविक अपरिवर्तनीयता होती है, और ऐसी सिफ़ारिश जिस पर सवाल न किया जा सके, उस पर जिम्मेदारी से कार्य करना कठिन है। जब कोई उपकरण किसी मरीज़ को एक मार्ग के बजाय दूसरे के लिए उपयुक्त बताता है, तो इलाज करने वाली टीम को यह जानना होता है कि किन विशेषताओं ने इस आकलन को आगे बढ़ाया और कितनी मजबूती से।
पेपर का ढांचा व्याख्यायोग्यता और उपयोगिता को क्रमिक नहीं, बल्कि जुड़ी हुई समस्याओं के रूप में देखता है। इस जोड़ी से उठने वाले विचारों में शामिल हैं:
- क्या व्याख्याएं उन शब्दों में व्यक्त की जाती हैं जो चिकित्सक पहले से उपयोग करते हैं, न कि अमूर्त फ़ीचर भारों में।
- क्या उपकरण उस निर्णय को स्पष्ट करता है जिस पर चिकित्सक पहले से विचार कर रहा था, या ऐसा प्रतिस्पर्धी निर्णय पेश करता है जिसे निपटाना पड़े।
- क्या व्याख्याएं कागज़ पर समान दिखने वाले मरीज़ों में स्थिर रहती हैं, ताकि भरोसा संयोग पर न बने।
- क्या इंटरफ़ेस वास्तविक ट्यूमर बोर्ड की गति के अनुरूप है, जहां प्रति केस समय मिनटों में मापा जाता है।
इनमें से हर एक उपयोगिता का सवाल है, उतना ही जितना मशीन लर्निंग का सवाल, और हर एक ऐसी चीज़ है जिसका जवाब कोई पूर्णतः पूर्वव्यापी सटीकता बेंचमार्क नहीं दे सकता।
"बड़ा, अंतरराष्ट्रीय, वास्तविक-विश्व" क्यों मायने रखता है
अध्ययन को एक बड़ा अंतरराष्ट्रीय वास्तविक-विश्व जांच बताया गया है। ये तीनों विशेषण मिलकर बहुत काम करते हैं। बहु-केंद्रीय और बहु-देशीय डेटा इस जोखिम को कम करते हैं कि मॉडल ने बस किसी एक अस्पताल के उपकरणों, कोडिंग परंपराओं या रेफ़रल पैटर्न की आदतें सीख ली हैं। वास्तविक-विश्व डेटा, कसकर चुने गए ट्रायल समूहों के विपरीत, उन मरीज़ों के अधिक अव्यवस्थित मिश्रण को दर्शाता है जिन्हें चिकित्सक वास्तव में देखते हैं — उन सहित जो किसी संभाव्य अध्ययन में सख्त पात्रता मानदंड कभी पूरे न करते।
समझौता यह है कि वास्तविक-विश्व डेटासेट अधिक शोरयुक्त होते हैं, और कच्चे रिकॉर्ड से मॉडल-तैयार इनपुट तक का रास्ता शायद ही कभी साफ़ होता है। कोई टीम इस रूपांतरण को कैसे संभालती है, यह तय करता है कि रिपोर्ट किया गया प्रदर्शन अंततः क्या मायने रखता है। बड़ा अंतरराष्ट्रीय नमूना सिद्धांत रूप में निष्कर्षों को अधिक सुसंगत बनाता है, लेकिन सुसंगतता फिर भी मान लेने के बजाय प्रदर्शित करनी होती है।

जहां AI उपकरण आमतौर पर अटकते हैं
नैदानिक उपयोगिता परीक्षण उस अंतर को संबोधित करता है जो काम करने वाले मॉडल और उपयोग किए जाने वाले मॉडल के बीच होता है। नैदानिक AI में बार-बार होने वाली विफलताएं अच्छी तरह दर्ज हैं: ऐसे अलर्ट जो इतनी बार आते हैं कि उन्हें नज़रअंदाज़ कर दिया जाता है, ऐसे डैशबोर्ड जो स्क्रीन पर पहले से मौजूद जानकारी को दोहराते हैं, और ऐसे आउटपुट जो निर्णय प्रभावी रूप से हो जाने के बाद आते हैं। एक निर्णय समर्थन उपकरण को ऐसे वर्कफ़्लो में अपनी जगह कमानी होती है जो पहले से भरा हुआ है।
शीर्षक में सीधे नैदानिक उपयोगिता का नाम लेकर, अध्ययन संकेत देता है कि लेखकों ने भेदभाव और कैलिब्रेशन से आगे कुछ मापा। उपयोगिता कार्य आमतौर पर पूछता है कि क्या चिकित्सक उपकरण के आउटपुट की व्याख्या कर सकते हैं, क्या वे उससे सहमत हैं, क्या यह उनकी बताई गई योजना को बदलता है, और क्या यह उन्हें धीमा करता है। इन मापों को किसी हेडलाइन आंकड़े में समेटना कठिन होता है, यही एक कारण है कि इन्हें अक्सर छोड़ दिया जाता है।
पेपर जो सवाल खुले छोड़ता है
इस आकार के एक अकेले अध्ययन की सीमा से बाहर कई चीज़ें हैं। पूर्वव्यापी परिणामों के आधार पर मापा गया प्रदर्शन, बेहतर रोगी परिणामों के समान नहीं है, और बाद वाले को प्रदर्शित करने के लिए संभाव्य मूल्यांकन चाहिए। व्याख्या की गुणवत्ता को मात्रात्मक रूप से आंकना भी कठिन है — कोई मॉडल व्याख्या उत्पन्न कर सकता है, बिना यह ज़रूरी हो कि वह व्याख्या उस गणना के प्रति निष्ठावान हो जिसने भविष्यवाणी बनाई। और अपनाया जाना संस्थागत कारकों पर निर्भर करता है, इलेक्ट्रॉनिक रिकॉर्ड एकीकरण से लेकर इस बात तक कि जब सिफ़ारिश मानी जाए और परिणाम खराब हो, तो दायित्व किस पर होता है।
यह सवाल भी है कि अभ्यास बदलने के साथ ऐसा उपकरण कैसा व्यवहार करता है। NSCLC में उपचार के प्रतिमान तेजी से बदलते हैं, क्योंकि नई एजेंट और बायोमार्कर-निर्धारित उपसमूह उभरते हैं। किसी एक युग के निर्णयों पर प्रशिक्षित मॉडल ऐसे पैटर्न सीख सकता है जिन्हें चिकित्सक अब तक छोड़ चुके हैं।

यह अब क्यों प्रासंगिक है
फेफड़ों का कैंसर निर्णय समर्थन के लिए सबसे महत्वपूर्ण क्षेत्रों में से एक बना हुआ है, क्योंकि संभावित उपचार मार्गों की संख्या हर केस पर विचार करने के लिए उपलब्ध समय से तेजी से बढ़ी है। मल्टीमॉडल मॉडल उस विचार-प्रक्रिया को संपीड़ित करने का वादा करते हैं; व्याख्यायोग्यता और उपयोगिता तय करती हैं कि यह संपीड़न भरोसेमंद है या नहीं। मॉडल मूल्यांकन और नैदानिक उपयोगिता आकलन के इस संयोजन को किसी उच्च-प्रोफ़ाइल मंच पर प्रकाशित करना एक संकेत स्थापित करता है: क्षेत्र से अब तेजी से यह मांग की जा रही है कि वह न केवल यह दिखाए कि कोई मॉडल अच्छी भविष्यवाणी करता है, बल्कि यह भी कि कोई चिकित्सक उसके साथ काम कर सकता है। अगली परीक्षा यह है कि इस तरह के उपकरण तब टिकते हैं या नहीं जब उन्हें संभाव्य रूप से, उन क्लिनिकों में तैनात किया जाता है जो उन्हें उपयोग करेंगे।
यह लेख Nature Medicine की रिपोर्टिंग पर आधारित है। मूल लेख पढ़ें।
Originally published on nature.com

