Une étude construite autour de deux questions distinctes
Nature Medicine a publié l'article en ligne le 13 septembre 2026 sous le titre « Clinical usability of an explainable AI decision support tool and evaluation of multimodal models in NSCLC ». La formulation compte autant que n'importe quel résultat qu'elle contient. Les auteurs se sont fixé deux objectifs à la fois : évaluer la performance des modèles multimodaux face au cancer du poumon non à petites cellules, et tester si un outil d'aide à la décision construit autour de ce type de modèle est réellement utilisable par les cliniciens qui en dépendraient.
Ce double cadrage distingue le travail du flux constant d'articles qui rapportent un unique chiffre de performance et s'arrêtent là. Un modèle peut obtenir un score impressionnant sur un jeu de test isolé et néanmoins décevoir en clinique — si ses résultats arrivent trop tard dans le flux de travail, si l'interface masque les raisons d'une recommandation, ou si l'explication est rédigée pour des ingénieurs plutôt que pour des oncologues. Selon le résumé accompagnant la publication, le modèle multimodal explicable s'est distingué dans l'évaluation des auteurs. L'intérêt explicite porté à l'utilisabilité clinique suggère que l'équipe a considéré ce résultat comme un point de départ plutôt qu'une ligne d'arrivée.
Ce que « multimodal » signifie dans ce contexte
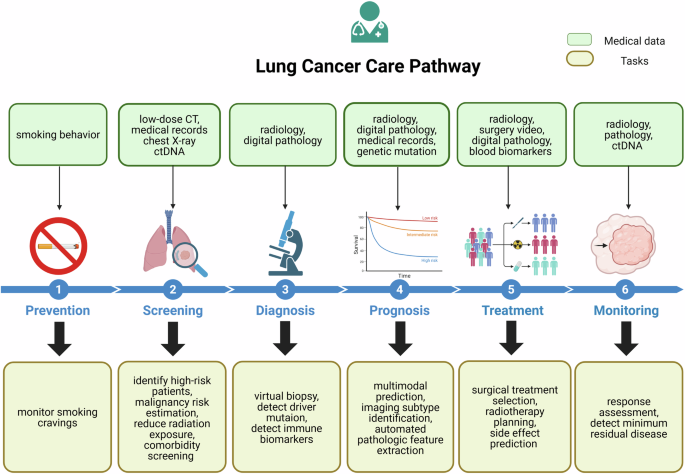
Les modèles multimodaux consomment simultanément plus d'un type d'entrée, plutôt que de traiter un seul examen d'imagerie ou un seul bilan biologique comme l'histoire complète. Dans le cancer du poumon non à petites cellules, les entrées pertinentes sont inhabituellement variées. Les examens d'imagerie capturent la taille, la localisation et l'extension de la tumeur. Les lames d'anatomopathologie portent des détails au niveau tissulaire sur l'aspect des cellules cancéreuses et leur agressivité apparente. Les dossiers cliniques contiennent l'état général, les antécédents tabagiques, les traitements antérieurs et les comorbidités. Les tests moléculaires ajoutent les altérations driver qui déterminent de plus en plus les thérapies proposées à un patient.
Pendant des années, ces flux ont vécu dans des systèmes séparés et étaient réconciliés dans la tête du clinicien. Un modèle multimodal tente de les combiner, en partant du principe que la combinaison porte une information qu'aucune source unique ne contient. La difficulté est que chaque flux a ses propres schémas de données manquantes, ses propres unités et sa propre fiabilité. Lorsqu'un modèle s'appuie sur tous à la fois, la question de savoir quelle entrée a déterminé une sortie donnée devient plus difficile à trancher — et c'est précisément là qu'intervient l'explicabilité.
L'explicabilité comme exigence clinique, non comme bonus
Un modèle explicable est un modèle dont le raisonnement peut être présenté à un humain sous une forme interprétable. En oncologie, il ne s'agit pas d'une préférence esthétique. Les décisions thérapeutiques dans le NSCLC comportent une toxicité réelle, un coût réel et une irréversibilité réelle, et une recommandation qui ne peut être interrogée est difficile à suivre de manière responsable. Lorsqu'un outil signale un patient comme candidat à une voie thérapeutique plutôt qu'à une autre, l'équipe soignante doit savoir quelles caractéristiques ont pesé sur l'évaluation et avec quelle force.
Le cadrage de l'article traite l'explicabilité et l'utilisabilité comme des problèmes liés plutôt que séquentiels. Parmi les considérations que ce couplage soulève :
- Savoir si les explications sont exprimées dans les termes que les cliniciens utilisent déjà, plutôt qu'en pondérations de caractéristiques abstraites.
- Savoir si l'outil clarifie une décision que le clinicien pesait déjà, ou introduit un jugement concurrent qui doit être arbitré.
- Savoir si les explications restent stables chez des patients qui se ressemblent sur le papier, afin que la confiance ne repose pas sur une coïncidence.
- Savoir si l'interface s'adapte au rythme d'une véritable réunion de concertation pluridisciplinaire, où le temps par dossier se mesure en minutes.
Chacune de ces questions est autant une question d'utilisabilité qu'une question d'apprentissage automatique, et chacune relève de ce qu'un benchmark de précision purement rétrospectif ne peut pas trancher.
Pourquoi « vaste, international, en conditions réelles » compte
L'étude est décrite comme une vaste investigation internationale en conditions réelles. Ces trois adjectifs accomplissent ensemble beaucoup de travail. Des données multicentriques et multi-pays réduisent le risque qu'un modèle ait simplement appris les habitudes d'équipement, les conventions de codage ou les schémas d'orientation d'un seul hôpital. Les données en conditions réelles, par opposition à des cohortes d'essais étroitement sélectionnées, reflètent le mélange plus désordonné de patients que les cliniciens voient réellement — y compris ceux qui n'auraient jamais satisfait à des critères d'éligibilité stricts dans une étude prospective.
La contrepartie est que les jeux de données en conditions réelles sont plus bruités, et le chemin des dossiers bruts aux entrées prêtes pour le modèle est rarement propre. La manière dont une équipe gère cette traduction façonne ce que la performance rapportée signifie finalement. Un vaste échantillon international rend les conclusions plus transposables en principe, mais la transposabilité doit encore être démontrée plutôt que supposée.

Là où les outils d'IA calent habituellement
Les tests d'utilisabilité clinique abordent l'écart entre un modèle qui fonctionne et un modèle qui est utilisé. Les modes de défaillance récurrents sont bien documentés dans l'IA clinique : alertes qui se déclenchent si souvent qu'elles sont ignorées, tableaux de bord qui dupliquent des informations déjà à l'écran, et résultats qui arrivent après que la décision a effectivement été prise. Un outil d'aide à la décision doit gagner sa place dans un flux de travail déjà encombré.
En nommant directement l'utilisabilité clinique dans le titre, l'étude signale que les auteurs ont mesuré quelque chose au-delà de la discrimination et de la calibration. Le travail sur l'utilisabilité demande généralement si les cliniciens peuvent interpréter la sortie de l'outil, s'ils sont d'accord avec elle, si elle modifie leur plan déclaré et si elle les ralentit. Ces mesures sont plus difficiles à résumer en un chiffre de gros titre, ce qui explique en partie qu'elles soient fréquemment omises.
Questions que l'article laisse ouvertes
Plusieurs éléments échappent à ce qu'une seule étude de cette forme peut trancher. La performance mesurée par rapport à des résultats rétrospectifs n'est pas la même chose qu'une amélioration des résultats pour les patients, et démontrer cette dernière exige une évaluation prospective. La qualité des explications est également difficile à quantifier — un modèle peut produire une explication sans que celle-ci soit fidèle au calcul qui a produit la prédiction. Et l'adoption dépend de facteurs institutionnels, de l'intégration au dossier électronique à la question de savoir qui porte la responsabilité lorsqu'une recommandation est suivie et que le résultat est mauvais.
Se pose aussi la question du comportement d'un tel outil à mesure que les pratiques évoluent. Les paradigmes thérapeutiques du NSCLC changent rapidement à mesure qu'émergent de nouveaux agents et des sous-groupes définis par biomarqueurs. Un modèle entraîné sur les décisions d'une époque peut encoder des schémas que les cliniciens ont depuis abandonnés.

Pourquoi cela tombe à point nommé
Le cancer du poumon reste l'un des domaines les plus déterminants pour l'aide à la décision, car le nombre de voies thérapeutiques plausibles a crû plus vite que le temps disponible pour raisonner chaque cas. Les modèles multimodaux promettent de compresser ce raisonnement ; l'explicabilité et l'utilisabilité déterminent si cette compression est digne de confiance. Publier cette combinaison d'évaluation de modèle et d'évaluation de l'utilisabilité clinique dans une tribune de premier plan pose un jalon : on demande de plus en plus au domaine de montrer non seulement qu'un modèle prédit bien, mais qu'un clinicien peut travailler avec lui. Le prochain test sera de savoir si des outils de ce type tiennent la route lorsqu'ils sont déployés de manière prospective, dans les cliniques qui les utiliseraient.
Cet article s'appuie sur un reportage de Nature Medicine. Lire l'article original.
Originally published on nature.com


