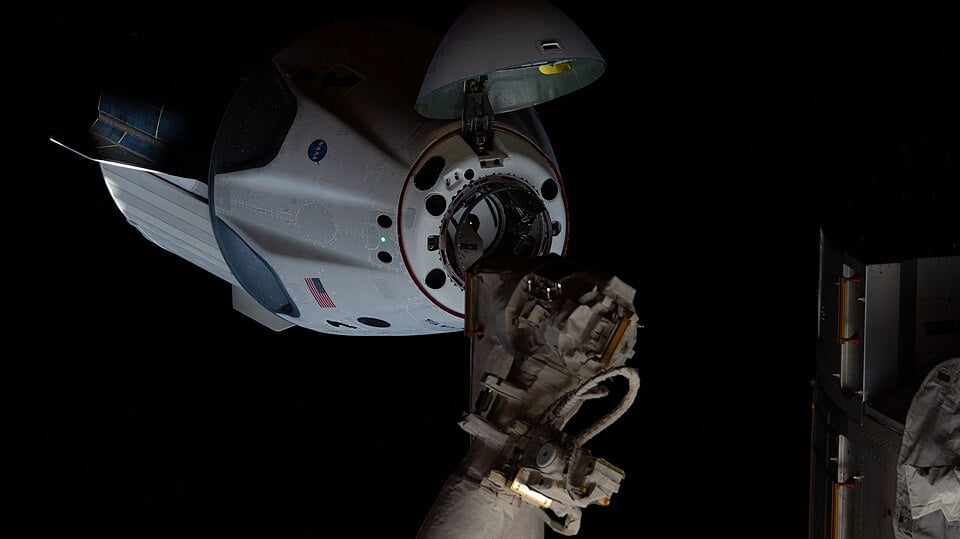
太陽系で最も難しい駐車作業
宇宙機を国際宇宙ステーション(ISS)にドッキングさせる様子は、アニメーションで見るとゆっくりと優雅なバレエのように見える。現実は、はるかに危険度の高い物理学的悪夢に近い。ステーションは時速約28,000キロメートルで軌道を回っており、接近するカプセルはその速度に合わせつつ、センチメートル単位の許容誤差でドッキングポートに滑り込まなければならない。Universe Todayの寄稿者Andy Tomaswickが表現したように、これは時速28,000kmで高速道路を走りながら、同じ速度で動く数十億ドル規模の実験室の開いたガレージに縦列駐車するようなものだ。
軌道力学は、地球上のドライバーが決して直面しない残酷なひねりを加える。パイロットが前方に加速しようとすると、宇宙機は実際には上方に流れてしまう。自然に機体を減速させる空気抵抗は存在しない。そして失敗の結果は破滅的だ。衝突は訪問機とステーションの両方に乗る全員を殺しかねず、その結果生じるデブリ帯は数十機の衛星や、さらには地上の人々をも脅かす可能性がある。
数十年にわたり、航空宇宙技術者はハードコードされた物理方程式と、それを修正する人間のパイロットに頼ってきた。今、スタンフォード大学の研究者たちによる新しいプレプリント論文がarXivで公開され、異なるアプローチを提案している。チームは一連の「メンタルシミュレーション」を行うAIを構築しており、この能力は将来の宇宙機同士の相互作用のあり方を根本から変える可能性があるという。そのシステムはOut-of-this-World Model、略してOWMと呼ばれている。
現在の宇宙機はどうドッキングするのか — そしてどこで破綻するのか
OWMがなぜ重要かを理解するには、低軌道(LEO)での航行における従来のツールキットを知っておくと役立つ。従来の航法コンピュータは、誘導・航法・制御(GNC)アルゴリズムを実行する。また、Extended Kalman Filterと呼ばれる数学的ツールも使用しており、これはGPS受信機やスタートラッカーからのデータを取り込み、機体を操舵するために必要なスラスタ噴射のデューティサイクルを出力する。
カルマンフィルタと映像問題
カルマンフィルタは強力だが、高速映像の処理は極めて苦手である。この制約が技術者を従来のコンピュータビジョン技術へと向かわせる。しかし宇宙では、これらの技術は深刻な障害に直面する。つまり、もろいのだ。太陽光が太陽電池アレイに反射したり、対象の一部が突然影に覆われたりすると、コンピュータビジョンのアルゴリズムは完全に混乱しうる。一瞬前にははっきり見えていたドッキングポートが、次の瞬間には認識不能な形状になりうる。
強化学習がつまずく理由
機械学習は完璧な解決策のように聞こえ、研究者たちも試してきた。彼らは強化学習(RL)アルゴリズム — コンピュータにチェスやDotaで勝つ方法を教えたことで有名な手法群 — を適用し始めた。しかしRLには狭い快適領域がある。ルールが固定され具体的である場合には優れている。ルールを変えると、たとえばISSのどちら側にドッキングポートがあるかを反転させると、アルゴリズムは何をすべきか分からなくなる。ある構成では完璧に機能したドッキング操作が、別の構成では完全に失敗しうる。

Out-of-this-World Modelの登場
スタンフォードのチームの答えは「ワールドモデル」である。単一のルールセットを暗記したり、もろい特徴検出に頼ったりするのではなく、ワールドモデルは環境の内部表現を構築し、それを使ってメンタルシミュレーションを実行する。宇宙機は事実上、起こりうる未来について夢を見ることができる。つまり、スラスタが軌道をどう変えるか、ステーションが回転するにつれてどう見えるか、照明条件がどう変化しうるかを、噴射を確定する前に想像できるのだ。
これは古典的GNCと純粋なRLの両方からの意義ある脱却である。古典的アルゴリズムは、各ミッションに合わせて調整しなければならない手作り方程式に依存している。RLエージェントは狭い領域での広範な訓練に依存している。ワールドモデルは一般化を目指す。世界がどのように機能するかについての予測モデルを学習することで、異なるドッキングポートの向きや予期しない影など、シナリオが変化したときにも適応できる。
野球のアナロジー:方程式なしで考える
研究者たちは、ロケットとは何の関係もないアナロジーでこの概念を説明する。野球やクリケットの選手がフライボールを捕ることだ。外野手が捕球のために動くとき、彼らはすぐに偏微分方程式を解き始めるわけではない。代わりに、ボールがどう飛ぶかについての直感的で予測的なモデル — 経験から構築されたメンタルシミュレーション — に頼っている。紙の上で軌道を計算することなく、走り、調整し、ボールを迎え撃つ。
ワールドモデルは宇宙機に似たようなものを与える。各段階で軌道運動の方程式を明示的に解く代わりに、AIは結果を内部的にシミュレートできる。ドッキング接近を「夢見る」ように通り抜け、仮説上の行動を、学習した物理と知覚のモデルに対して試すことができる。メンタルシミュレーションが衝突や位置ずれを予測すれば、実際の世界で操作が失敗する前にシステムは調整できる。
これが将来の宇宙機にとって意味しうること
その含意はISSとのドッキングにとどまらない。より多くの宇宙機が自律的に運用されるにつれて — 衛星のサービス、軌道上での構造物の組み立て、混雑した軌道レーンでの交通の航行など — 新しい状況について推論する能力が不可欠になる。ハードコードされた方程式やもろいコンピュータビジョンは、機体が協力し、デブリを回避し、技術者が完全には予期しなかった条件に適応しなければならない未来には拡張できないかもしれない。
スタンフォードの論文はプレプリントであり、まだ査読を受けていない。また元のテキストはOWMのアーキテクチャ、訓練データ、性能ベンチマークについて詳述していない。しかし中核となる考えは説得力がある。宇宙機に自分たちの世界のメンタルモデルを構築することを教え、スラスタを噴射する前に頭の中で練習させるのだ。もしうまくいけば、ドッキングは白 knuckle な縦列駐車作業というよりも、もっと日常的なものになるかもしれない。宇宙機が接近の失敗しうる千通りの方法をすでに想像し、その中を通る道を見つけているようなものだ。
今のところ、問題は相変わらず手ごわいままだ。時速28,000kmで速度を合わせ、軌道ドリフトを補正し、破滅的な衝突を避けることは、一夜にして消える課題ではない。しかしスタンフォードの研究者たちは、次世代の宇宙機は計算だけでステーションへ向かうのではないと賭けている。彼らは夢見ながらそこへたどり着くのだ。
この記事はUniverse Todayの報道に基づいています。元記事を読む。
Originally published on universetoday.com