2つの異なる問いを軸に組み立てられた研究
Nature Medicineは2026年9月13日、論文「Clinical usability of an explainable AI decision support tool and evaluation of multimodal models in NSCLC」をオンラインで公開した。この表現自体が、中身のどの結果にも劣らず重要である。著者らは同時に2つのことを成し遂げようとした。マルチモーダルモデルが非小細胞肺がんをどの程度うまく扱えるかをベンチマークし、その種のモデルを基盤とする意思決定支援ツールが、それに依存することになる臨床医にとって本当に使えるものかを検証することだ。
この二重の枠組みが、単一の性能値を報告して終わる論文の絶え間ない流れとは、この研究を明確に区別している。モデルはホールドアウトされたテストセットで印象的なスコアを出しても、診療現場では期待を裏切ることがある。出力がワークフローの中で遅すぎる段階で届いたり、インターフェースがなぜその推奨が現れたのかを隠していたり、説明が腫瘍内科医ではなくエンジニア向けに書かれていたりすればなおさらだ。論文に添えられた要約によれば、マルチモーダルな説明可能モデルが著者らの評価で優位に立った。臨床での使いやすさへの明示的な関心は、チームがその結果を終着点ではなく出発点として扱ったことを示唆している。
この文脈における「マルチモーダル」の意味
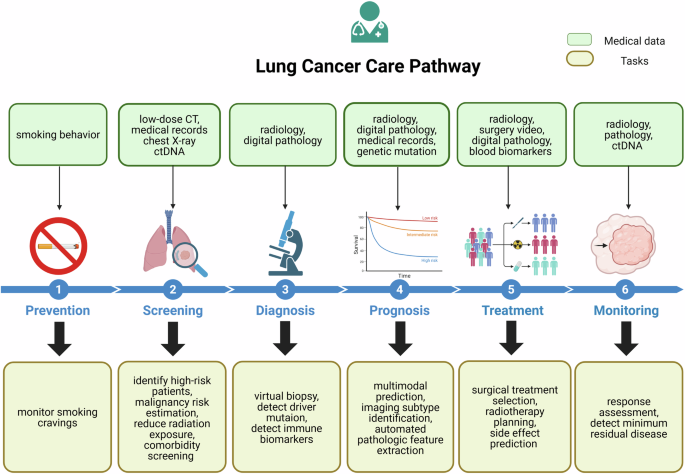
マルチモーダルモデルは、単一の画像や単一の検査パネルを物語のすべてとして扱うのではなく、複数の種類の入力を同時に取り込む。非小細胞肺がんで関連する入力は、際立って多様である。画像検査は腫瘍の大きさ、位置、広がりを捉える。病理スライドは、がん細胞がどのように見えるか、どの程度攻撃的に見えるかについての組織レベルの詳細を担う。診療記録は、performance status、喫煙歴、過去の治療、併存疾患を保持する。分子検査は、患者にどの治療を提供するかをますます左右するドライバー変異を加える。
長年にわたり、これらの流れは別々のシステムに存在し、臨床医の頭の中で統合されてきた。マルチモーダルモデルは、その組み合わせが単一の情報源にはない情報を運ぶという前提のもと、それらを統合しようとする。難しいのは、各流れがそれぞれ独自の欠損パターン、独自の単位、独自の信頼性を持つことだ。モデルがそれらすべてを一度に用いると、どの入力が特定の出力を駆動したのかという問いに答えるのが難しくなる。まさにそこに説明可能性が入り込む。

おまけではなく臨床要件としての説明可能性
説明可能なモデルとは、その推論を何らかの解釈可能な形で人間に提示できるモデルである。腫瘍学においてこれは美的な好みではない。NSCLCの治療決定は、実際の毒性、実際の費用、実際の不可逆性を伴い、問いただすことのできない推奨に責任をもって従うのは難しい。ツールがある患者を別の経路よりも特定の経路の候補として示したとき、治療チームはどの特徴量がその評価を押し上げ、どの程度強く押したのかを知る必要がある。
本論文の枠組みは、説明可能性と使いやすさを連続する問題ではなく結びついた問題として扱っている。この組み合わせが提起する検討事項には次のようなものがある。
- 説明が抽象的な特徴量の重みではなく、臨床医がすでに使っている言葉で表現されているかどうか。
- ツールが、臨床医がすでに天秤にかけていた決定を明確にするのか、それとも裁定を要する競合する判断を持ち込むのか。
- 書類上は似て見える患者間で説明が安定しているかどうか。そうでなければ、信頼が偶然の上に築かれてしまう。
- インターフェースが実際の腫瘍ボードのペースに合っているかどうか。そこでは1症例あたりの時間は分単位で測られる。
これらはいずれも機械学習の問題であると同時に使いやすさの問題であり、純粋に後ろ向きの精度ベンチマークでは答えられない種類のものである。
「大規模・国際・実臨床」が重要な理由
この研究は、大規模な国際実臨床調査として記述されている。これら3つの形容詞は、一緒になると大きな役割を果たす。多施設・多国のデータは、モデルが単に1つの病院の機器、コーディング慣行、紹介パターンの癖を学習しただけであるリスクを減らす。厳密に選別された試験コホートとは対照的に、実臨床データは、臨床医が実際に目にする、より雑多な患者の混合を反映する。前向き研究では厳格な適格基準を決して満たさなかったであろう患者も含まれる。
トレードオフは、実臨床データセットがよりノイズが多く、生の記録からモデルに投入可能な入力への道筋がめったにきれいではないことだ。チームがその変換をどう扱うかが、報告された性能が最終的に何を意味するかを形作る。大規模な国際サンプルは、原理上は知見の移植性を高めるが、移植性はなお前提とされるのではなく実証されなければならない。

AIツールが通常つまずくところ
臨床での使いやすさの検証は、機能するモデルと実際に使われるモデルの間のギャップに対処する。繰り返し現れる失敗の様式は、臨床AI全体でよく記録されている。あまりに頻繁に発火するために無視されるアラート、すでに画面にある情報を重複させるダッシュボード、決定が事実上なされた後に届く出力などである。意思決定支援ツールは、すでに混雑したワークフローの中で自らの居場所を勝ち取らなければならない。
タイトルで臨床での使いやすさを直接掲げることで、この研究は著者らが識別能や較正を超えた何かを測定したことを示している。使いやすさの検証は通常、臨床医がツールの出力を解釈できるか、それに同意するか、それが表明された計画を変えるか、そして作業を遅らせるかどうかを問う。これらの指標は見出しの数字にまとめるのが難しく、それがしばしば省略される理由の一部である。
本論文が未解決のまま残す問い
この形の単一研究では決着をつけられない事柄がいくつかある。後ろ向きの転帰に対して測定された性能は、患者転帰の改善と同じではない。後者を示すには前向き評価が必要である。説明の質も定量化が難しい。モデルは説明を生成できても、その説明が予測を生み出した計算に対して忠実であるとは限らない。そして導入は、電子記録の統合から、推奨に従った結果が不良だったときに誰が責任を負うかに至るまで、制度上の要因に依存する。
診療が変化するにつれてそのようなツールがどう振る舞うかという問いもある。NSCLCの治療パラダイムは、新しい薬剤やバイオマーカーで定義されるサブグループが現れるにつれて急速に移り変わる。ある時代の決定で訓練されたモデルは、臨床医がその後放棄したパターンを符号化している可能性がある。
なぜこれが今、意味を持つのか
肺がんは、意思決定支援にとって最も重要な領域の一つであり続けている。もっともらしい治療経路の数が、各症例を熟考するために使える時間の量よりも速く増えてきたからだ。マルチモーダルモデルはその推論を圧縮することを約束する。説明可能性と使いやすさが、その圧縮が信頼に値するかどうかを決める。モデル評価と臨床での使いやすさの評価というこの組み合わせを注目度の高い場で発表することは、一つの目印を打ち立てる。すなわち、この分野はモデルがよく予測することだけでなく、臨床医がそれを扱えることを示すよう、ますます求められている。次の試練は、この種のツールが、それを使うであろう診療現場で前向きに導入されたときに持ちこたえられるかどうかである。
本記事はNature Medicineの報道に基づく。原著論文を読む。
Originally published on nature.com


