क्लिनिकल पूर्वानुमान मॉडलों के लिए प्रकाशित परिणाम से अधिक की आवश्यकता है
नैदानिक और पूर्वानुमान संबंधी निर्णयों में सहायता के लिए क्लिनिकल पूर्वानुमान मॉडलों का इस्तेमाल बढ़ रहा है। उनकी रिपोर्ट की गई सटीकता इस बात को प्रभावित कर सकती है कि चिकित्सक जोखिम का अनुमान कैसे लगाते हैं, जांचों को प्राथमिकता कैसे देते हैं या मरीजों के साथ संभावित परिणामों पर चर्चा कैसे करते हैं। लेकिन Nature Medicine में प्रकाशित एक नए विश्लेषण के अनुसार, ऐसे मॉडलों के मूल्यांकन के लिए एक बुनियादी शर्त अब भी आम नहीं है: उनके पीछे मौजूद विश्लेषणात्मक कोड तक पहुंच।
अध्ययन में उन मुक्त-प्रवेश शोध आलेखों की समीक्षा की गई, जिनमें TRIPOD या TRIPOD+AI रिपोर्टिंग फ्रेमवर्क का उल्लेख था। ये फ्रेमवर्क पूर्वानुमान-मॉडल अध्ययनों की पारदर्शी रिपोर्टिंग से संबंधित हैं। शोधकर्ताओं ने साहित्य की जांच करने, रिपॉजिटरी लिंक की पहचान करने और 14 पूर्वनिर्धारित पुनरुत्पादकता-संबंधी विशेषताओं का इस्तेमाल करके उपलब्ध रिपॉजिटरी का मूल्यांकन करने के लिए बड़े भाषा मॉडल की सहायता वाली प्रक्रिया का उपयोग किया।
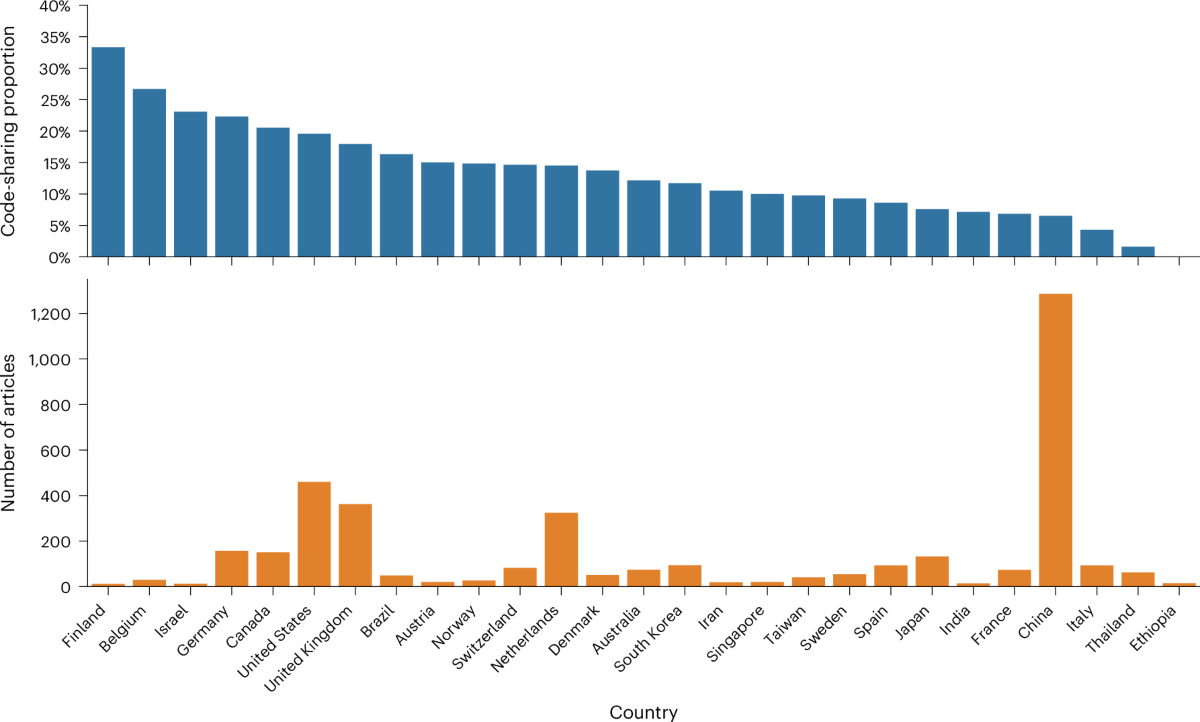
जांचे गए 3,967 आलेखों में से 482 में यह बयान शामिल था कि कोड साझा किया गया है। यह नमूने का 12.2% है। इस निष्कर्ष से यह सिद्ध नहीं होता कि बाकी सभी अध्ययनों में सुलभ कोड नहीं था, लेकिन यह अवश्य दिखाता है कि समीक्षा किए गए साहित्य में कोड साझा करने संबंधी स्पष्ट बयान अब भी अपवाद थे।
उपलब्धता और पुनरुत्पादकता एक ही बात नहीं हैं
शोधकर्ताओं का केंद्रीय तर्क है कि केवल रिपॉजिटरी लिंक उपलब्ध होने से किसी विश्लेषण की जांच या उसका पुनः उपयोग आसान नहीं हो जाता। उन्होंने जिन रिपॉजिटरी का मूल्यांकन किया, उनमें पुनरुत्पादकता-संबंधी विशेषताओं में काफी भिन्नता पाई। व्यवहार में, किसी अन्य शोधकर्ता को यह समझने के लिए केवल स्रोत फाइलों से अधिक की आवश्यकता हो सकती है कि किसी मॉडल को दोबारा बनाया जा सकता है या नहीं: दस्तावेजीकरण, सॉफ्टवेयर निर्भरताओं की जानकारी और निष्पादन योग्य परियोजना संरचना—सभी महत्वपूर्ण हो सकते हैं।
क्लिनिकल पूर्वानुमान कार्य के लिए यह अंतर विशेष रूप से महत्वपूर्ण है। कोई मॉडल किसी विशिष्ट समूह, प्रीप्रोसेसिंग प्रक्रिया और परिणामों की परिभाषाओं के आधार पर विकसित किया जा सकता है। यदि विश्लेषणात्मक चरणों का स्वतंत्र रूप से निरीक्षण नहीं किया जा सकता, तो बाहरी शोधकर्ताओं के लिए यह आकलन करना कठिन हो जाता है कि प्रक्रिया में किए गए विकल्पों ने रिपोर्ट किए गए प्रदर्शन को कैसे प्रभावित किया, या इस कार्य को किसी अलग परिस्थिति में अपनाकर परखा जा सकता है या नहीं।
समीक्षा में यह भी पाया गया कि कोड साझा करने की दर जर्नल और देश के अनुसार काफी अलग थी। उपलब्ध अध्ययन-पाठ में यह नहीं बताया गया है कि कौन से जर्नल या देश आगे या पीछे थे, लेकिन यह भिन्नता संकेत देती है कि शोधकर्ता अपने कार्य को उपलब्ध कराते हैं या नहीं, इस पर मानदंड और संपादकीय अपेक्षाएं प्रभाव डाल रही हैं।

शोध-पद्धति की AI-सहायित समीक्षा
लेखकों ने बड़े भाषा मॉडल की सहायता वाली प्रक्रिया का उपयोग पद्धतिगत भूमिका में किया: संबंधित आलेखों की जांच, रिपॉजिटरी लिंक निकालने और पूर्वनिर्धारित विशेषताओं के आधार पर रिपॉजिटरी का मूल्यांकन करने में सहायता के लिए। इस दृष्टिकोण से टीम हजारों शोधपत्रों की जांच कर सकी, जबकि मूल माप ठोस रिपोर्टिंग और रिपॉजिटरी की विशेषताओं पर केंद्रित रहा।
इसका उपयोग शोध-शासन की एक व्यापक चुनौती को भी दर्शाता है। जैसे-जैसे प्रकाशनों की संख्या बढ़ रही है, पारदर्शिता संबंधी प्रक्रियाओं का मैनुअल ऑडिट बड़े पैमाने पर करना कठिन होता जा रहा है। सुव्यवस्थित और सावधानीपूर्वक डिजाइन की गई स्वचालित प्रक्रियाएं इन तरीकों का मानचित्रण करने में मदद कर सकती हैं, बशर्ते उनके परिणामों का मूल्यांकन स्पष्ट रूप से परिभाषित मानदंडों के आधार पर किया जाए। इस मामले में मानदंड कोड की उपलब्धता और पुनरुत्पादकता से संबंधित विशेषताओं पर आधारित थे, न कि किसी व्यक्तिगत मॉडल की वैज्ञानिक गुणवत्ता के बारे में स्वचालित निर्णय पर।
तैनाती के लिए यह अंतर क्यों महत्वपूर्ण है
क्लिनिकल मॉडलों का उद्देश्य वास्तविक दुनिया के निर्णयों में सहायता करना है, इसलिए उनकी विश्वसनीयता और सामान्यीकरण क्षमता की बारीकी से जांच आवश्यक है। प्रकाशित शोधपत्र में प्रभावी दिखने वाला मॉडल कहीं और लागू किए जाने पर अलग प्रदर्शन कर सकता है, क्योंकि वहां मरीजों की आबादी, डेटा संग्रह और क्लिनिकल कार्यप्रवाह भिन्न हो सकते हैं। विश्लेषणात्मक प्रक्रिया का स्वतंत्र मूल्यांकन इन दावों की बुनियाद की जांच करने का एक तरीका है।
खुला कोड पुनरुत्पादकता की हर समस्या का समाधान नहीं कर सकता। निजता और कानूनी कारणों से मरीजों का डेटा प्रतिबंधित हो सकता है, और मूल डेटा तक पहुंच के बिना बाहरी उपयोगकर्ता किसी विश्लेषण को हूबहू दोहरा नहीं सकते। फिर भी, स्पष्ट विश्लेषणात्मक कोड, निर्भरताओं का विवरण और उपयोग योग्य दस्तावेजीकरण कार्य को अधिक निरीक्षण योग्य बना सकते हैं तथा शोधकर्ताओं को यह समझने में मदद कर सकते हैं कि किसी अन्य डेटासेट के साथ जिम्मेदारी से परीक्षण करने के लिए क्या आवश्यक होगा।
लेखक इन परिणामों को इस बात के प्रमाण के रूप में प्रस्तुत करते हैं कि कोड मौजूद होने की साधारण घोषणा से आगे अधिक स्पष्ट अपेक्षाओं की आवश्यकता है। उनका कहना है कि दस्तावेजीकरण, निर्भरताओं का विनिर्देशन और निष्पादन योग्य संरचना बेहतर प्रक्रियाओं का हिस्सा होने चाहिए। ये तत्व पाठकों और किसी अध्ययन को दोहराने या आगे बढ़ाने का प्रयास करने वाली टीमों के लिए अस्पष्टता कम कर सकते हैं।

TRIPOD-Code अगला नीतिगत लक्ष्य है
यह समीक्षा TRIPOD-Code को सूचित करने के लिए की गई थी, जो कोड की उपलब्धता और पुनरुत्पादकता पर केंद्रित एक रिपोर्टिंग दिशानिर्देश है। रिपोर्टिंग दिशानिर्देश अपने आप यह सुनिश्चित नहीं करते कि शोधकर्ता पूर्ण और उपयोग योग्य परियोजनाएं जारी करेंगे। हालांकि, वे लेखकों, समीक्षकों और जर्नलों के लिए अपेक्षाओं को स्पष्ट कर सकते हैं और यह पहचानने के लिए साझा शब्दावली बना सकते हैं कि क्या उपलब्ध कराया गया है।
परिणाम एक ठोस मानक प्रस्तुत करता है: इस साहित्यिक नमूने में केवल लगभग आठ में से एक शोधपत्र में कोड साझा करने संबंधी बयान शामिल था। ऐसे क्षेत्र में, जहां मॉडल क्लिनिकल उपयोग की ओर बढ़ रहे हैं, लेखकों का तर्क है कि साझा विश्लेषणात्मक कार्य की गुणवत्ता और स्पष्टता में सुधार से शोध अधिक उपयोगी बन सकता है और व्यवहार में सुरक्षित रूपांतरण में सहायता मिल सकती है।
इसलिए अध्ययन का ध्यान इस बात से हटता है कि कोई शोधपत्र केवल कोड का उल्लेख करता है या नहीं, और इस पर केंद्रित होता है कि क्या कोई स्वतंत्र पाठक विश्लेषणात्मक कार्यप्रवाह को समझकर चला सकता है। यह एक ऊंचा मानक है, लेकिन क्लिनिकल पूर्वानुमान मॉडलों पर देखभाल संबंधी परिस्थितियों में भरोसा करने से पहले उनके मूल्यांकन के लिए आवश्यक साक्ष्य के अधिक अनुरूप है।
यह लेख Nature Medicine की रिपोर्टिंग पर आधारित है। मूल लेख पढ़ें।
Originally published on nature.com