Un problema de clasificación en el corazón de la genética del autismo
Durante las últimas dos décadas, los genetistas han reunido un catálogo largo y aún creciente de genes vinculados al trastorno del espectro autista. Ese catálogo ha sido enormemente productivo, pero también ha expuesto una brecha incómoda: saber qué genes conllevan riesgo no explica automáticamente cómo esos genes producen resultados tan variados. Dos individuos pueden portar mutaciones en el mismo gen y presentar perfiles sorprendentemente diferentes, mientras que mutaciones en genes completamente distintos pueden converger en rasgos similares.
Un artículo publicado en Science — Volumen 393, Número 6817, páginas 1250–1257, fechado en septiembre de 2026 — apunta a esa brecha con un título que enuncia su método con claridad: "Transcriptome-based classification in mice with ASD-risk mutations". El enfoque señala un cambio de énfasis. En lugar de clasificar a los animales modelo únicamente por la mutación que portan, el trabajo examina el transcriptoma — el conjunto completo de transcritos de ARN que se producen en una célula o tejido — como base para agruparlos y clasificarlos.
Por qué importa el transcriptoma
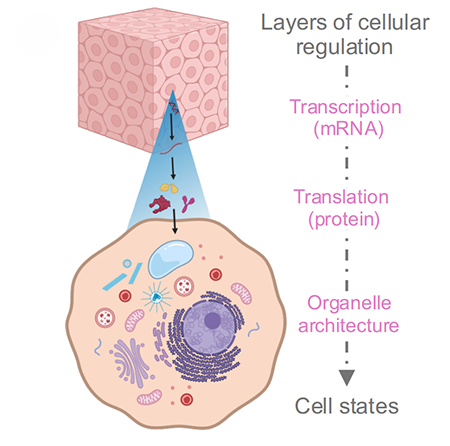
El ADN suele describirse como un plano, pero un plano que nunca se lee no produce nada. El transcriptoma es la lectura: captura qué genes se están transcribiendo activamente, y a qué niveles, en un momento dado en un tejido dado. Debido a que se sitúa aguas abajo tanto de la variación genética como de la influencia ambiental, ofrece una visión más dinámica del estado biológico que un genotipo por sí solo.
Esa cualidad hace que la clasificación basada en el transcriptoma sea conceptualmente atractiva para las condiciones del neurodesarrollo. Si las mutaciones en diferentes genes de riesgo de TEA perturban en última instancia conjuntos superpuestos de vías biológicas, entonces los perfiles de expresión podrían revelar agrupaciones que los datos de secuenciación ocultan. Los ratones portadores de distintas mutaciones de riesgo podrían, en principio, agruparse no porque compartan un gen, sino porque comparten una consecuencia molecular.
Del genotipo a la firma molecular
La lógica es aproximadamente la siguiente. Tómese un conjunto de líneas de ratones, cada una diseñada para portar una mutación asociada al riesgo de autismo. Perfílense la expresión génica en el tejido relevante — típicamente regiones cerebrales implicadas en el comportamiento social, la comunicación y los patrones repetitivos de comportamiento. Luego pregúntese si las firmas de expresión resultantes clasifican a los animales en grupos significativos, y si esos grupos se alinean con algo observable sobre los propios animales.
Si tal alineación existe, daría a los investigadores un asidero molecular para estratificar modelos que de otro modo parecen una colección indiferenciada de mutaciones. También plantearía la posibilidad de que algunas intervenciones pudieran adaptarse mejor a los perfiles moleculares que a nombres de genes específicos.

Por qué los modelos de ratón siguen siendo centrales
Los estudios humanos de genética del autismo enfrentan duras limitaciones. El tejido cerebral rara vez está disponible para el perfilado molecular, los tamaños de muestra para mutaciones raras son pequeños, y la influencia del entorno, el momento del diagnóstico y las condiciones concurrentes son difíciles de desentrañar. Los modelos de ratón no resuelven estos problemas, pero permiten experimentos controlados que serían imposibles en personas.
Las líneas de ratón modificadas genéticamente permiten a los investigadores introducir una mutación definida sobre un fondo genético en gran medida uniforme, criar animales en condiciones estandarizadas y perfilar tejidos en etapas precisas del desarrollo. La contrapartida se comprende bien: los ratones no son humanos pequeños, y rasgos humanos complejos como la comunicación social no se corresponden limpiamente con el comportamiento de los roedores. Cualquier esquema de clasificación construido en ratones es, por lo tanto, una herramienta generadora de hipótesis, no diagnóstica.
El problema de la heterogeneidad
El trastorno del espectro autista se define por criterios conductuales, y la palabra "espectro" hace un trabajo real. La misma etiqueta abarca a individuos con necesidades de apoyo profundas e individuos que viven de forma independiente, con una amplia gama de perfiles cognitivos, sensoriales y lingüísticos en el medio. Genéticamente, la condición es igualmente desordenada, involucrando mutaciones raras de alto impacto, variantes comunes de efecto pequeño y combinaciones de ambas.
Esta heterogeneidad es el obstáculo central para traducir los hallazgos genéticos en beneficio clínico. Un tratamiento que ayuda a un subgrupo biológico puede no hacer nada por otro, y promediar los resultados en un grupo indiviso puede ocultar un efecto real. La clasificación — por genética, por comportamiento, por biomarcadores o por transcriptoma — es la estrategia que los investigadores han adoptado para confrontar ese problema.
El subtipado como estrategia de investigación
La clasificación basada en el transcriptoma pertenece a un movimiento más amplio hacia el subtipado molecular en psiquiatría y neurociencia. El atractivo es directo: los datos de expresión son cuantitativos, a nivel de tejido y relativamente imparciales, en el sentido de que no dependen de que un investigador decida de antemano qué vía importa. El riesgo es igualmente directo. Las firmas transcriptómicas pueden ser ruidosas, sensibles a la edad, el sexo, el tejido y el manejo, y propensas al sobreajuste cuando los tamaños de muestra son modestos.

Leer el nuevo artículo en contexto
El estudio aparece en una de las revistas de ciencia general más leídas, lo que establece expectativas de rigor y alcance. Sus páginas en Science — 1250 a 1257 en el Volumen 393, Número 6817 — lo sitúan dentro de la cobertura de ciencias de la vida de septiembre de 2026 de la revista. Los lectores que se acerquen al trabajo deberían buscar varias cosas: cuántas líneas de ratón y mutaciones se perfilaron, qué regiones cerebrales o tejidos se muestrearon, cómo se definieron y validaron las firmas de expresión, y si las clases resultantes corresponden a alguna medida conductual o fisiológica.
También deberían buscar convergencia. Si la clasificación saca a la superficie vías ya implicadas en la biología del autismo — función sináptica, síntesis de proteínas, regulación de la cromatina, señalización inmunitaria — eso reforzaría la confianza en que las agrupaciones reflejan algo real y no un artefacto del proceso de análisis. La divergencia también sería interesante, pero exigiría más evidencia.
Qué observar a continuación
Los esquemas de clasificación se ganan su lugar solo si resultan útiles. Las pruebas útiles son prácticas: ¿predicen las clases cómo responde una línea de ratón a una intervención dada? ¿Se replican en cohortes independientes y en otros laboratorios? ¿Se corresponden con datos humanos, ya sea de tejido post mortem, modelos de células madre pluripotentes inducidas o estudios de cohortes humanas cada vez más ricos?
Ninguna de esas preguntas queda resuelta por un solo artículo. Lo que un estudio de este tipo puede hacer es demostrar que el enfoque es viable y vale la pena perseguirlo — que el transcriptoma contiene suficiente estructura para organizar una colección genéticamente desordenada de animales modelo en grupos coherentes. Si esa estructura se traduce en mejores experimentos y, eventualmente, en un apoyo mejor dirigido para las personas autistas es un proyecto más largo, y uno que requerirá la misma convergencia entre genética, perfilado molecular y observación clínica que el campo ha estado persiguiendo durante años.

Puntos clave
- El artículo de Science, publicado en el Volumen 393, Número 6817 (páginas 1250–1257, septiembre de 2026), se titula "Transcriptome-based classification in mice with ASD-risk mutations".
- El enfoque clasifica los modelos de ratón por sus perfiles de expresión génica en lugar de por la mutación de riesgo específica que portan.
- El transcriptoma se sitúa aguas abajo tanto de la variación genética como de la influencia ambiental, lo que lo convierte en un candidato para capturar el estado biológico.
- Los modelos de ratón permiten un perfilado controlado y específico de cada etapa que es en gran medida imposible en la investigación del cerebro humano, pero generan hipótesis en lugar de ser directamente clínicos.
- El valor de cualquier esquema de clasificación dependerá de la reproducibilidad, el poder predictivo y la eventual alineación con datos humanos.
Este artículo se basa en reportajes de Science (AAAS). Lea el artículo original.
Originally published on science.org