Ein Porträt der Gesundheit im Vereinigten Königreich auf Basis von 1,9 Millionen Menschen
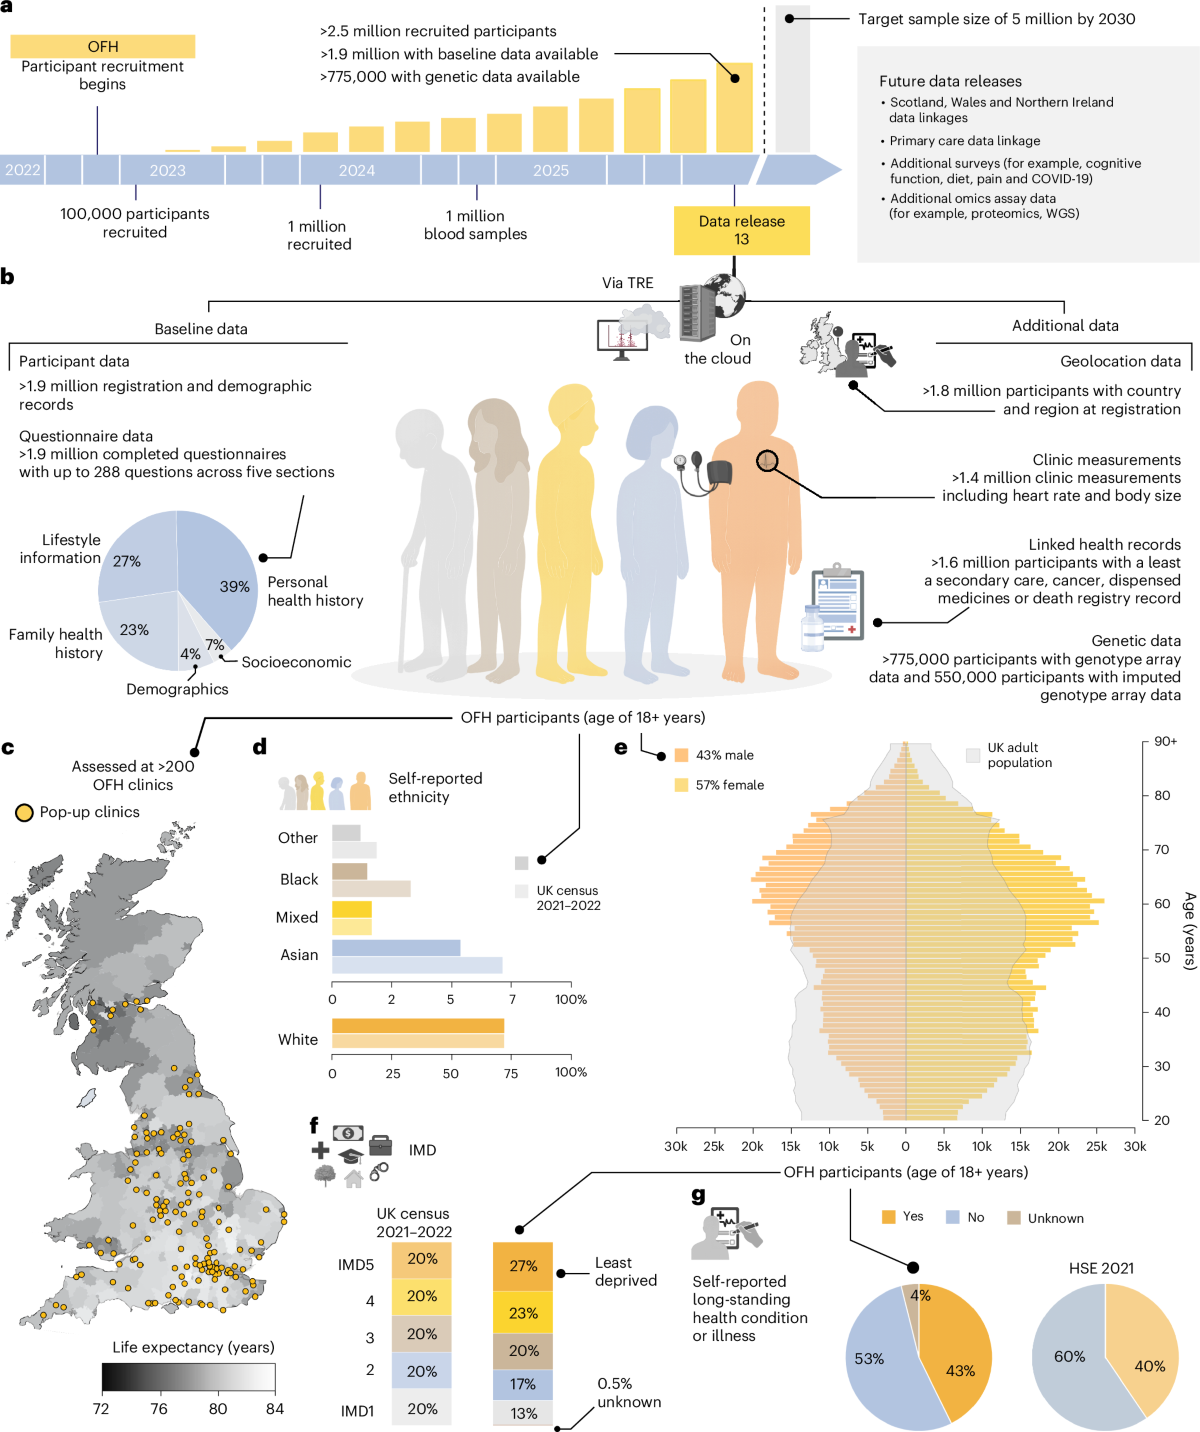
Eine am 10. September 2026 in Nature Medicine veröffentlichte Analyse liefert eine der detailliertesten phänomischen Momentaufnahmen des Vereinigten Königreichs, die bislang zusammengestellt wurden. Die Arbeit stammt von Our Future Health, einer prospektiven Kohorte, die darauf ausgelegt ist, 5 Millionen im Vereinigten Königreich ansässige Erwachsene einzuschließen, um die Entdeckung und Translation neuer Ansätze zur Prävention, Erkennung und Behandlung von Krankheiten zu beschleunigen. Die Rekrutierung hat bereits 2,5 Millionen Menschen überschritten, und Baseline-phänotypische Datensätze liegen nun für mehr als 1,9 Millionen von ihnen vor. Der Artikel wurde von Vincent J. Straub, Stefania Benonisdottir, Giovanni Scotti Bentivoglio, Neil Wary, Robert Campbell, Augustine Kong und Melinda C. Mills verfasst.
Statt sich auf eine einzelne Erkrankung zu konzentrieren, stellt die Studie eine breitere Frage: Wie sieht diese schnell wachsende Freiwilligenpopulation tatsächlich aus, und wie getreu spiegeln ihre Krankheitsmuster das Land wider, das sie repräsentieren soll? Um dies zu beantworten, verglichen die Autorinnen und Autoren die Kohorte mit nationalen Schätzungen und mit der älteren UK Biobank-Kohorte.
Was die Kohorte tatsächlich erfasst
Die Phänotypisierung ist die Grundlage für alles Weitere. Die Baseline-Daten umfassen ein breites Spektrum gesundheitsrelevanter Bereiche und stützen sich sowohl auf Angaben der Teilnehmenden als auch auf Registerverknüpfungen.
- Selbstberichtete gesundheitsbezogene Verhaltensweisen, einschließlich Lebensstilmerkmalen
- Geolokationsinformationen zu den Teilnehmenden
- Selbstberichtete Diagnosen und Medikamenteneinnahme
- Aufzeichnungen stationärer und ambulanter Besuche
- Daten aus Krebsregistern
- Informationen zur Todesursache
Diese Kombination ist wichtig, weil sie es Forschenden ermöglicht, über einen einzelnen Datenstrom hinauszugehen. Verhaltensweisen, Diagnosen, Verschreibungen, Kontakte zum Gesundheitssystem und Registerergebnisse können nebeneinander bewertet werden – genau das, was Präventionsforschung im Bevölkerungsumfang erfordert.

Sieht die Kohorte wie das Land aus?
Bei soziodemografischen, lebensstilbezogenen und gesundheitsbezogenen Maßen spiegelte die Teilnehmerpopulation weitgehend die Muster der Bevölkerung des Vereinigten Königreichs wider – ein ermutigendes Signal für eine Studie, die auf freiwillige Rekrutierung in enormem Umfang angewiesen ist. Doch das Bild ist nicht einheitlich. Bis auf eine Minderheitengruppe waren alle ethnischen Minderheiten im Verhältnis zur nationalen Bevölkerung unterrepräsentiert, und auch die sozioökonomisch am stärksten benachteiligten Gruppen waren unterrepräsentiert.
Diese Lücke ist keine Fußnote. Deprivation und Ethnizität sind stark mit Krankheitslast und Zugang zur Versorgung verbunden. Daher riskiert jede Kohorte, die diese Gruppen zu wenig berücksichtigt, genau jene Ungleichheiten zu unterschätzen, auf die Präventionsprogramme abzielen müssen. Die Autorinnen und Autoren stellen ausdrücklich fest, dass eine systematische Bewertung solcher Verzerrungen eine offene Aufgabe bleibt, während die Rekrutierung weiterläuft.
Psychische Erkrankungen stechen hervor
Die Prävalenzschätzungen für mehrere wichtige selbstberichtete Erkrankungen lagen über den nationalen Benchmarks, wobei psychische Erkrankungen – insbesondere Depression und Angst – zu den deutlichsten Beispielen gehörten. Die Richtung dieser Abweichung stimmte mit dem überein, was die UK Biobank berichtet, mit einer Korrelation von 0,78 zwischen den beiden Kohorten über die Erkrankungen hinweg.
Mehrere Erklärungen sind plausibel und schließen sich nicht gegenseitig aus: Freiwilligenkohorten ziehen tendenziell Menschen an, die sich bereits mit ihrer Gesundheit befassen; Selbstauskünfte erfassen Erkrankungen, die nie eine formale Diagnose erreichen; und nationale Schätzungen beruhen auf anderen Messinstrumenten. Die Übereinstimmung mit der UK Biobank deutet darauf hin, dass das Muster eine Eigenschaft großer Freiwilligenstudien im Vereinigten Königreich ist und nicht ein Artefakt dieses speziellen Datensatzes.

Replikation bekannter klinischer Zusammenhänge
Die Analyse prüfte außerdem, ob Assoziationen mit etablierten klinischen Korrelaten Bestand hatten. Das taten sie: Die Replikation über beide Kohorten erreichte eine Korrelation von 0,80. In praktischer Hinsicht wurden die Zusammenhänge, die Forschende bereits zwischen Risikofaktoren, Erkrankungen und Outcomes erwarten, im großen Maßstab reproduziert – ein Validierungsschritt, der nachgelagerter Entdeckungsarbeit eine festere Grundlage gibt.
Medikamenteneinnahme, Krebs und Altersgradienten
Muster der Medikamenteneinnahme und Krebsprävalenz folgten den altersbezogenen Gradienten, die Klinikerinnen und Kliniker vorhersagen würden, wobei ältere Teilnehmende die schwerere Last trugen. Eine bemerkenswerte Abweichung zeigte sich bei Lungenkrebs, wo die Raten in der Kohorte unter den nationalen Daten lagen – ein Befund, den die Autorinnen und Autoren markieren, statt ihn zu erklären, und der neben der breiteren Frage steht, wie Freiwilligenstichproben das formen, was eine Kohorte beobachtet.

Verzerrung, elektronische Datensätze und der Weg zu fünf Millionen
Die Studie versteht sich selbst als Baseline-Bewertung und nicht als endgültiges Urteil. Mit fortschreitender Rekrutierung, so argumentieren die Autorinnen und Autoren, können elektronische Gesundheitsdaten helfen, Krankheitsmuster präziser zu spezifizieren und Verzerrungen systematisch zu messen, statt sie nur abzuleiten. Die Verknüpfung von Kohortendaten mit Routinedatensätzen würde es Forschenden ermöglichen, Teilnehmende durch das Gesundheitssystem zu verfolgen, Erkrankungen zu erfassen, die Selbstauskünfte übersehen, und zu quantifizieren, wie weit die rekrutierte Population von der nationalen abweicht.
Das ist wichtig für die Translation. Wenn eine Kohorte Prävention und Früherkennung unterstützen soll, müssen ihre Schätzungen auf der Ebene spezifischer Erkrankungen, spezifischer Altersgruppen und spezifischer Gemeinschaften vertrauenswürdig sein – nicht nur in der Gesamtschau.
Warum Kohorten wie diese jetzt wichtig sind
Gesundheitssysteme stehen unter wachsendem Druck durch eine zunehmende chronische Krankheitslast, die durch Alterung, Lebensstiländerungen und Umweltexpositionen angetrieben wird, sowie durch anhaltende gesundheitliche Ungleichheiten und fragmentierte Daten. Die biomedizinische Forschung hat darauf reagiert, indem sie verschiedene Datentypen kombiniert – Multiomics, Lebensstilfaktoren, soziale Determinanten und Umweltmaße –, um die Gesundheit der Bevölkerung zu bewerten und Gruppen mit höherem Risiko zu identifizieren.
Große Kohortenstudien und Biobanken stehen im Zentrum dieses Wandels und sammeln, speichern und verwalten über lange Zeiträume systematisch Gesundheits- und biologischen Daten. Der Umfang von Our Future Health würde es, wenn sich die Repräsentation verbessert, zu einem der leistungsfähigsten Instrumente machen, die verfügbar sind, um zu untersuchen, wie Krankheiten in einer gesamten nationalen Bevölkerung entstehen.
Was als Nächstes zu beobachten ist
- Ob die Rekrutierung die Lücken bei unterrepräsentierten ethnischen Minderheiten und benachteiligten Gruppen schließt
- Wie stark die Verknüpfung mit elektronischen Gesundheitsdaten die Prävalenzschätzungen für Depression und Angst verschiebt
- Ob das unter dem nationalen Niveau liegende Lungenkrebs-Signal bestehen bleibt, während die Kohorte altert
- Wie die genetischen und biologischen Ebenen der Kohorte mit der hier beschriebenen phänotypischen Baseline zusammenhängen
Vorerst liefert die Analyse etwas Seltenes: eine transparente Bilanz dessen, was eine sehr große UK-Kohorte enthält, wie sie im Vergleich zur Nation und zu einer etablierten Biobank abschneidet und wo ihre blinden Flecken bleiben.
Dieser Artikel basiert auf Berichterstattung von Nature Medicine. Lesen Sie den Originalartikel.
Originally published on nature.com