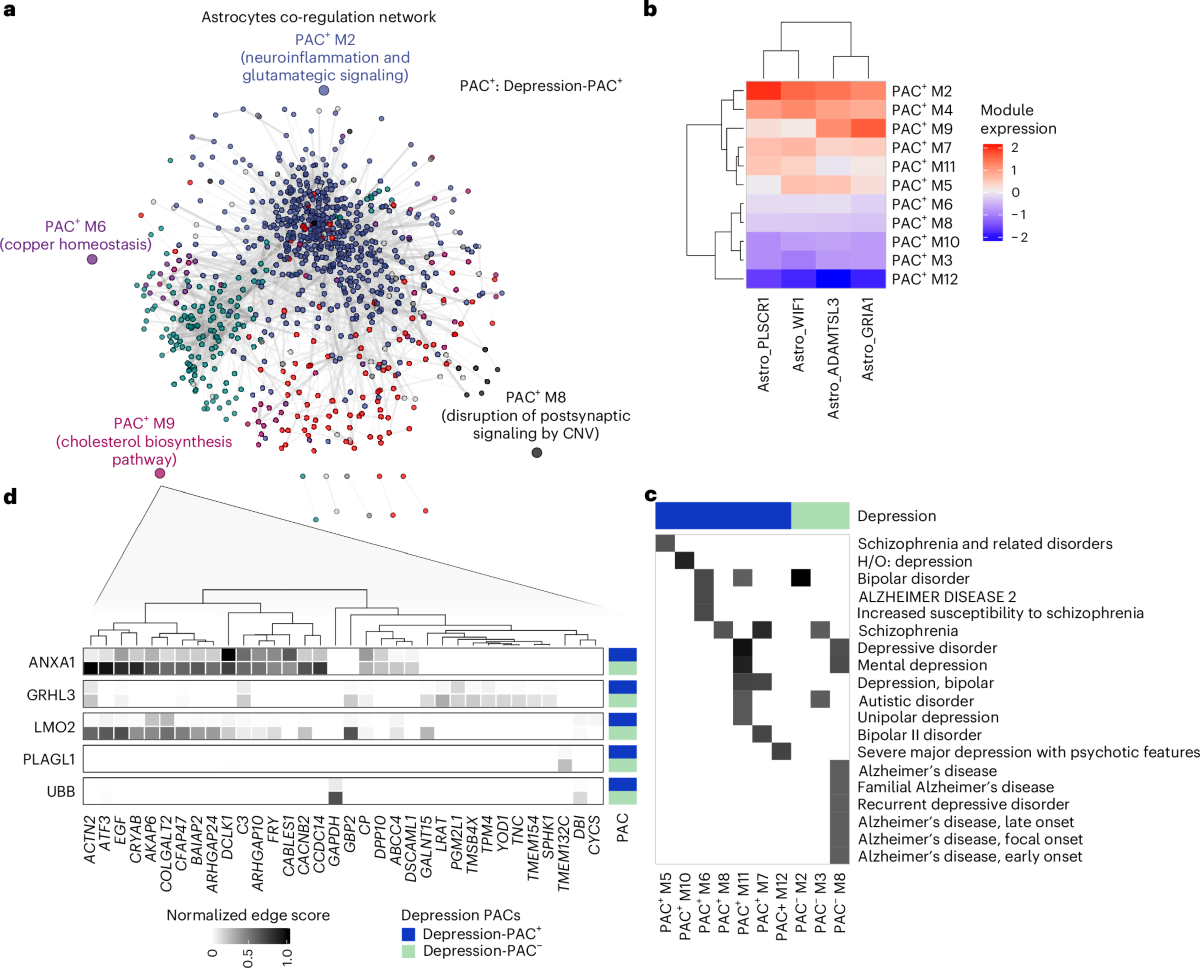
Die Alzheimer-Krankheit gehört zu den hartnäckigsten Rätseln der Medizin. Zwei Patientinnen und Patienten können dieselbe Diagnose tragen, bei denselben Gedächtnistests ähnlich abschneiden und sich dennoch enorm darin unterscheiden, welche Gehirnzellen zuerst versagen, welche molekularen Signalwege aus dem Ruder laufen und wie schnell der Verfall folgt. Eine am 23. September 2026 online in Nature Medicine veröffentlichte Studie argumentiert, dass künstliche Intelligenz helfen kann, diese Variabilität in einem Maßstab zu erfassen, den frühere Methoden nicht erreichen konnten.
Die Arbeit mit dem Titel „AI-based characterization of Alzheimer's disease phenotypes from population-scale single-cell data“ wendet Machine-Learning-Analysen auf Single-Cell-Messungen aus einer Kohorte von 584 Gehirnspendern an – eine Gruppe, die Patientinnen und Patienten mit Alzheimer-Krankheit sowie Vergleichsspender umfasst. Das erklärte Ziel ist ebenso einfach zu beschreiben wie schwer umzusetzen: Statt Alzheimer als eine einzige einheitliche Erkrankung zu behandeln, sollen computergestützte Methoden die molekularen Profile einzelner Zellen in erkennbare Krankheitsphänotypen einordnen.
Warum massives Hirngewebe das Bild verwischt
Während des größten Teils der Geschichte der Alzheimer-Forschung haben Wissenschaftlerinnen und Wissenschaftler Hirngewebe in Massenproben untersucht. Man zermahlt eine Region des Kortex, misst die durchschnittliche Aktivität Tausender Gene über Millionen von Zellen hinweg und erhält eine saubere, reproduzierbare Zahl. Doch ein Durchschnitt beschreibt eine Nachbarschaft nur schlecht. Wenn eine kleine Population von Immunzellen eine Entzündungsreaktion auslöst, während die meisten Neuronen einfach ihrer Arbeit nachgehen, kann dieses Signal bis zur Unsichtbarkeit verdünnt werden. Dasselbe Problem wirkt in umgekehrter Richtung: Eine Messung, die vom häufigsten Zelltyp dominiert wird, kann das Verhalten aller anderen verschleiern.
Single-Cell-Technologien haben die Rechnung verändert. Statt einer Messung pro Hirnregion können Forschende nun die Genaktivität in Tausenden einzelner Zellen oder Zellkerne gleichzeitig erfassen und jeder einzelnen eine molekulare Identität geben. Das Ergebnis ist keine einzelne Kurve, sondern eine riesige, dünn besetzte Matrix aus Zellen und Genen – ein Datensatz, dessen schiere Größe genau das ist, was Machine Learning attraktiv macht.
Die Zelltypen, die das Gespräch dominieren
- Neuronen tragen die elektrische und synaptische Maschinerie, auf der das Gedächtnis beruht, und ihre selektive Verletzlichkeit in verschiedenen Hirnregionen ist ein definierendes Merkmal der Erkrankung.
- Astrozyten unterstützen den neuronalen Stoffwechsel und helfen, die Blut-Hirn-Schranke aufrechtzuerhalten, und sie können in reaktive Zustände übergehen, die das umgebende Gewebe entweder schützen oder schädigen.
- Mikroglia sind die residenten Immunzellen des Gehirns; ihre Aktivierungszustände gehören zu den am intensivsten untersuchten Variablen in der Alzheimer-Forschung.
- Oligodendrozyten und ihre Vorläufer umhüllen Axone mit Myelin, und Veränderungen in der Unterstützung der weißen Substanz können beeinflussen, wie schnell neuronale Schaltkreise kommunizieren.
- Vaskuläre Zellen und Barrierezellen kleiden die Blutversorgung des Gehirns aus, wo Leckagen und beeinträchtigte Clearance-Mechanismen seit Langem mit dem Krankheitsverlauf in Verbindung gebracht werden.
Was KI tatsächlich beiträgt
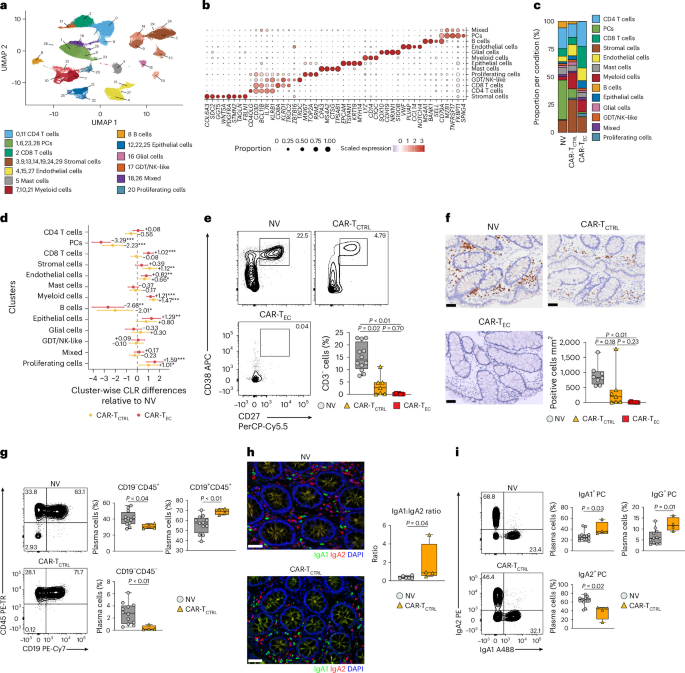
Sobald ein Datensatz Hunderttausende von Zellen enthält, die jeweils durch Tausende von Genen beschrieben werden, kann kein Mensch ihn mehr mit bloßem Auge erfassen. Machine-Learning-Methoden werden eingesetzt, um diese Dimensionalität zu komprimieren, Zellen mit ähnlichen Profilen zu gruppieren und nach Strukturen zu suchen, die konventionelle Kategorien durchschneiden – etwa Zellzustände, die zwischen zwei bekannten Typen liegen, oder Muster auf Spenderebene, die erst sichtbar werden, wenn Hunderte von Individuen gleichzeitig verglichen werden.
Das Wort „characterization“ im Titel der Arbeit ist von Bedeutung. Dies ist weder die Behauptung, einen diagnostischen Test entwickelt zu haben, noch das Versprechen, dass ein Modell vorhersagen kann, wer an Alzheimer erkranken wird. Es ist beschreibende und ordnende Arbeit: eine hochgradig heterogene Erkrankung zu nehmen und zu fragen, ob sich ihre molekulare Erscheinungsform in eine kleinere Zahl kohärenter Phänotypen auflöst, die benannt, verglichen und schließlich gezielt angegangen werden können.
Das Gewicht von 584 Gehirnspendern
Menschliches Hirngewebe ist eine knappe Ressource. Spenderprogramme erfordern Jahre der Koordination mit Familien, Klinikern und Pathologen, und jedes Präparat bringt seine eigene Geschichte von Alter, Genetik, Medikation und postmortalem Intervall mit. Eine Kohorte von 584 Spendern zusammenzustellen, ist daher für sich genommen eine erhebliche logistische Leistung, und es ist der Begriff „population-scale“ im Titel, der signalisiert, warum die Studie etwas versuchen kann, was eine kleine Stichprobe nicht könnte.
Skalierung verschafft statistische Power. Seltene Zellzustände, subtile Verschiebungen im Anteil eines Zelltyps gegenüber einem anderen und Wechselwirkungen zwischen genetischem Risiko und Zellverhalten werden erst nachweisbar, wenn genügend Spender verglichen werden. Sie ermöglicht zudem die Art interner Replikation, die Machine-Learning-Studien benötigen: Ein in einer Teilgruppe von Spendern gefundenes Muster kann gegen eine andere getestet werden, bevor jemand behauptet, es sei real.

Warum Phänotypen mehr zählen als ein einzelnes Label
Die Alzheimer-Medikamentenentwicklung wurde von der Annahme geprägt, dass eine Erkrankung einen Mechanismus und eine Behandlung erfordert. Diese Annahme hat jahrzehntelange teure Enttäuschungen hervorgebracht. Wenn es sich bei der Erkrankung tatsächlich um eine Familie verwandter, aber unterscheidbarer molekularer Phänotypen handelt, dann könnte die Mittelung von Ergebnissen über alle Patientinnen und Patienten hinweg echte Vorteile in einer Untergruppe verbergen – und ebenso Patientinnen und Patienten Nebenwirkungen einer Therapie aussetzen, die auf die falsche Biologie abzielt.
Phänotyp-first-Denken ist in der Onkologie nicht neu, wo Tumorprofiling vor der Behandlungsauswahl Standardpraxis ist. Die Frage, die diese Forschungsrichtung aufwirft, ist, ob Neurodegeneration auf dieselbe Weise angegangen werden kann – indem zelluläre und molekulare Signaturen statt allein klinischer Symptome verwendet werden, um zu definieren, wer eine Patientin oder ein Patient ist.
Grenzen und offene Fragen
Postmortales Gewebe bietet eine Momentaufnahme, die oft am Ende einer langen Erkrankung entnommen wird. Es kann zeigen, welche zellulären Zustände eine fortgeschrittene Erkrankung begleiten, aber es kann kaum feststellen, welche Veränderungen zuerst kamen oder welche Ursachen statt Folgen sind. Spenderkohorten sind zudem in bekannter Weise verzerrt: Menschen, die ihr Gehirn spenden, sind keine Zufallsstichprobe der Bevölkerung, und die Erkrankung selbst kann zelluläre Profile auf eine Weise verändern, die nichts mit ihrer Grundursache zu tun hat.
Hinzu kommt die vertraute Gefahr, leistungsstarke Modelle auf komplexe Biologie anzuwenden. Machine Learning kann Strukturen finden, die technische Artefakte widerspiegeln – Unterschiede darin, wie Proben verarbeitet oder wie Zellen sequenziert wurden – und nicht die Erkrankung. Unabhängige Replikation in separaten Kohorten und Validierung mit komplementären Methoden sind das, was ein überzeugendes Muster von einem belastbaren Befund trennt.
Was als Nächstes zu beobachten ist
- Replikation: ob dieselben Phänotypen in unabhängigen Spendersammlungen und bei lebenden Patientinnen und Patienten wieder auftauchen, die über Blut oder Liquor beprobt wurden.
- Räumlicher Kontext: ob Zellzustände, die in dissoziiertem Gewebe identifiziert wurden, zurück auf ihre physischen Nachbarschaften abgebildet werden können, da der Ort die Funktion prägt.
- Klinische Translation: ob irgendein Phänotyp einem messbaren Unterschied im Verlauf oder im Ansprechen auf Behandlung entspricht.
- Datenweitergabe: ob die zugrunde liegenden zellulären Daten in einer Form veröffentlicht werden, die andere Gruppen wiederverwenden können, was bestimmt, wie schnell das Feld auf dem Ergebnis aufbauen kann.
Die veröffentlichte Zusammenfassung der Studie ist bewusst kompakt, und die inhaltlichen Details – welche Phänotypen sich zeigten, wie stabil sie sind und wie sie mit bestehenden genetischen und pathologischen Markern zusammenhängen – stehen in der vollständigen Arbeit. Was die Zusammenfassung jedoch etabliert, ist die Form des Vorhabens: ein KI-getriebener Versuch, ein einzelnes, grobes Alzheimer-Label durch eine präzisere zelluläre Beschreibung zu ersetzen, angewandt in einem Maßstab, der vor einem Jahrzehnt nicht möglich war. Ob diese Beschreibung Bestand hat, wird durch Replikation entschieden, nicht durch die Eleganz des Modells.
Dieser Artikel basiert auf Berichterstattung von Nature Medicine. Lesen Sie den Originalartikel.
Originally published on nature.com


