临床预测模型需要的不只是已发表的结果
临床预测模型正越来越多地用于支持诊断和预后决策。论文报告的准确性可能影响临床医生如何估计风险、确定检查优先级,或与患者讨论可能的结果。但《Nature Medicine》发表的一项新分析指出,评估这类模型的一项基本条件仍不常见:获取其背后的分析代码。
该研究审查了引用TRIPOD或TRIPOD+AI报告框架的开放获取研究论文,这些框架涉及预测模型研究的透明报告。研究人员使用大型语言模型辅助的流程筛选文献、识别代码仓库链接,并根据14项预先定义的可重复性相关特征评估能够访问的代码仓库。
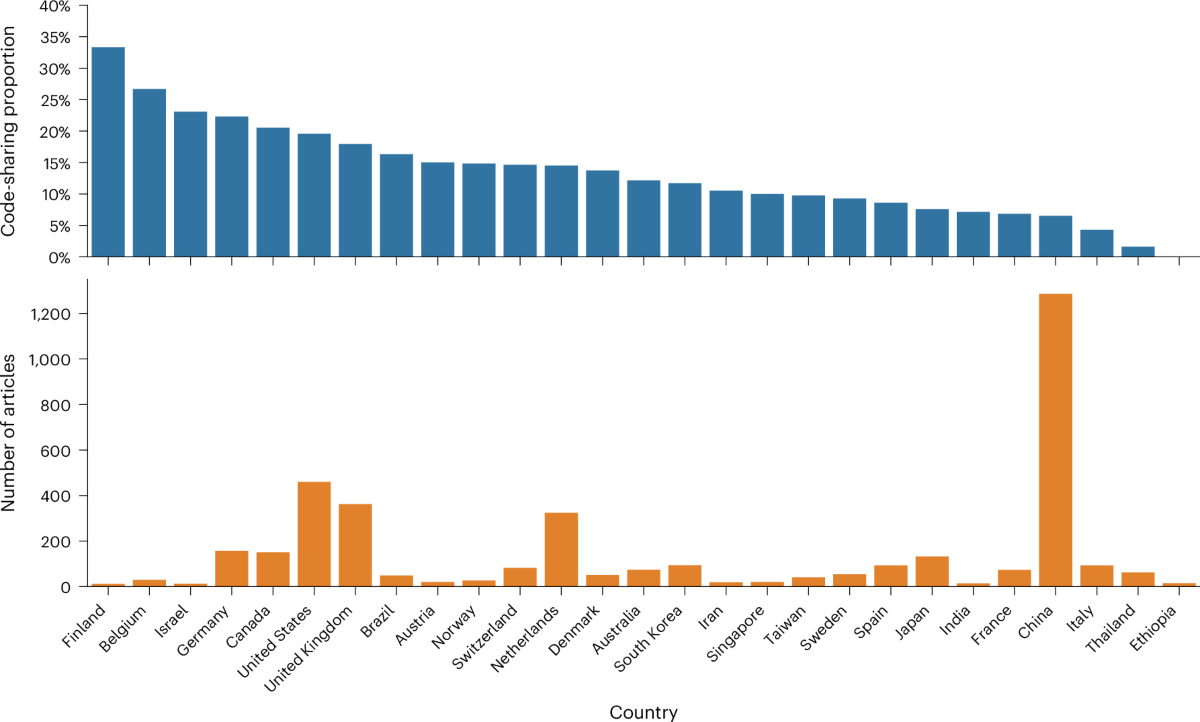
在审查的3,967篇论文中,有482篇声明共享了代码,占样本的12.2%。这一发现并不能证明其余每项研究都没有可访问的代码,但确实表明,在所审查的文献中,明确的代码共享声明仍属例外。
可获取并不等于可重复
研究人员的核心观点是,仅有一个代码仓库链接,并不意味着分析易于核查或复用。他们发现,所评估代码仓库在可重复性相关特征方面存在显著差异。实际上,另一名研究人员可能需要的不只是源文件,才能了解一个模型是否可以重建:文档、软件依赖信息以及可执行的项目结构都可能十分重要。
这一点对临床预测研究尤为重要。一个模型可能基于特定队列、预处理流程和一组结局定义开发。如果无法独立检查分析步骤,外部研究人员就更难评估工作流程中的选择如何影响报告的性能,或判断这项工作能否在不同环境中进行调整和测试。
该综述还发现,代码共享率因期刊和国家而有很大差异。研究文本没有指出哪些期刊或国家领先、哪些滞后,但这种差异表明,研究人员是否公开其工作,正受到相关规范和编辑要求的影响。
由AI辅助的研究实践综述
作者将大型语言模型辅助流程用于方法学工作:筛选相关论文、提取代码仓库链接,并根据预先设定的特征集协助评估代码仓库。这种方法使团队能够审查数千篇论文,而实质性指标仍然集中于具体的报告内容和代码仓库特征。
这一应用也反映出研究治理面临的更广泛挑战。随着发表量增长,透明度实践的人工审查越来越难以扩大规模。结构化且经过精心设计的自动化流程可以帮助描绘这些实践,只要其输出依据明确定义的标准进行评估。在本研究中,这些标准与代码可用性和可重复性相关特征相联系,而不是用于自动判断单个模型的科学质量。
这一差距为何影响模型部署
临床模型旨在为现实世界的决策提供依据,因此其可靠性和可推广性需要受到严格审查。一篇论文中的模型看似有效,但在其他地方实施时可能表现不同,因为患者群体、数据收集方式和临床工作流程存在差异。对分析过程进行独立评估,是审视这些结论基础的一种方式。
开放代码无法解决所有可重复性问题。出于隐私和法律原因,患者数据可能受到限制;如果无法获取原始数据,外部用户也可能无法完全重现分析。即便如此,清晰的分析代码、依赖项细节和可用文档仍能提高工作的可审查性,并帮助研究人员了解使用另一数据集负责任地进行测试需要哪些条件。
作者将这些结果视为支持更明确要求的证据,而不仅仅是简单声明代码存在。他们表示,文档、依赖项说明和可执行结构都应成为更高标准实践的一部分。这些要素可以减少读者的歧义,也能帮助尝试复现或扩展研究的团队。

TRIPOD-Code成为下一项政策目标
开展这项综述的目的是为TRIPOD-Code提供依据。TRIPOD-Code是一项聚焦代码可用性和可重复性的报告指南。报告指南本身并不能保证研究人员发布完整且可用的项目。不过,它们可以向作者、审稿人和期刊明确展示相关要求,并为识别已提供的内容建立共同语言。
研究结果提供了一个具体基准:在这一文献样本中,只有大约八分之一的论文包含代码共享声明。作者认为,对于模型正走向临床应用的领域,提高共享分析工作的质量和清晰度,可以让研究更具可用性,并有助于更安全地转化到实践中。
因此,这项研究将关注点从论文是否仅仅提到代码,转向独立读者能否理解并运行分析工作流程。这是一项更高的要求,但也更符合在临床预测模型被用于医疗场景之前,对其进行判断所需的证据标准。
本文基于《Nature Medicine》的报道。阅读原文。
Originally published on nature.com

