阿尔茨海默病是医学界最顽固的难题之一。两名患者可能携带相同的诊断、在相同的记忆测试中得分相近,但在哪些脑细胞最先衰退、哪些分子通路出现异常以及衰退速度有多快等方面仍可能差异巨大。2026年9月23日在线发表于《自然·医学》的一项研究认为,人工智能可以帮助在早期方法无法企及的规模上理解这种变异性。
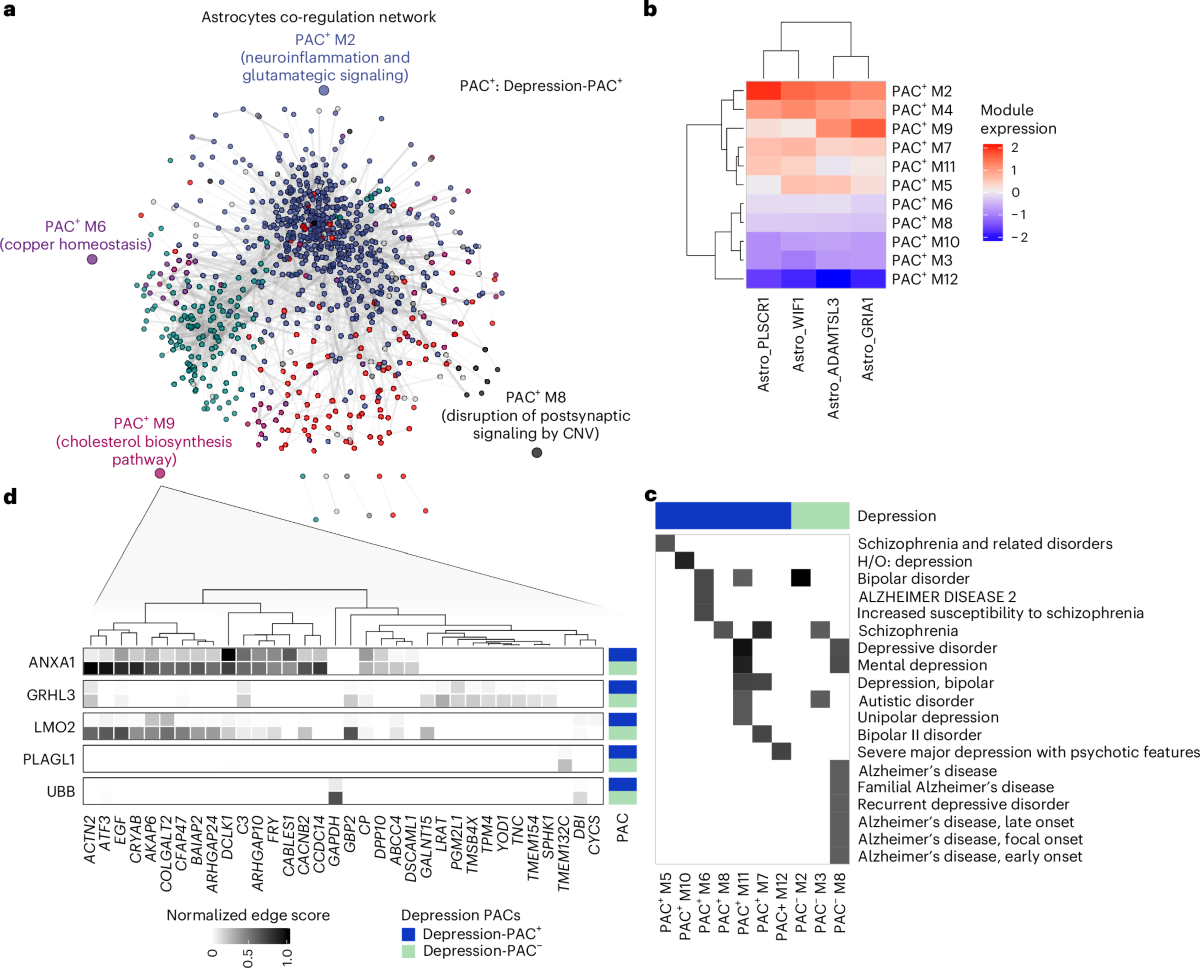
这篇题为“基于AI从群体规模单细胞数据中表征阿尔茨海默病表型”的论文,将机器学习分析应用于取自584个大脑供体队列的单细胞测量数据——该队列既包括阿尔茨海默病患者,也包括对照供体。其公开目标描述起来容易、执行起来却很难:不再将阿尔茨海默病视为单一均质的疾病,而是用计算方法将单个细胞的分子谱归类为可识别的疾病表型。
为何批量脑组织会模糊图像
在阿尔茨海默病研究的大部分历史中,科学家一直以批量方式研究脑组织。将某一皮层区域研磨后,测量数百万个细胞中数千个基因的平均活性,就能得到一个干净、可重复的数值。但平均值并不能很好地描述一个“街区”。如果一小群免疫细胞正在发起炎症反应,而大多数神经元只是照常运作,这一信号就可能被稀释到不可见。同样的问题也会反向出现:由最丰富细胞类型主导的测量结果,可能掩盖其他所有细胞的行为。
单细胞技术改变了这道算术题。研究人员如今不再对每个脑区只做一次测量,而是可以同时捕获数千个单个细胞或细胞核中的基因活性,为每一个赋予分子身份。结果不是一条单一曲线,而是一个庞大而稀疏的细胞与基因矩阵——正是其巨大的体量,使机器学习变得有吸引力。
主导讨论的细胞类型
- 神经元承载记忆所依赖的电活动和突触机制,它们在不同脑区中的选择性脆弱性是这种疾病的一个决定性特征。
- 星形胶质细胞支持神经元代谢并帮助维持血脑屏障,它们可以转变为反应性状态,从而保护或损害周围组织。
- 小胶质细胞是大脑中的常驻免疫细胞;它们的激活状态是阿尔茨海默病研究中被研究最多的变量之一。
- 少突胶质细胞及其前体细胞用髓鞘包裹轴突,而白质支持的变化可以改变神经回路通信的速度。
- 血管和屏障细胞衬贴于大脑的血液供应,其渗漏和清除机制受损长期以来被认为与疾病进展有关。

AI究竟贡献了什么
一旦数据集包含数十万个细胞,每个细胞又由数千个基因描述,就没有人能用肉眼审视它。机器学习方法被用来压缩这种维度、将具有相似特征的细胞分组,并寻找跨越传统类别的结构——例如介于两种已知类型之间的细胞状态,或只有在同时比较数百个个体时才会出现的供体层面模式。
论文标题中的“表征”一词很重要。这并不是声称已经构建了一种诊断测试,也不是承诺某个模型可以预测谁会患上阿尔茨海默病。它是一项描述性和组织性的工作:面对一种高度异质的疾病,追问其分子表现是否可以分解为数量更少、彼此连贯、可以命名、比较并最终成为靶点的表型。
584个大脑供体的分量
人脑组织是一种稀缺资源。供体项目需要与家属、临床医生和病理学家进行多年协调,而每一份标本都带着自己的年龄、遗传、用药和死后间隔历史。因此,汇集584个供体的队列本身就是一项重大的后勤成就,而标题中“群体规模”这一表述,正说明为什么这项研究能够尝试小样本无法做到的事情。
规模带来统计功效。罕见细胞状态、某一细胞类型相对于另一细胞类型比例的细微变化,以及遗传风险与细胞行为之间的相互作用,只有在比较足够多的供体时才能被检测到。它还能实现机器学习研究所需的那种内部重复验证:在任何人声称某一模式真实存在之前,可以先在一个供体子集中发现的模式用另一个子集进行检验。

为什么表型比单一标签更重要
阿尔茨海默病药物开发一直受到这样一种假设的塑造:一种疾病需要一种机制和一种治疗。这一假设带来了数十年的昂贵失望。如果这种疾病实际上是一个由相关但可区分的分子表型组成的家族,那么对所有患者的结局取平均,可能会掩盖某一亚组中的真实获益——同样也可能使患者因针对错误生物学的疗法而承受副作用。
表型优先的思维在肿瘤学中并不新鲜,在肿瘤学中,治疗选择前进行肿瘤谱分析已是标准做法。这条研究路线提出的问题是,神经退行性疾病能否以同样的方式处理,即不仅用临床症状,还用细胞和分子特征来定义患者是谁。
局限与未解问题
死后组织提供的是一张快照,而且往往是在漫长疾病末期拍摄的。它可以揭示哪些细胞状态伴随晚期疾病出现,但很难确定哪些变化最先发生,或者哪些是原因而非结果。供体队列还存在研究人员熟知的选择偏倚:捐献大脑的人并不是人群中的随机样本,而且疾病本身也可能以与其根本病因无关的方式改变细胞谱。
此外还有将强大模型应用于复杂生物学时常见的危险。机器学习可能发现反映技术性伪影的结构——例如样本处理方式或细胞测序方式的差异——而非疾病本身。在独立队列中重复验证,并用互补方法加以验证,才能将有说服力的模式与持久的发现区分开来。

接下来值得关注什么
- 重复验证:相同的表型是否会在独立供体集合以及通过血液或脑脊液采样的活体患者中再次出现。
- 空间背景:在解离组织中识别出的细胞状态能否映射回其物理邻域,因为位置会塑造功能。
- 临床转化:是否有任何表型对应于疾病进展或治疗反应方面可测量的差异。
- 数据共享:底层细胞数据是否以其他团队可以复用的形式发布,这决定了该领域能以多快速度在此结果上继续构建。
该研究的已发表摘要刻意保持简洁,而实质性细节——出现了哪些表型、它们有多稳定,以及它们与现有遗传和病理标志物有何关系——都存在于完整论文中。摘要确实确立的是这项工作的形态:一次由AI驱动的尝试,用更精确的细胞描述取代单一而粗钝的阿尔茨海默病标签,并应用于十年前不可能达到的规模。这种描述能否站得住脚,将由重复验证决定,而不是由模型的优雅程度决定。
本文基于《自然·医学》的报道。阅读原文。
Originally published on nature.com