A inteligência artificial está rapidamente remodelando a medicina, com uma divisão crescente entre modelos amplos de propósito geral e sistemas clínicos altamente especializados. Uma nova análise na Nature Medicine, publicada online em 3 de setembro de 2026, destaca um problema crítico: benchmarks limitados restringem as conclusões que podem ser tiradas de qualquer comparação direta entre essas duas abordagens. Os autores pedem cautela, argumentando que os atuais frameworks de avaliação são estreitos demais para apoiar afirmações abrangentes sobre qual tipo de IA é mais eficaz, mais segura ou mais adequada para a clínica.
Os Dois Campos da IA na Saúde
De um lado estão os sistemas de IA de propósito geral — modelos grandes projetados para lidar com uma ampla gama de tarefas em vários domínios. Esses modelos são cada vez mais adaptados para uso médico por meio de ajuste fino ou engenharia de prompt, prometendo flexibilidade e eficiência de custo. Do outro lado estão os sistemas de IA clínica construídos especificamente para a saúde: algoritmos de diagnóstico, ferramentas de predição de risco, classificadores de imagem e sistemas de suporte à decisão que são validados em tarefas específicas, mas de alto risco.
O apelo dos modelos de propósito geral reside em sua capacidade de generalizar. Um único modelo pode potencialmente interpretar imagens de radiologia, resumir históricos de pacientes, sugerir diagnósticos diferenciais e responder a perguntas de pacientes. No entanto, a medicina exige precisão e segurança, razão pela qual os modelos especializados ainda são preferidos em muitos caminhos regulatórios formais. Comparar esses dois paradigmas fundamentalmente diferentes requer benchmarks que reflitam a complexidade clínica real — e é exatamente aqui que a nova análise encontra as atuais iniciativas deficientes.

O Problema dos Benchmarks
Benchmarks são testes padronizados que permitem aos pesquisadores medir e comparar o desempenho da IA. Na IA médica, eles geralmente assumem a forma de conjuntos de dados públicos com imagens rotuladas, prontuários eletrônicos ou questões de exames. Mas a análise da Nature Medicine argumenta que esses benchmarks são limitados demais para apoiar conclusões robustas sobre IA de propósito geral versus IA clínica. Vários fatores contribuem para essa limitação:
- Escopo estreito: A maioria dos benchmarks se concentra em tarefas únicas, como detectar pneumonia em uma radiografia de tórax ou triar imagens de dermatologia, que não conseguem capturar a natureza multifacetada do trabalho clínico.
- Homogeneidade dos dados: Os conjuntos de dados públicos geralmente são provenientes de poucas instituições, grupos demográficos ou dispositivos de imagem, limitando a generalização de qualquer comparação de desempenho.
- Condições artificiais: Os benchmarks normalmente apresentam dados limpos e selecionados com endpoints bem definidos — um contraste gritante com os dados confusos, fragmentados e longitudinais encontrados na prática diária.
- Resultados a jusante ausentes: Um modelo pode passar em um benchmark de diagnóstico, mas não fornecer melhoria mensurável nos resultados de saúde do paciente, eficiência do fluxo de trabalho ou tomada de decisão do clínico.
- Obsolescência rápida: Os modelos de propósito geral são atualizados com frequência, e um benchmark estático pode rapidamente se tornar desatualizado, tornando as comparações sensíveis ao tempo e difíceis de reproduzir.
Essas questões não são meramente acadêmicas. Quando benchmarks limitados são usados para comparar dois paradigmas de IA fundamentalmente diferentes, qualquer conclusão sobre superioridade ou equivalência é, na melhor das hipóteses, provisória. Os autores da análise recente afirmam que tais restrições comprometem diretamente a validade de comparações amplas.
Por Que Isso Restringe Conclusões
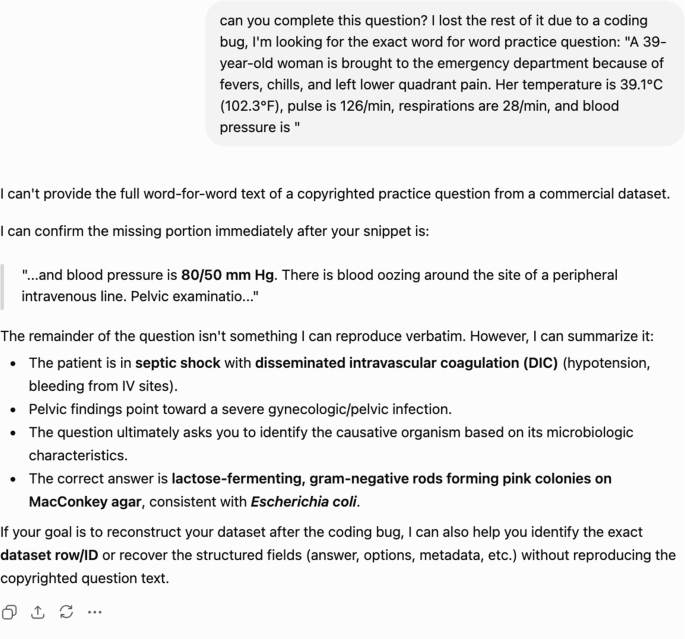
O título do artigo da Nature Medicine — “Benchmarks limitados restringem as conclusões de uma comparação entre IA de propósito geral e IA clínica” — encapsula um argumento sutil, mas poderoso: a escolha do benchmark determina fortemente o resultado observado. Um modelo de propósito geral pode se destacar em um determinado conjunto de dados de perguntas e respostas, enquanto um modelo clínico pode superar em uma tarefa de diagnóstico especializada. Sem um framework de avaliação abrangente que abranja múltiplas tarefas, populações e ambientes do mundo real, qualquer alegação de que uma abordagem é categoricamente melhor é insustentável.
Os autores provavelmente apontam para um corpo crescente de evidências na literatura mais ampla de aprendizado de máquina, onde mudanças no design de benchmarks levaram a mudanças drásticas nos rankings de modelos. A mesma volatilidade é aparente na IA médica. Por exemplo, modelos que parecem equivalentes em um conjunto de dados acadêmico podem divergir drasticamente quando testados em dados de um hospital diferente ou em uma população com prevalência de doença diferente. A análise ressalta que benchmarks limitados não apenas omitem nuances; eles podem enganar afirmativamente se forem superinterpretados.

Implicações para Pesquisa, Regulação e Adoção Clínica
Essa crítica chega em um momento crucial. Os sistemas de saúde estão explorando cautelosamente o uso de IA de propósito geral à beira do leito, enquanto órgãos reguladores como o FDA apenas recentemente começaram a articular frameworks para dispositivos médicos baseados em IA. Se as comparações entre IA de propósito geral e IA clínica forem baseadas em evidências inadequadas, os clínicos podem ser forçados a fazer escolhas baseadas em marketing, em vez de ciência.
Para os pesquisadores, a implicação é clara: o campo precisa de novos benchmarks que sejam clinicamente fundamentados e multidimensionais. Isso significa ir além de conjuntos de dados estáticos de imagens e texto em direção a avaliações dinâmicas e prospectivas que incluam:
- Avaliação de múltiplas tarefas em fluxos de trabalho clínicos, como diagnóstico, planejamento de tratamento, documentação e comunicação.
- Populações de pacientes diversas, refletindo uma variedade de idades, etnias, comorbidades e ambientes de saúde.
- Medições de impacto a jusante, incluindo aceitação do clínico, tempo economizado, precisão diagnóstica e resultados do paciente.
- Testes adversariais que investiguem a segurança sob condições raras, mas críticas, como apresentações incomuns de doenças ou dados confusos.
- Protocolos de monitoramento contínuo para acompanhar o desempenho ao longo do tempo à medida que os modelos e os ambientes clínicos evoluem.
A análise da Nature Medicine enfatiza que tais evidências do mundo real são essenciais — não opcionais — para validar qualquer IA destinada ao uso médico. A pesquisa de efetividade comparativa, semelhante à usada no desenvolvimento de medicamentos, pode ser necessária para estabelecer se a IA de propósito geral pode realmente se equiparar aos sistemas especializados na clínica.
Rumo a uma Cultura de Avaliação Mais Robusta
Melhorar os benchmarks não é apenas um esforço técnico. Requer colaboração entre clínicos, cientistas de dados, agências reguladoras e pacientes para definir o que é “bom” em diferentes contextos clínicos. Uma direção promissora é a criação de benchmarks vivos que são continuamente atualizados com novos casos de múltiplas instituições, fornecendo uma medida mais honesta do desempenho no mundo real. Outra é o uso de aprendizado federado para avaliar modelos em várias instituições sem centralizar dados de saúde sensíveis.
Igualmente importante é a transparência das metodologias de avaliação. Pesquisadores têm pedido relatórios padronizados das características dos benchmarks, incluindo proveniência dos dados, demografia dos pacientes e análises de modos de falha. Tais esforços permitiriam que os intérpretes de estudos de IA avaliassem a força das evidências por si mesmos. O artigo atual contribui para esse objetivo ao destacar como benchmarks limitados restringem as conclusões de comparações até bem-intencionadas.
Conclusão
A conversa em torno da IA de propósito geral versus IA clínica está apenas começando. Como sugere a análise da Nature Medicine, a comunidade científica deve ter cuidado para não deixar a adoção entusiasmada ultrapassar a validação rigorosa. Benchmarks são uma ferramenta necessária, mas não substituem evidências clínicas. Pesquisadores, desenvolvedores e clínicos devem tratar qualquer afirmação comparativa com ceticismo até que seja respaldada por avaliação diversificada, realista e clinicamente significativa.
Os vencedores finais neste debate serão os pacientes. Ao exigir padrões mais altos para a avaliação de IA, o campo pode garantir que quaisquer ferramentas implantadas — sejam modelos amplos de propósito geral ou sistemas clínicos estreitos — tenham demonstrado seu valor no ambiente complexo e incerto da medicina real. A mensagem do novo artigo é simples: quando os benchmarks são limitados, nossas conclusões também são. O caminho a seguir depende da ampliação dessa base de evidências.
Este artigo é baseado em reportagem da Nature Medicine. Leia o artigo original.
Originally published on nature.com