Um estudo construído em torno de duas perguntas diferentes
A Nature Medicine publicou o artigo online em 13 de setembro de 2026 sob o título "Clinical usability of an explainable AI decision support tool and evaluation of multimodal models in NSCLC". A formulação importa tanto quanto qualquer resultado contido nela. Os autores se propuseram a fazer duas coisas ao mesmo tempo: avaliar comparativamente quão bem modelos multimodais lidam com câncer de pulmão de células não pequenas e testar se uma ferramenta de apoio à decisão construída em torno desse tipo de modelo é genuinamente utilizável pelos médicos que dependeriam dela.
Esse enquadramento duplo distingue o trabalho do fluxo constante de artigos que relatam um único número de desempenho e param por aí. Um modelo pode obter uma pontuação impressionante em um conjunto de teste reservado e ainda assim decepcionar em uma clínica — se suas saídas chegam tarde demais no fluxo de trabalho, se a interface esconde por que uma recomendação apareceu, ou se a explicação é escrita para engenheiros em vez de oncologistas. De acordo com o resumo que acompanha a publicação, o modelo multimodal explicável saiu à frente na avaliação dos autores. O interesse explícito pela usabilidade clínica sugere que a equipe tratou esse resultado como ponto de partida, e não como linha de chegada.
O que "multimodal" significa neste contexto
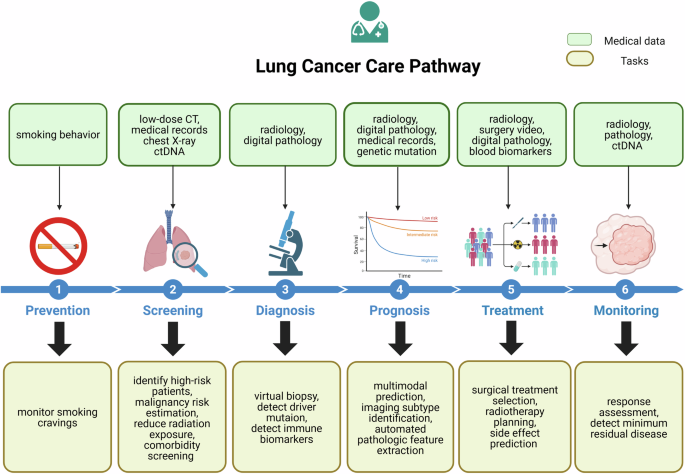
Modelos multimodais consomem mais de um tipo de entrada simultaneamente, em vez de tratar um único exame ou um único painel laboratorial como a história completa. No câncer de pulmão de células não pequenas, as entradas relevantes são excepcionalmente variadas. Estudos de imagem capturam tamanho, localização e disseminação do tumor. Lâminas de patologia carregam detalhes em nível de tecido sobre a aparência das células cancerígenas e quão agressivas elas parecem. Registros clínicos contêm estado de desempenho, histórico de tabagismo, tratamentos prévios e comorbidades. Testes moleculares acrescentam alterações motoras que determinam cada vez mais quais terapias são oferecidas a um paciente.
Durante anos, esses fluxos viveram em sistemas separados e eram reconciliados na cabeça do médico. Um modelo multimodal tenta combiná-los, partindo da premissa de que a combinação carrega informações que nenhuma fonte isolada carrega. A dificuldade é que cada fluxo tem seus próprios padrões de dados ausentes, suas próprias unidades e sua própria confiabilidade. Quando um modelo se baseia em todos eles ao mesmo tempo, a questão de qual entrada impulsionou determinada saída torna-se mais difícil de responder — e é precisamente aí que entra a explicabilidade.

Explicabilidade como requisito clínico, não como bônus
Um modelo explicável é aquele cujo raciocínio pode ser apresentado a um humano em alguma forma interpretável. Em oncologia, isso não é uma preferência estética. Decisões de tratamento em NSCLC carregam toxicidade real, custo real e irreversibilidade real, e uma recomendação que não pode ser interrogada é difícil de ser seguida de forma responsável. Quando uma ferramenta sinaliza um paciente como candidato a uma via em detrimento de outra, a equipe responsável precisa saber quais características impulsionaram a avaliação e com que força.
O enquadramento do artigo trata explicabilidade e usabilidade como problemas interligados, e não sequenciais. Entre as considerações que esse pareamento levanta:
- Se as explicações são expressas em termos que os médicos já usam, em vez de pesos abstratos de características.
- Se a ferramenta esclarece uma decisão que o médico já estava ponderando, ou introduz um julgamento concorrente que precisa ser arbitrado.
- Se as explicações permanecem estáveis entre pacientes que parecem semelhantes no papel, para que a confiança não seja construída sobre coincidência.
- Se a interface se encaixa no ritmo de um comitê de tumores real, onde o tempo por caso é medido em minutos.
Cada uma dessas é uma questão de usabilidade tanto quanto uma questão de aprendizado de máquina, e cada uma é o tipo de coisa que um benchmark puramente retrospectivo de acurácia não consegue responder.
Por que "grande, internacional, do mundo real" importa
O estudo é descrito como uma investigação grande, internacional e do mundo real. Esses três adjetivos fazem muito trabalho em conjunto. Dados multicêntricos e de vários países reduzem o risco de que um modelo tenha simplesmente aprendido os hábitos de equipamento, convenções de codificação ou padrões de encaminhamento de um único hospital. Dados do mundo real, em oposição a coortes de ensaios rigidamente curadas, refletem a mistura mais bagunçada de pacientes que os médicos realmente veem — incluindo aqueles que nunca teriam atendido a critérios de elegibilidade estritos em um estudo prospectivo.
O trade-off é que conjuntos de dados do mundo real são mais ruidosos, e o caminho dos registros brutos até entradas prontas para o modelo raramente é limpo. Como uma equipe lida com essa tradução molda o que o desempenho relatado significa, em última análise. Uma grande amostra internacional torna os achados mais portáveis em princípio, mas a portabilidade ainda precisa ser demonstrada, e não presumida.

Onde ferramentas de IA costumam travar
Testes de usabilidade clínica abordam a lacuna entre um modelo que funciona e um modelo que é usado. Os modos de falha recorrentes estão bem documentados em toda a IA clínica: alertas que disparam com tanta frequência que são descartados, painéis que duplicam informações já presentes na tela e saídas que chegam depois que a decisão já foi efetivamente tomada. Uma ferramenta de apoio à decisão precisa conquistar seu lugar em um fluxo de trabalho que já está sobrecarregado.
Ao nomear a usabilidade clínica diretamente no título, o estudo sinaliza que os autores mediram algo além de discriminação e calibração. O trabalho de usabilidade normalmente pergunta se os médicos conseguem interpretar a saída da ferramenta, se concordam com ela, se ela muda o plano declarado por eles e se os deixa mais lentos. Essas medidas são mais difíceis de resumir em um número de manchete, o que é parte do motivo pelo qual são frequentemente ignoradas.
Questões que o artigo deixa em aberto
Várias coisas ficam fora do que um único estudo com esse formato consegue resolver. Desempenho medido em relação a desfechos retrospectivos não é o mesmo que melhores desfechos para os pacientes, e demonstrar o segundo exige avaliação prospectiva. A qualidade da explicação também é difícil de quantificar — um modelo pode produzir uma explicação sem que essa explicação seja fiel à computação que produziu a predição. E a adoção depende de fatores institucionais, da integração com o prontuário eletrônico a quem carrega a responsabilidade quando uma recomendação é seguida e o resultado é ruim.
Há também a questão de como essa ferramenta se comporta à medida que a prática muda. Os paradigmas de tratamento em NSCLC mudam rapidamente conforme novos agentes e subgrupos definidos por biomarcadores emergem. Um modelo treinado com as decisões de uma época pode codificar padrões que os médicos desde então abandonaram.
Por que isso chega agora
O câncer de pulmão continua sendo uma das áreas mais consequentes para o apoio à decisão, porque o número de caminhos de tratamento plausíveis cresceu mais rápido do que o tempo disponível para raciocinar sobre cada caso. Modelos multimodais prometem comprimir esse raciocínio; explicabilidade e usabilidade determinam se a compressão é confiável. Publicar essa combinação de avaliação de modelo e avaliação de usabilidade clínica em um veículo de alto perfil coloca um marco: cada vez mais se pede que o campo mostre não apenas que um modelo prediz bem, mas que um médico consegue trabalhar com ele. O próximo teste é se ferramentas desse tipo se sustentam quando são implantadas prospectivamente, nas clínicas que as usariam.
Este artigo é baseado em reportagem da Nature Medicine. Leia o artigo original.
Originally published on nature.com