रोबोटसाठी व्यापक डेटा पाया उभारणे
Rhoda AI एका साध्या पण महत्त्वाकांक्षी गृहितकावर काम करत आहे: काळजीपूर्वक नियंत्रित केलेल्या प्रात्यक्षिकांच्या बाहेर रोबोटनी विश्वासार्हपणे काम करायचे असेल, तर त्यांना प्रशिक्षण डेटाचा अधिक मोठा आणि अधिक वैविध्यपूर्ण स्रोत आवश्यक आहे. कंपनी हालचाल, भौतिकशास्त्र आणि भौतिक परस्परसंवाद समजून घेण्यासाठी तयार केलेली मॉडेल्स विकसित करण्यासाठी इंटरनेट-स्तरीय व्हिडिओचा वापर करत आहे आणि नंतर ते पूर्वज्ञान रोबोटिक्समध्ये लागू करत आहे.
2026 च्या सुरुवातीला 18 महिने गुप्तपणे काम केल्यानंतर Rhoda ने 450 दशलक्ष डॉलरच्या Series A निधीसह आपली सुरुवात केली. ऑटोमोटिव्ह, उत्पादन, लॉजिस्टिक्स आणि ई-कॉमर्स क्षेत्रातील ग्राहकांसोबत आपल्या direct video action, किंवा DVA, मॉडेलची अंमलबजावणी करण्यासाठी काम करत असल्याचे कंपनीचे म्हणणे आहे.
ती ज्या आव्हानाला सामोरे जात आहे ते रोबोटिक्समध्ये परिचित आहे. एखादे यंत्र प्रयोगशाळेत प्रभावी काम करू शकते, परंतु प्रत्यक्ष तैनातीमध्ये मोठी विविधता असते: वस्तू वेगवेगळ्या ठिकाणी येतात, कार्यक्षेत्रे बदलतात आणि प्रत्येक प्रक्रिया वेगळ्या पद्धतीने घडू शकते. या विस्कळीतपणाचा सामना करण्यासाठी मजबूत मॉडेल्सची गरज आहे आणि त्या मजबुतीसाठी मोठ्या प्रशिक्षण डेटासेटची आवश्यकता आहे, असे Rhoda चे सह-संस्थापक आणि CEO Jagdeep Singh यांनी सांगितले.
या दृष्टिकोनात व्हिडिओ केंद्रस्थानी का आहे
Large language models वेगाने प्रगत होण्याचे एक कारण म्हणजे ती मोठ्या प्रमाणातील मजकुरातून शिकू शकत होती. भौतिक परस्परसंवादासाठी रोबोटिक्सकडे इंटरनेट-स्तरीय डेटा स्रोताचा समकक्ष पर्याय अद्याप नाही. भाषिक डेटाच्या विपुलतेची तुलना रोबोटसाठी उपलब्ध असलेल्या तुलनेने मर्यादित डेटाशी Singh यांनी केली.
ऐतिहासिकदृष्ट्या, डेव्हलपर्सनी टेलिऑपरेशनद्वारे रोबोट डेटा गोळा करण्याचा प्रयत्न केला आहे: लोक रोबोट नियंत्रित करतात आणि प्रणाली त्या प्रात्यक्षिकांची नोंद करतात. या पद्धतीमुळे रोबोट टी-शर्ट घडी करणे किंवा कॉफी बनवणे यांसारखी आकर्षक उदाहरणे तयार होऊ शकतात. मात्र वास्तविक परिस्थितीत मजबूत स्वायत्त मॅनिप्युलेशनसाठी आवश्यक असलेले प्रमाण आणि वैविध्य केवळ प्रात्यक्षिकांमधून मिळालेले नाही, असा Rhoda चा युक्तिवाद आहे.
व्हिडिओ ही दरी भरून काढण्यास मदत करू शकतो, यावर Rhoda चा भर आहे. व्हिडिओमध्ये हालचाली, वस्तूंशी परस्परसंवाद आणि बदलत्या दृश्यांची उदाहरणे अशा प्रमाणात असतात की ती केवळ खास रोबोट-डेटा संकलनातून पुन्हा तयार करणे कठीण आहे. कंपनी रोबोटिक वापरासाठी मॉडेल्सचे रूपांतर करण्यापूर्वी त्यांना व्हिडिओवर प्रीट्रेन करते.
डायरेक्ट व्हिडिओ अॅक्शन कसे कार्य करते
अनेक physical-AI डेव्हलपर्स vision-language-action, किंवा VLA, मॉडेल्सवर काम करत आहेत. या प्रणाली रोबोटच्या आजूबाजूच्या चित्रे किंवा व्हिडिओसोबत मजकूर सूचना वापरतात. Rhoda च्या मते, तिचे DVA मॉडेल संबंधित पण वेगळ्या क्रमावर आधारित आहे: ते व्हिडिओ फ्रेम्सचा इतिहास, अॅक्शन टोकन्स आणि भाषिक टोकन्स घेते, नजीकच्या भविष्यातील व्हिडिओ दृश्याचा अंदाज लावते आणि नंतर तो अंदाज रोबोटच्या कृतींमध्ये रूपांतरित करते.
Singh यांच्या वर्णनानुसार, मॉडेल पुढील काही शेकडो मिलिसेकंदांत, म्हणजे साधारण पुढील अर्ध्या सेकंदात, दृश्यात काय घडेल याचा अंदाज लावते. दुसरा घटक, action converter, त्या अंदाजित दृश्याचा वापर करून रोबोटसाठी कृती तयार करतो.
रोबोटच्या पुढील हालचालीचे मध्यवर्ती प्रतिनिधित्व म्हणून व्हिडिओ अंदाजाचा वापर करणे हा या रचनेचा उद्देश आहे. perception-and-language इनपुटचे थेट कमांडमध्ये रूपांतर करण्याऐवजी, प्रणाली प्रथम परिस्थितीच्या संभाव्य भौतिक पुढील क्रमाचे मॉडेलिंग करते आणि नंतर ते रोबोट कार्यान्वित करू शकेल अशा action space मध्ये रूपांतरित करते.
गतिशीलता आणि मॅनिप्युलेशन एकत्र आणणे
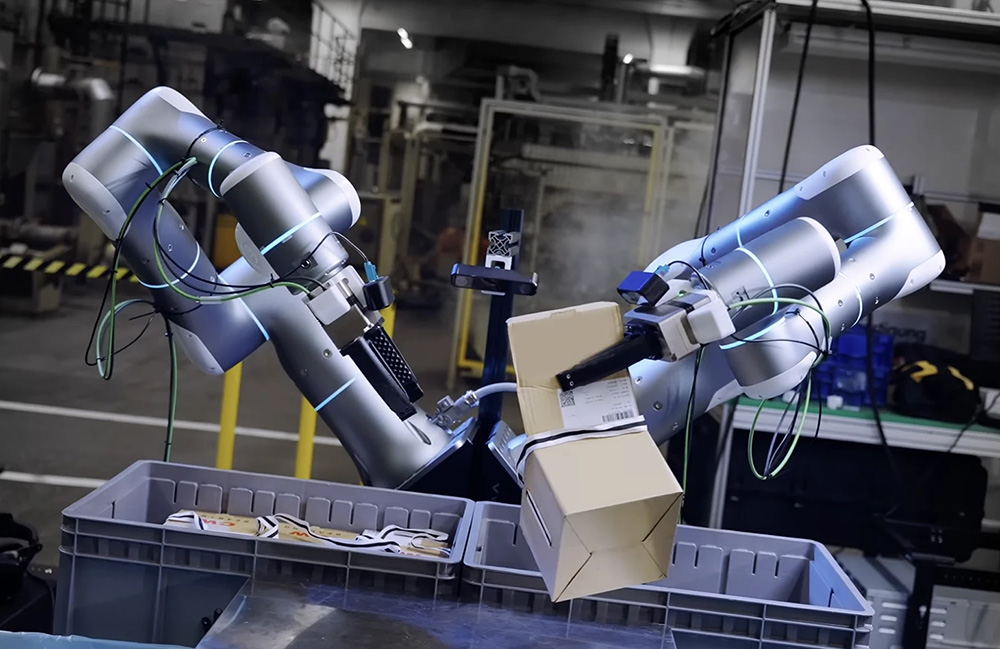
Rhoda ने अलीकडे mobile DVA द्वारे या दृष्टिकोनाचा विस्तार केला आहे. एका policy मध्ये मॅनिप्युलेशन आणि गतिशीलता एकत्र केली जात असल्याचे कंपनीचे म्हणणे आहे. रोबोटला स्थिर जागेवरून काम करण्याऐवजी एखाद्या सुविधेत फिरणे आणि वस्तूंशी परस्परसंवाद करणे दोन्ही आवश्यक असतात, अशा वापरांसाठी हे महत्त्वाचे आहे.
ऑटोमोटिव्ह, उत्पादन, लॉजिस्टिक्स आणि ई-कॉमर्सची वातावरणे अशा प्रणालींसाठी नैसर्गिक लक्ष्ये आहेत, कारण त्यात पुनरावृत्तीची कामे असली तरी दररोज मोठ्या प्रमाणावर बदलही होतात. वेगवेगळ्या मांडण्या हाताळू शकणारे मॉडेल काटेकोरपणे स्क्रिप्ट केलेल्या सेटअपभोवती तयार केलेल्या मॉडेलपेक्षा अधिक उपयुक्त ठरू शकते.
Rhoda चे दावे तिच्या तांत्रिक रणनीतीचे आणि तैनातीच्या महत्त्वाकांक्षांचे वर्णन म्हणून पाहिले पाहिजेत; सामान्यीकृत रोबोटिक्सची समस्या सुटली आहे, याचा स्वतंत्रपणे स्थापित पुरावा म्हणून नव्हे. वास्तविक जगातील बदलशीलतेला कंपनी स्वतः मुख्य समस्या मानते. त्यामुळे बदलते वातावरण, वस्तू आणि कार्यस्थितींमध्ये मॉडेल्स कशी वागतात यावर प्रत्यक्ष कामगिरी अवलंबून असेल.
रोबोटिक्समधील व्यापक प्रश्न
कंपनीचा दृष्टिकोन रोबोटिक्समध्ये foundation-model-style प्रशिक्षणाकडे होत असलेल्या व्यापक बदलाचे प्रतिबिंब आहे. व्यापक डेटातून पुन्हा वापरता येणारा prior तयार करणे आणि त्याचा वापर करून कार्य-विशिष्ट प्रणाली अधिक अनुकूल बनवणे हे उद्दिष्ट आहे. या प्रकरणात foundational material मजकूर नसून भौतिक कृतींचा व्हिडिओ आहे.
या रणनीतीत आकर्षण आहे, कारण भौतिक प्रणालींना अशा तपशीलांचा सामना करावा लागतो जे एखाद्या प्रात्यक्षिकात सहज दुर्लक्षित होऊ शकतात. प्रकाश बदलतो, वस्तू सरकतात, पृष्ठभाग वेगळे असतात आणि त्याच कृतीसाठी प्रत्येक वेळी किंचित वेगळी प्रतिक्रिया आवश्यक असू शकते. हालचाल आणि परस्परसंवादाची विस्तृत दृश्य उदाहरणे आत्मसात केलेले मॉडेल, तत्त्वतः, भौतिकदृष्ट्या शक्य असलेल्या गोष्टींबद्दल अधिक मजबूत अपेक्षेने सुरुवात करू शकते.
ही अपेक्षा विश्वासार्ह रोबोटमध्ये रूपांतरित होते की नाही, हीच व्यावहारिक कसोटी असेल. कारखाने, गोदामे आणि इतर कार्यकारी वातावरणांमध्ये मोठ्या प्रमाणातील व्हिडिओ आकलनाचे उपयुक्त कृतीत रूपांतर करण्याचा मार्ग म्हणून Rhoda DVA ला मांडत आहे. एखाद्या एकमेव नीटस प्रात्यक्षिकाने नव्हे, तर जग नेमके पुन्हा तस्से घडण्यास नकार देत असताना रोबोट काम करत राहू शकतात की नाही, यावर तिची प्रगती मोजली जाईल.
हा लेख The Robot Report च्या वृत्तांकनावर आधारित आहे. मूळ लेख वाचा.
Originally published on therobotreport.com