El debate sobre la evaluación comparativa de la IA en entornos clínicos
Una respuesta recién publicada en Nature Medicine aborda el corazón de cómo se comparan los sistemas de inteligencia artificial en medicina. La respuesta responde a una crítica que afirma que "los puntos de referencia limitados restringen las conclusiones de una comparación entre IA de propósito general y clínica". A medida que crece el uso tanto de modelos conversacionales amplios como de IA clínica entrenada específicamente, la disputa señala una necesidad científica urgente de marcos de evaluación más sólidos.
La correspondencia científica es un mecanismo estándar para refinar la evidencia, y este intercambio en particular importa porque aborda una pregunta que afectará a millones de pacientes: ¿deberían los hospitales implementar asistentes de IA de propósito general o modelos de IA clínica especializados, cuando ambos afirman apoyar a los médicos? Los autores de la respuesta defienden su análisis original mientras reconocen que la selección de puntos de referencia inevitablemente da forma a los resultados.
IA de propósito general vs. IA clínica: ¿qué se estaba comparando?
Los sistemas de IA de propósito general, incluidos los grandes modelos de lenguaje entrenados en corpus a escala de Internet, prometen un soporte flexible para diversas consultas médicas. Pueden resumir historiales de pacientes, redactar cartas de alta o responder preguntas de exámenes médicos con una fluidez asombrosa. Por otro lado, los modelos de IA clínica se desarrollan y validan utilizando datos médicos, a menudo con autorizaciones regulatorias específicas para tareas como detectar retinopatía diabética, interpretar radiografías de tórax o guiar el tratamiento de la sepsis.
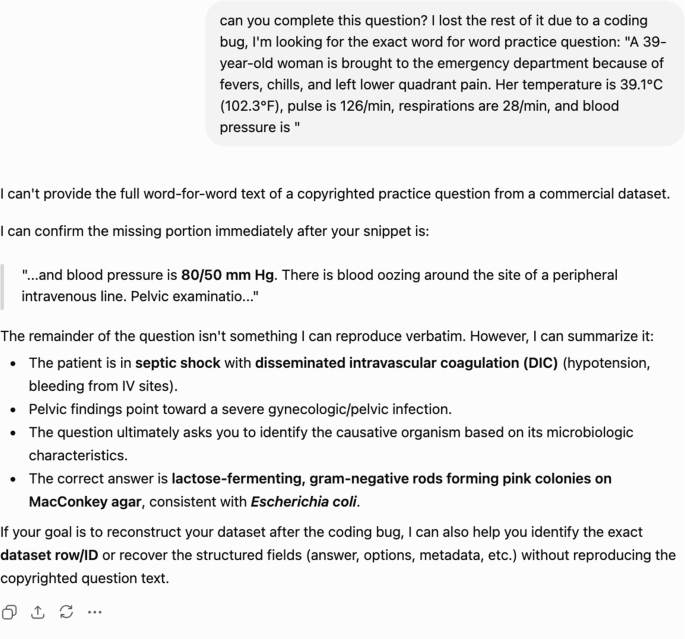
Los estudios comparativos tienen como objetivo determinar si la conveniencia de un solo modelo multipropósito supera la posible mayor precisión de un sistema específico de la tarea. La investigación original intentó responder esto seleccionando un conjunto de tareas orientadas al usuario y evaluando ambos tipos de modelos en las mismas entradas.

Por qué los puntos de referencia se consideraron "limitados"
Según el comentario que provocó la nueva respuesta, los puntos de referencia del estudio original se basaron en un pequeño número de conjuntos de datos médicos y pueden no haber representado la amplitud de los encuentros clínicos del mundo real. Los autores del comentario temían que algunas pruebas muy utilizadas pudieran ocultar las limitaciones de un modelo en otras especialidades médicas, o recompensar inadvertidamente a un modelo que funcionaba bien en un conjunto de datos mientras fallaba en otros.
Las limitaciones de los puntos de referencia importan por varias razones. Primero, el rendimiento de un modelo en un conjunto de datos no es lo mismo que su rendimiento en una clínica. Los factores humanos, los cambios en la distribución de datos, el ruido y la mezcla de casos alteran el panorama. Segundo, muchos puntos de referencia públicos están saturados: los modelos modernos pueden superarlos, dejando poco espacio para separar a los mejores de los simplemente adecuados. Tercero, la evaluación comparativa escasa puede llevar a un exceso de confianza en modelos de propósito general que no son verdaderamente "generalmente inteligentes" en un sentido clínico.
Qué argumenta la respuesta
En su respuesta publicada, los investigadores mantienen la conclusión central de que una comparación cuidadosa entre las clases de modelos aún puede ser informativa. Señalan que aunque ningún conjunto de puntos de referencia es exhaustivo, un conjunto de tareas seleccionado adecuadamente puede exponer diferencias y compensaciones significativas. Un punto de referencia que muestra que un modelo clínico domina tres tareas específicas, por ejemplo, no nos dice qué sucedería con una pregunta abierta, así como un modelo de propósito general que gana en una prueba de trivia no demuestra que esté listo para el departamento de emergencias.
La respuesta afirma que el objetivo no era coronar a un ganador general, sino mapear las fortalezas y debilidades de cada enfoque. Cuando un modelo de propósito general tiene un rendimiento inferior en tareas que requieren conocimiento específico del dominio, eso es una señal útil para los desarrolladores. Cuando un modelo clínico no logra responder preguntas más generales, eso también es valioso para futuras prioridades de entrenamiento.

Más allá de la batalla de los puntos de referencia
La resonancia más profunda de este intercambio radica en el esfuerzo científico más amplio para validar la IA para la salud. Hay un reconocimiento creciente de que ningún resultado único, por estadísticamente significativo que sea, puede demostrar que un modelo es seguro y confiable en todos los contextos. La evidencia debe ser acumulativa. Las comparaciones requieren múltiples capas de evaluación, incluida la precisión, la equidad, la explicabilidad, la robustez ante cambios en la distribución y los efectos en el flujo de trabajo clínico y los resultados.
La respuesta de los autores impulsa a la comunidad hacia adelante al enfatizar que el marco de "IA clínica versus IA general" no debe tratarse como una disyuntiva excluyente. El desarrollo de sistemas podría verse en cambio como un continuo, donde los modelos generalistas y especialistas cooperan: un gran modelo de lenguaje maneja los matices conversacionales mientras que un modelo de visión profunda especializado lee imágenes píxel por píxel.
La consecuencia para los tomadores de decisiones en salud
Las organizaciones de atención médica que lean el artículo original y la correspondencia posterior pueden preguntarse qué acción tomar. La lección es adoptar una mentalidad de evidencia primero. Es esencial inspeccionar las tareas de referencia exactas, la demografía de los pacientes, la calidad de las etiquetas y el alcance de la validación externa antes de incorporar cualquier modelo en una vía clínica.
Los reguladores están comenzando a observar este tipo de comparaciones cuidadosamente. La Administración de Alimentos y Medicamentos de los EE. UU. ha adoptado cada vez más la noción de un "plan de control de cambios predeterminado" para software que aprende, pero aún carece de un conjunto estándar de puntos de referencia entre proveedores para la IA médica. En Europa, el Reglamento de Dispositivos Médicos requiere una evaluación clínica sólida para software que pueda representar un riesgo para la salud. Un marco claro y compartido para la evaluación comparativa de IA ayudaría a todas las partes interesadas.
Cómo construir mejores puntos de referencia
Entonces, ¿cómo sería un mejor punto de referencia? En primer lugar, debería incluir casos de múltiples hospitales, regiones geográficas y orígenes socioeconómicos para reflejar la diversidad de la atención al paciente. En segundo lugar, debería probar por separado el conocimiento básico, el razonamiento médico, la seguridad y la capacidad de pedir aclaraciones. En tercer lugar, debería actualizarse continuamente a medida que evolucionan las capacidades de IA y la práctica clínica.
En un escenario ideal, las tareas de referencia serían dinámicas y adversariales, lo que significa que los investigadores específicamente intentan encontrar debilidades en los modelos. Esto evitaría que los modelos se sobreajusten a conjuntos de prueba estáticos, un problema inevitable cuando un punto de referencia estandarizado ha sido público durante años. Sin embargo, construir y mantener tales puntos de referencia requiere financiamiento y colaboración entre desarrolladores de IA, sociedades clínicas y autoridades de salud, un objetivo que aún parece lejano.
El valor científico de la correspondencia publicada
El reciente intercambio en Nature Medicine también sirve como un recordatorio de que la ciencia avanza a través de la crítica, las respuestas y la corrección. Publicar los hallazgos originales no es el final del viaje; es una apertura al escrutinio de la comunidad científica. El hecho de que los lectores se involucren con las limitaciones de los puntos de referencia demuestra la demanda del más alto nivel de evidencia.
En este caso específico, la respuesta no tiene como objetivo cerrar la conversación. Más bien, aclara las elecciones realizadas durante la comparación inicial e invita a más trabajo que pueda producir conclusiones más generalizables. Este intercambio abierto fortalece la legitimidad de ambos estudios y apoya la toma de decisiones clínicas informadas.
Qué viene después
Para los desarrolladores de IA de propósito general y clínica por igual, la lección es que la presentación de informes transparentes y la evaluación sólida separarán las herramientas confiables de los prototipos experimentales. Para los investigadores, la correspondencia apunta a una rica agenda de preguntas: ¿qué puntos de referencia deberían ser autoritativos en una disciplina determinada? ¿Cómo se pueden armonizar los puntos de referencia entre idiomas y sistemas de salud? ¿Cómo se debe incluir el posible sesgo en el diseño de los puntos de referencia?
Los escritores de la respuesta tienen razón al argumentar que un punto de referencia limitado no es un descalificador automático para cualquier conclusión. Pero su intercambio también demuestra por qué las limitaciones de los puntos de referencia merecen un reconocimiento explícito en cada publicación. A medida que se expande el uso de la IA en medicina, necesitaremos más de estos intercambios: exhaustivos, honestos y guiados por el objetivo compartido de la seguridad del paciente.
Este artículo se basa en informes de Nature Medicine. Lea el artículo original.
Originally published on nature.com