Eine Studie, die um zwei verschiedene Fragen herum aufgebaut ist
Nature Medicine veröffentlichte die Arbeit am 13. September 2026 online unter dem Titel „Clinical usability of an explainable AI decision support tool and evaluation of multimodal models in NSCLC.“ Die Formulierung ist ebenso wichtig wie jedes darin enthaltene Ergebnis. Die Autorinnen und Autoren setzten sich zwei Ziele zugleich: zu benchmarken, wie gut multimodale Modelle mit nicht-kleinzelligem Lungenkarzinom umgehen, und zu testen, ob ein Entscheidungsunterstützungstool, das um ein solches Modell herum gebaut ist, für die Klinikerinnen und Kliniker, die darauf angewiesen wären, tatsächlich nutzbar ist.
Diese doppelte Rahmung unterscheidet die Arbeit von dem stetigen Strom an Publikationen, die eine einzelne Leistungszahl berichten und dort aufhören. Ein Modell kann auf einem zurückgehaltenen Testsatz beeindruckend abschneiden und in einer Klinik dennoch enttäuschen – wenn seine Ausgaben zu spät im Arbeitsablauf eintreffen, wenn die Oberfläche verbirgt, warum eine Empfehlung erschienen ist, oder wenn die Erklärung für Ingenieurinnen und Ingenieure statt für Onkologinnen und Onkologen geschrieben ist. Der Zusammenfassung zur Publikation zufolge schnitt das multimodale erklärbare Modell in der Bewertung der Autorinnen und Autoren besser ab. Das ausdrückliche Interesse an klinischer Nutzbarkeit deutet darauf hin, dass das Team dieses Ergebnis als Ausgangspunkt und nicht als Ziellinie behandelte.
Was „multimodal“ in diesem Kontext bedeutet
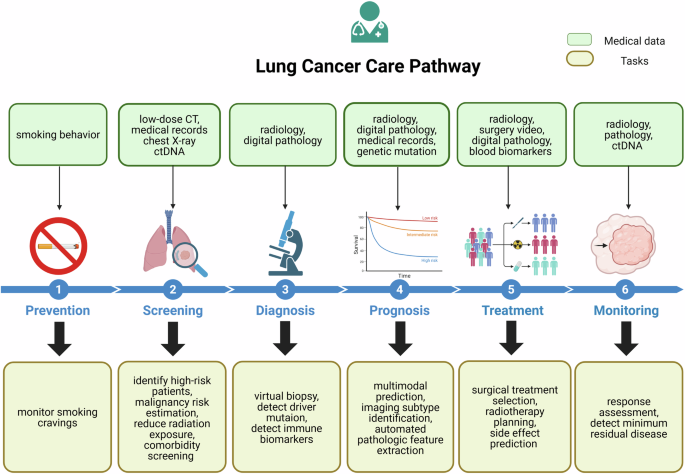
Multimodale Modelle verarbeiten mehr als eine Art von Eingabe gleichzeitig, statt einen einzelnen Scan oder ein einzelnes Laborpanel als die ganze Geschichte zu behandeln. Beim nicht-kleinzelligen Lungenkarzinom sind die relevanten Eingaben ungewöhnlich vielfältig. Bildgebende Untersuchungen erfassen Tumorgröße, -lokalisation und -ausbreitung. Pathologische Präparate tragen Details auf Gewebeebene darüber, wie die Krebszellen aussehen und wie aggressiv sie erscheinen. Klinische Aufzeichnungen enthalten Performance-Status, Raucheranamnese, frühere Behandlungen und Komorbiditäten. Molekulare Tests ergänzen treibende Veränderungen, die zunehmend bestimmen, welche Therapien einem Patienten angeboten werden.
Jahrelang lebten diese Ströme in getrennten Systemen und wurden im Kopf einer Klinikerin oder eines Klinikers zusammengeführt. Ein multimodales Modell versucht, sie zu kombinieren, unter der Prämisse, dass die Kombination Informationen trägt, die keine einzelne Quelle besitzt. Die Schwierigkeit besteht darin, dass jeder Strom seine eigenen Missingness-Muster, seine eigenen Einheiten und seine eigene Zuverlässigkeit hat. Wenn ein Modell auf alle gleichzeitig zurückgreift, wird die Frage, welche Eingabe eine gegebene Ausgabe angetrieben hat, schwerer zu beantworten – und genau hier kommt Erklärbarkeit ins Spiel.

Erklärbarkeit als klinische Anforderung, nicht als Bonus
Ein erklärbares Modell ist eines, dessen Schlussfolgerung einem Menschen in irgendeiner interpretierbaren Form offengelegt werden kann. In der Onkologie ist das keine ästhetische Vorliebe. Behandlungsentscheidungen beim NSCLC bringen echte Toxizität, echte Kosten und echte Unumkehrbarkeit mit sich, und eine Empfehlung, die nicht hinterfragt werden kann, ist schwer verantwortungsvoll umzusetzen. Wenn ein Tool eine Patientin oder einen Patienten als Kandidatin oder Kandidaten für einen Weg gegenüber einem anderen markiert, muss das behandelnde Team wissen, welche Merkmale die Einschätzung vorangetrieben haben und wie stark.
Die Rahmung der Arbeit behandelt Erklärbarkeit und Nutzbarkeit als verbundene und nicht als aufeinanderfolgende Probleme. Zu den Überlegungen, die diese Verknüpfung aufwirft, gehören:
- Ob Erklärungen in Begriffen ausgedrückt werden, die Klinikerinnen und Kliniker bereits verwenden, statt in abstrakten Merkmalsgewichten.
- Ob das Tool eine Entscheidung klärt, die die Klinikerin oder der Kliniker bereits abwog, oder ein konkurrierendes Urteil einführt, das entschieden werden muss.
- Ob Erklärungen über Patientinnen und Patienten hinweg stabil bleiben, die auf dem Papier ähnlich aussehen, damit Vertrauen nicht auf Zufall aufbaut.
- Ob die Oberfläche zum Tempo eines echten Tumorboards passt, bei dem die Zeit pro Fall in Minuten gemessen wird.
Jede dieser Fragen ist ebenso eine Nutzbarkeitsfrage wie eine Frage des maschinellen Lernens, und jede ist die Art von Sache, die ein rein retrospektiver Genauigkeits-Benchmark nicht beantworten kann.
Warum „groß, international, real-world“ zählt
Die Studie wird als große internationale Real-World-Untersuchung beschrieben. Diese drei Adjektive leisten zusammen eine Menge. Daten aus mehreren Zentren und mehreren Ländern verringern das Risiko, dass ein Modell einfach die Gewohnheiten der Ausstattung, der Kodierungskonventionen oder der Überweisungsmuster eines einzelnen Krankenhauses gelernt hat. Real-World-Daten, im Gegensatz zu streng kuratierten Studienkohorten, spiegeln die unordentlichere Mischung von Patientinnen und Patienten wider, die Klinikerinnen und Kliniker tatsächlich sehen – einschließlich jener, die strenge Eignungskriterien in einer prospektiven Studie nie erfüllt hätten.
Der Kompromiss besteht darin, dass Real-World-Datensätze verrauschter sind und der Weg von Rohdaten zu modellbereiten Eingaben selten sauber ist. Wie ein Team diese Übersetzung handhabt, prägt, was die berichtete Leistung letztlich bedeutet. Eine große internationale Stichprobe macht die Ergebnisse prinzipiell übertragbarer, aber Übertragbarkeit muss dennoch nachgewiesen und nicht angenommen werden.
Wo KI-Tools üblicherweise ins Stocken geraten
Klinische Nutzbarkeitstests adressieren die Lücke zwischen einem Modell, das funktioniert, und einem Modell, das verwendet wird. Die wiederkehrenden Fehlermodi sind in der klinischen KI gut dokumentiert: Warnungen, die so häufig ausgelöst werden, dass sie verworfen werden, Dashboards, die bereits auf dem Bildschirm vorhandene Informationen duplizieren, und Ausgaben, die eintreffen, nachdem die Entscheidung faktisch bereits getroffen wurde. Ein Entscheidungsunterstützungstool muss sich seinen Platz in einem ohnehin überfüllten Arbeitsablauf verdienen.
Indem die klinische Nutzbarkeit direkt im Titel genannt wird, signalisiert die Studie, dass die Autorinnen und Autoren etwas jenseits von Diskrimination und Kalibrierung gemessen haben. Nutzbarkeitsarbeit fragt typischerweise, ob Klinikerinnen und Kliniker die Ausgabe des Tools interpretieren können, ob sie ihr zustimmen, ob sie ihren angegebenen Plan ändert und ob sie sie verlangsamt. Diese Maße sind schwerer in einer Schlagzeilenzahl zusammenzufassen, was teilweise erklärt, warum sie häufig übersprungen werden.
Fragen, die die Arbeit offen lässt
Mehrere Dinge liegen außerhalb dessen, was eine einzelne Studie dieser Form klären kann. Leistung, gemessen an retrospektiven Outcomes, ist nicht dasselbe wie verbesserte Patientenergebnisse, und Letzteres nachzuweisen erfordert eine prospektive Evaluation. Auch die Qualität von Erklärungen ist schwer zu quantifizieren – ein Modell kann eine Erklärung erzeugen, ohne dass diese Erklärung der Berechnung treu ist, die die Vorhersage hervorgebracht hat. Und die Adoption hängt von institutionellen Faktoren ab, von der Integration in elektronische Akten bis hin dazu, wer die Haftung trägt, wenn eine Empfehlung befolgt wird und das Ergebnis schlecht ist.
Es gibt auch die Frage, wie sich ein solches Tool verhält, wenn sich die Praxis ändert. Behandlungsparadigmen beim NSCLC verschieben sich schnell, wenn neue Wirkstoffe und biomarkerdefinierte Untergruppen auftauchen. Ein Modell, das auf den Entscheidungen einer Ära trainiert wurde, kann Muster kodieren, die Klinikerinnen und Kliniker inzwischen aufgegeben haben.

Warum dies jetzt landet
Lungenkrebs bleibt einer der folgenreichsten Bereiche für Entscheidungsunterstützung, weil die Zahl plausibler Behandlungswege schneller gewachsen ist als die Zeit, die zur Verfügung steht, um jeden Fall zu durchdenken. Multimodale Modelle versprechen, diese Argumentation zu komprimieren; Erklärbarkeit und Nutzbarkeit bestimmen, ob die Komprimierung vertrauenswürdig ist. Diese Kombination aus Modellbewertung und klinischer Nutzbarkeitsbewertung an einem hochkarätigen Ort zu veröffentlichen, setzt ein Zeichen: Das Feld wird zunehmend aufgefordert zu zeigen, nicht nur dass ein Modell gut vorhersagt, sondern dass eine Klinikerin oder ein Kliniker damit arbeiten kann. Der nächste Test ist, ob Tools dieser Art standhalten, wenn sie prospektiv in den Kliniken eingesetzt werden, die sie nutzen würden.
Dieser Artikel basiert auf einer Berichterstattung von Nature Medicine. Lesen Sie den Originalartikel.
Originally published on nature.com