রোবটের জন্য আরও বিস্তৃত ডেটা ভিত্তি তৈরি
Rhoda AI একটি সরল কিন্তু উচ্চাভিলাষী ধারণা অনুসরণ করছে: সতর্কভাবে নিয়ন্ত্রিত প্রদর্শনের বাইরে রোবটকে নির্ভরযোগ্যভাবে কাজ করাতে হলে তাদের প্রশিক্ষণ ডেটার আরও বড় এবং বৈচিত্র্যময় উৎস দরকার। কোম্পানিটি ইন্টারনেট-স্কেল ভিডিও ব্যবহার করে এমন মডেল তৈরি করছে, যেগুলোর লক্ষ্য গতি, পদার্থবিদ্যা ও শারীরিক মিথস্ক্রিয়া বোঝা; এরপর সেই পূর্বজ্ঞান রোবোটিক্সে প্রয়োগ করা।
2026 সালের শুরুতে 18 মাস গোপনে কাজ করার পর Rhoda 450 মিলিয়ন ডলারের Series A তহবিল নিয়ে আত্মপ্রকাশ করে। কোম্পানিটি বলছে, অটোমোটিভ, উৎপাদন, লজিস্টিক্স ও ই-কমার্স খাতের গ্রাহকদের সঙ্গে তাদের direct video action, বা DVA, মডেল মোতায়েনের জন্য কাজ করছে।
যে সমস্যাটি তারা সমাধান করতে চাইছে, তা রোবোটিক্সে সুপরিচিত। একটি যন্ত্র পরীক্ষাগারে চমৎকার কাজ করতে পারে, কিন্তু বাস্তব ব্যবহারে নানা পরিবর্তন থাকে: বস্তু ভিন্ন ভিন্ন স্থানে আসে, কর্মক্ষেত্র বদলে যায় এবং প্রতিটি কাজ আলাদাভাবে এগোতে পারে। Rhoda-র সহ-প্রতিষ্ঠাতা ও CEO Jagdeep Singh বলেন, এই অগোছালো বাস্তবতা সামলাতে শক্তিশালী মডেল দরকার, আর সেই শক্তির জন্য দরকার বিশাল প্রশিক্ষণ ডেটাসেট।
এই পদ্ধতিতে ভিডিও কেন কেন্দ্রীয়
Large language models দ্রুত এগিয়েছে আংশিকভাবে এই কারণে যে তারা বিপুল পরিমাণ টেক্সট থেকে শিখতে পারে। শারীরিক মিথস্ক্রিয়ার ক্ষেত্রে রোবোটিক্সের কাছে এর সমতুল্য কোনো ইন্টারনেট-স্কেল ডেটা উৎস নেই। ভাষার ডেটার প্রাচুর্যের সঙ্গে রোবটের জন্য উপলব্ধ তুলনামূলকভাবে সীমিত ডেটার পার্থক্য তুলে ধরেছেন Singh।
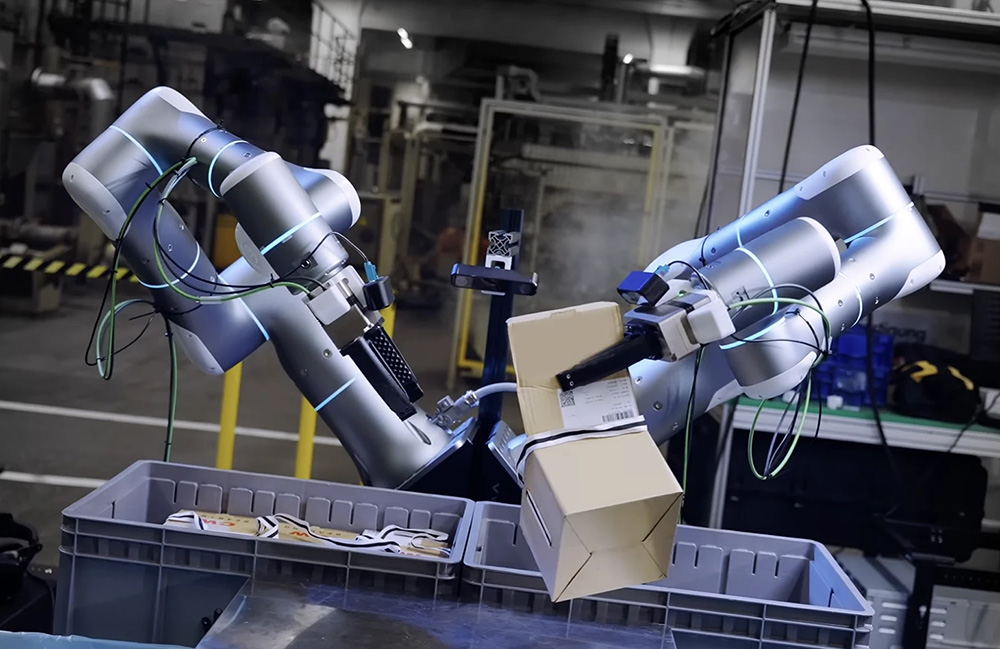
ঐতিহাসিকভাবে, ডেভেলপাররা টেলিওপারেশনের মাধ্যমে রোবট ডেটা সংগ্রহের চেষ্টা করেছেন: মানুষ রোবট নিয়ন্ত্রণ করে, আর সিস্টেম সেই প্রদর্শন রেকর্ড করে। এই পদ্ধতিতে রোবটের টি-শার্ট ভাঁজ করা বা কফি বানানোর মতো আকর্ষণীয় উদাহরণ তৈরি হতে পারে। কিন্তু Rhoda-র যুক্তি হলো, বাস্তব পরিবেশে শক্তিশালী স্বায়ত্তশাসিত ম্যানিপুলেশনের জন্য যে পরিমাণ ও বৈচিত্র্য দরকার, শুধু প্রদর্শন তা দিতে পারেনি।
ভিডিও এই ব্যবধান কমাতে পারে—এটাই Rhoda-র বাজি। ভিডিওতে গতি, বস্তুর সঙ্গে মিথস্ক্রিয়া এবং পরিবর্তনশীল দৃশ্যের এমন বিপুল উদাহরণ থাকে, যা কেবল বিশেষভাবে রোবট ডেটা সংগ্রহ করে পুনরুৎপাদন করা কঠিন। কোম্পানিটি রোবোটিক ব্যবহারের জন্য মডেল অভিযোজিত করার আগে ভিডিও দিয়ে সেগুলো প্রিট্রেন করে।
ডাইরেক্ট ভিডিও অ্যাকশন কীভাবে কাজ করে
অনেক physical-AI ডেভেলপার vision-language-action, বা VLA, মডেল নিয়ে কাজ করছেন। এই সিস্টেমগুলো রোবটের আশপাশের ছবি বা ভিডিওর সঙ্গে টেক্সট নির্দেশনা ব্যবহার করে। Rhoda বলছে, তাদের DVA মডেল সম্পর্কিত কিন্তু স্বতন্ত্র একটি ক্রমের ওপর তৈরি: এটি ভিডিও ফ্রেমের ইতিহাস, অ্যাকশন টোকেন ও ভাষার টোকেন গ্রহণ করে, নিকট ভবিষ্যতের একটি ভিডিও দৃশ্যের পূর্বাভাস দেয় এবং সেই পূর্বাভাসকে রোবটের কাজে রূপান্তর করে।
Singh-এর বর্ণনা অনুযায়ী, মডেলটি পরবর্তী কয়েকশ মিলিসেকেন্ডে, অর্থাৎ প্রায় পরবর্তী অর্ধ সেকেন্ডে, দৃশ্যে কী ঘটবে তা পূর্বাভাস দেয়। দ্বিতীয় উপাদান, action converter, সেই পূর্বাভাসিত দৃশ্য নিয়ে রোবটের জন্য কাজ তৈরি করে।
এই নকশার উদ্দেশ্য হলো ভিডিও পূর্বাভাসকে রোবটের পরবর্তী পদক্ষেপের মধ্যবর্তী উপস্থাপনা হিসেবে ব্যবহার করা। কোনো perception-and-language ইনপুটকে সরাসরি কমান্ডে রূপান্তর করার বদলে, সিস্টেম প্রথমে পরিস্থিতির সম্ভাব্য শারীরিক ধারাবাহিকতা মডেল করে এবং পরে তা এমন একটি action space-এ অনুবাদ করে, যা রোবট কার্যকর করতে পারে।
গতিশীলতা ও ম্যানিপুলেশন একত্র করা
Rhoda সম্প্রতি mobile DVA দিয়ে এই পদ্ধতি সম্প্রসারিত করেছে। কোম্পানির দাবি, এটি একটি policy-র মধ্যে ম্যানিপুলেশন ও গতিশীলতাকে একত্র করে। যেসব ব্যবহারে রোবটকে কোনো নির্দিষ্ট অবস্থান থেকে কাজ না করে একটি স্থাপনার ভেতর চলাফেরা এবং বস্তুর সঙ্গে মিথস্ক্রিয়া—দুটিই করতে হয়, সেখানে এটি গুরুত্বপূর্ণ।
অটোমোটিভ, উৎপাদন, লজিস্টিক্স ও ই-কমার্সের পরিবেশ এই ধরনের সিস্টেমের স্বাভাবিক লক্ষ্য, কারণ সেখানে পুনরাবৃত্তিমূলক কাজের পাশাপাশি প্রতিদিনের উল্লেখযোগ্য পরিবর্তনও থাকে। বিভিন্ন বিন্যাস সামলাতে সক্ষম একটি মডেল শক্তভাবে স্ক্রিপ্ট করা সেটআপকে কেন্দ্র করে তৈরি মডেলের চেয়ে বেশি কার্যকর হতে পারে।
Rhoda-র দাবিগুলোকে তার প্রযুক্তিগত কৌশল ও মোতায়েনের উচ্চাকাঙ্ক্ষার বিবরণ হিসেবে দেখা উচিত; সাধারণীকৃত রোবোটিক্সের সমস্যা সমাধান হয়ে গেছে—এমন স্বাধীনভাবে প্রতিষ্ঠিত প্রমাণ হিসেবে নয়। কোম্পানিটি নিজেই বাস্তব জগতের পরিবর্তনশীলতাকে মূল সমস্যা হিসেবে তুলে ধরছে। অর্থাৎ, পরিবর্তনশীল পরিবেশ, বস্তু ও পরিচালন পরিস্থিতিতে মডেল কীভাবে আচরণ করে, তার ওপর বাস্তব কর্মদক্ষতা নির্ভর করবে।
রোবোটিক্সের বৃহত্তর প্রশ্ন
কোম্পানির পদ্ধতি রোবোটিক্সে foundation-model-style প্রশিক্ষণের দিকে একটি বৃহত্তর পরিবর্তনকে প্রতিফলিত করে। বিস্তৃত ডেটা থেকে পুনর্ব্যবহারযোগ্য একটি prior তৈরি করে তা দিয়ে নির্দিষ্ট কাজের সিস্টেমকে আরও অভিযোজ্য করে তোলাই লক্ষ্য। এই ক্ষেত্রে foundational material হলো টেক্সট নয়, শারীরিক কর্মকাণ্ডের ভিডিও।
এই কৌশল আকর্ষণীয়, কারণ শারীরিক সিস্টেমকে এমন সব বিবরণ সামলাতে হয়, যা কোনো প্রদর্শনে সহজেই উপেক্ষিত হতে পারে। আলো বদলে যায়, বস্তু সরে যায়, পৃষ্ঠ ভিন্ন হয় এবং একই কাজের জন্য প্রতিবার সামান্য ভিন্ন প্রতিক্রিয়া দরকার হতে পারে। গতি ও মিথস্ক্রিয়ার বিস্তৃত ভিজ্যুয়াল উদাহরণ আত্মস্থ করা একটি মডেল নীতিগতভাবে শারীরিকভাবে সম্ভাব্য বিষয় সম্পর্কে আরও শক্তিশালী প্রত্যাশা নিয়ে শুরু করতে পারে।
এই প্রত্যাশা নির্ভরযোগ্য রোবটে রূপ নেয় কি না, সেটিই হবে বাস্তব পরীক্ষা। কারখানা, গুদাম ও অন্যান্য পরিচালন পরিবেশে বৃহৎ পরিসরের ভিডিও বোঝাপড়াকে কার্যকর কাজে রূপান্তরের উপায় হিসেবে Rhoda DVA-কে তুলে ধরছে। এর অগ্রগতি মাপা হবে কোনো একক পালিশ করা প্রদর্শনে নয়, বরং পৃথিবী যখন নিজেকে হুবহু পুনরাবৃত্তি করতে অস্বীকার করে, তখন রোবট কাজ চালিয়ে যেতে পারে কি না—তার ভিত্তিতে।
এই নিবন্ধটি The Robot Report-এর প্রতিবেদন অবলম্বনে লেখা। মূল নিবন্ধটি পড়ুন।
Originally published on therobotreport.com