太阳系中最难的停车任务
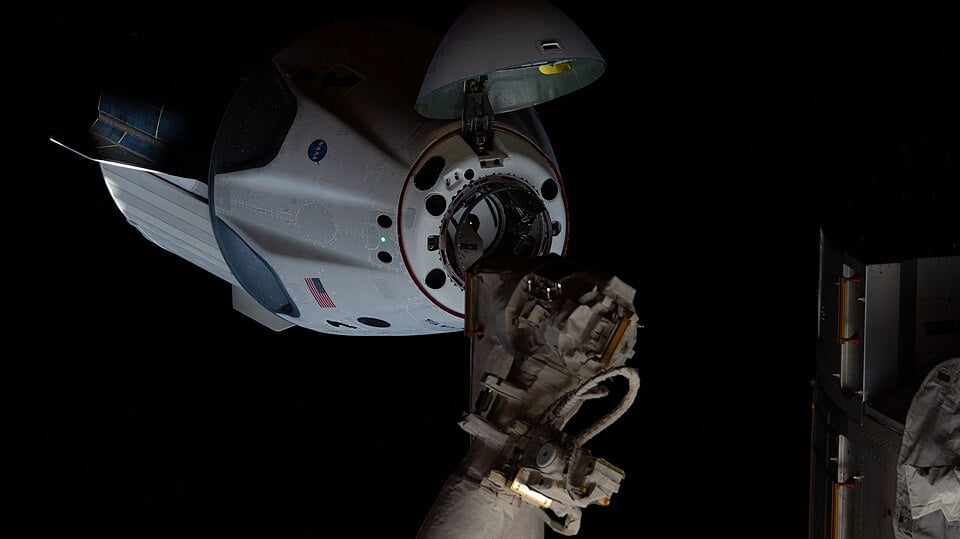
在动画中,航天器与国际空间站对接看起来像一场缓慢而优雅的芭蕾。现实却更接近一场高风险的物理噩梦。空间站以约每小时28,000公里的速度绕轨飞行,接近的飞船必须在滑入对接端口的同时匹配这一速度,而容差以厘米计。正如Universe Today撰稿人Andy Tomaswick所说,这就像在高速公路上以每小时28,000公里的速度行驶,同时侧方停入一座以同样速度移动、价值数十亿美元的实验室上的车库。
轨道力学还带来了地球上驾驶员从未面对的残酷转折。如果飞行员试图向前加速,航天器实际上会向上漂移。没有空气阻力来自然减慢飞行器。而失败的后果是灾难性的:碰撞可能杀死来访飞船和空间站上的所有人,由此产生的碎片场可能威胁数十颗卫星,甚至地面人员。
几十年来,航空航天工程师一直依赖硬编码的物理方程和人类飞行员来修正它们。如今,斯坦福大学研究人员的一篇新预印本论文(可在arXiv上获取)提出了另一种方法。该团队正在构建一种AI,它能执行一系列“心理模拟”——他们表示,这种能力可能从根本上改变未来航天器之间的交互方式。他们的系统被称为Out-of-this-World Model,简称OWM。
当今航天器如何对接——以及它在何处失灵
要理解OWM为何重要,有必要了解在低地球轨道(LEO)中导航的传统工具包。传统导航计算机运行制导、导航与控制(GNC)算法。它们还使用一种名为扩展卡尔曼滤波器的数学工具,该工具接收来自GPS接收器和星跟踪器的数据,并输出操纵飞行器所需的推进器点火占空比。
卡尔曼滤波器与视频问题
卡尔曼滤波器功能强大,但在处理高速视频方面表现糟糕。这一局限促使工程师转向传统的计算机视觉技术。然而在太空中,这些技术面临一个严重障碍:它们很脆弱。如果阳光从太阳能电池阵列上反射,或者目标的一部分突然被阴影覆盖,计算机视觉算法可能会完全失灵。前一秒还清晰可见的对接端口,下一秒可能变成无法识别的形状。
为什么强化学习会受挫
机器学习听起来像是完美的解决方案,研究人员也尝试过。他们开始应用强化学习(RL)算法——正是这类方法曾教会计算机在国际象棋和Dota中获胜。但RL有一个狭窄的舒适区:当规则固定且具体时,它表现出色。改变规则,比如翻转国际空间站对接端口所在的一侧,算法就不知道该怎么办了。在一种配置中完美运行的对接机动,在另一种配置中可能完全失败。
Out-of-this-World Model登场
斯坦福团队的答案是“世界模型”。世界模型不是记住单一规则集,也不依赖脆弱的特征检测,而是构建环境的内部表示,并用它来运行心理模拟。航天器实际上可以梦见可能的未来——想象其推进器将如何改变轨迹、空间站旋转时会如何呈现、光照条件可能如何变化——然后再决定是否点火。
这是对经典GNC和纯RL两者的重大偏离。经典算法依赖必须为每次任务调校的手工方程。RL智能体依赖在狭窄领域中的大量训练。世界模型旨在泛化:通过学习世界如何运作的预测模型,它可以在场景变化时适应,例如不同的对接端口朝向或意外阴影。
棒球类比:不靠方程思考
研究人员用一个与火箭无关的类比来解释这个概念:棒球或板球运动员接高飞球。当外野手移动接球时,他们不会立即开始求解偏微分方程。相反,他们依赖对球将如何飞行的直觉预测模型——一种由经验构建的心理模拟。他们奔跑、调整并截住球,却从未在纸上计算轨迹。
世界模型为航天器提供了类似的东西。AI不必在每一步都显式求解轨道运动方程,而是可以在内部模拟结果。它可以通过对接进近“做梦”,用学到的物理和感知模型测试假设动作。如果心理模拟预测会发生碰撞或错过对准,系统可以在真实世界中机动出错之前进行调整。
这对未来航天器可能意味着什么
其影响不止于与国际空间站对接。随着越来越多航天器自主运行——维修卫星、在轨组装结构,或在拥挤的轨道通道中导航交通——对新颖情境进行推理的能力变得至关重要。硬编码方程和脆弱的计算机视觉可能无法扩展到这样一个未来:飞行器必须合作、避开碎片,并适应工程师未曾完全预料的条件。
斯坦福的论文是预印本,意味着它尚未经过同行评审,而且源文本没有详细说明OWM的架构、训练数据或性能基准。但核心思想很有说服力:教航天器构建其世界的心理模型,然后让它们在点火前先在头脑中练习。如果奏效,对接可能不再是一场令人手心冒汗的侧方停车,而更像例行操作——航天器已经想象过进近可能出错的千百种方式,并找到了通过之路。
目前,这个问题仍然像以往一样艰巨。在每小时28,000公里的速度下匹配速度、补偿轨道漂移并避免灾难性碰撞,并非一夜之间就能消失的挑战。但斯坦福研究人员押注,下一代航天器不会只靠计算抵达空间站。它们将靠做梦抵达那里。
本文基于Universe Today的报道。阅读原文。
Originally published on universetoday.com