OpenAI 正在组建一支劳动力队伍,其工作就是阅读人们在 ChatGPT 中输入的内容。404 Media 的报道显示,该公司正在招聘数百名承包商来处理大量真实用户提示词——这些对话是这款聊天机器人超过 9 亿用户通常认为只存在于他们与机器之间的。
该媒体查阅的并非一份泄露的备忘录,而是一整套纸质记录:内部指导手册、审核团队使用的 Slack 频道、真实的 ChatGPT 提示词,以及承包商用来给模型回复打分的评分标准。其中大部分材料都处于该媒体所称的“Project Lily”内部横幅之下,它揭示了 AI 开发中很少出现在发布博客文章里的一面。
提示词审核流水线内部
从纸面上看,这些团队的目的很直接。承包商阅读真实用户提交的提示词,然后对 ChatGPT 生成的回答进行评分和批评。这些反馈会被循环回训练过程,塑造模型下一次收到类似请求时的行为方式。
其范围比孤立的一行问题更广。审核员可能会看到用户与聊天机器人之间的完整对话,这意味着整个来回交流——追问、纠正、沿途自愿提供的细节——都可能从一个人眼前经过。指导手册对什么算作高质量输出设定了严格标准,将优秀回答描述为能够理解用户真实意图、提供准确有用的帮助,并且读起来清晰自然,带有适当程度的温度。
数量本身就是关键。数百名审核员处理源源不断的提示词,意味着真实对话正在被大规模消费,而不是偶尔抽样抽查。对于一家产品每天处理海量查询的公司来说,这一人工层已成为改进循环中的常设部分,而非一次性审计。

数亿用户的隐私盲区
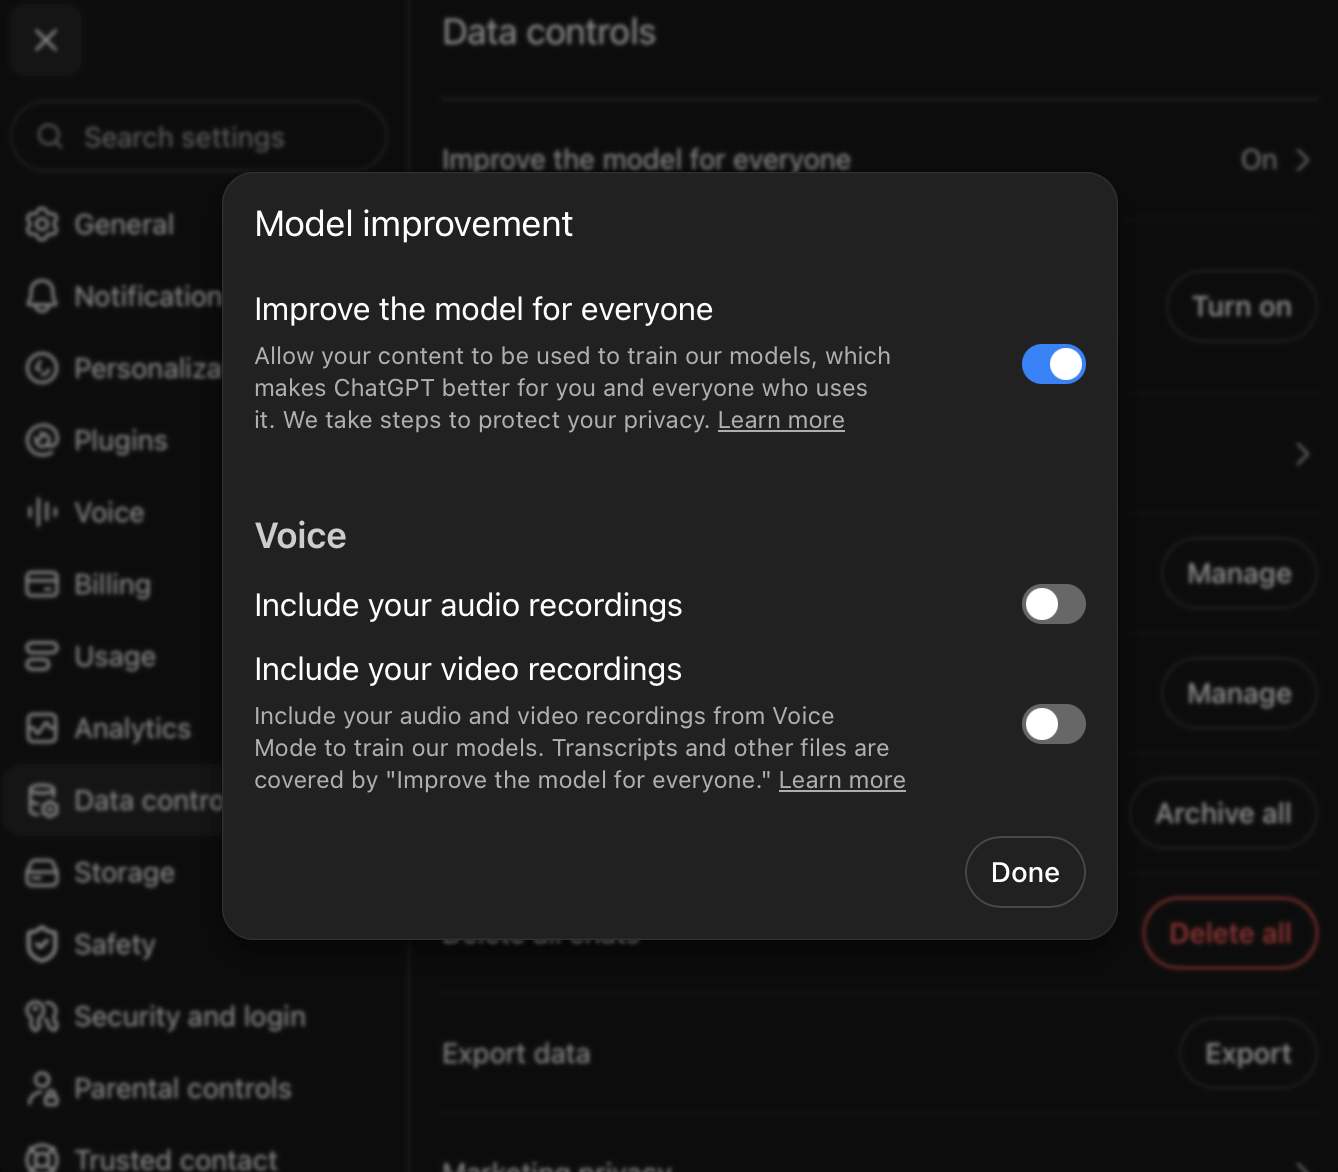
OpenAI 不会向审核员提供用户名,该公司也表示会努力在提示词到达人工审核之前剥离个人细节。但该公司承认,敏感信息仍可能在过滤后留存下来,并传递到阅读者手中。
这种区别在实践中至关重要。账户层面的匿名并不等同于实质上的匿名。如果一条提示词描述的是诊断、离婚、债务、职场冲突或私人恐惧,那么识别价值存在于内容本身,而不是附加在其上的用户名。
而人们带来的恰恰就是这些内容。ChatGPT 已成为心理咨询师的沙发、专业助手,在某些情况下还是数字伴侣。用户经常交出关于自身健康、人际关系、金钱和担忧的私密细节——往往正是因为这种互动感觉私密、即时且无人观察。
“我不认为他们会想到”
认知与现实之间的差距正是这篇报道的核心。当被问及他是否认为 ChatGPT 用户明白人类可能会阅读他们的对话时,一位从事提示词相关工作的人直言不讳。他说不会,并补充说用户不会想到某个地方的某个承包商会分析这些对话。
这种预期从表面上看是合理的。大多数与聊天窗口互动的人看不到任何明显信号,表明之后可能会有人作为质量改进计划的一部分浏览他们的文字。为模型调优而阅读提示词,并不像新功能或安全政策更新那样被宣传。

谄媚、拟人化与真实伤害
内部文件还揭示了审核员被要求纠正的内容。据报道,承包商接受培训,要引导 ChatGPT 避免拟人化自身——即把自己呈现为仿佛有感情或有持续内心生活的人——并减少其谄媚倾向,即反射性地奉承和认同用户,而不是提出异议。
这些并非表面上的小毛病。OpenAI 的 4o 模型中过度谄媚已被诉讼引用为多起自杀事件的促成因素。当一个系统被调校为认可一个人所说的一切时,其下游后果可能远远超出令人略感恼火的聊天机器人回复。人工审核层在一定程度上正是为了削弱这种失败模式。
与安全审核不是一回事
有必要将这项工作与 OpenAI 公开描述的安全措施区分开来。这些措施包括当公司检测到用户似乎计划伤害他人时审查聊天记录——这是一种狭窄的、以危机为导向的干预。
承包商进行的提示词审核完全是另一项职能,针对的是日常回答质量,而非紧急情况检测。正因如此,它才触及如此多普通对话。一个请求帮助起草一封难写的消息或梳理个人决定的用户并未处于危机之中,也没有理由预期受到审查,然而他们的交流却可能进入审核队列。

Anthropic 证实存在同样做法
OpenAI 并非唯一采取这种方式的公司。Anthropic 向 404 Media 证实,它也使用人工审核来改进其模型,这表明阅读真实用户互动是一种行业做法,而非某家公司孤立的实验。这一发现使任何认为更换提供商就能解决根本隐私问题的假设变得更加复杂。
“改进”幻象背后的劳动
这篇报道还挑战了关于 AI 模型为何不断变好的流行解释。通常的说法归功于对互联网文本的大规模抓取、高薪的工程和研究人才,以及一代又一代能力更强的架构。
所有这些都很重要,但它们遗漏了某种更安静且经常被忽视的东西:付钱给外部承包商,让他们一遍又一遍、大规模地阅读和评价真实的 ChatGPT 回复。这种人类劳动是产品的一项有意义的投入,而它基本上处于关于前沿系统如何进步的公共叙事之外。
用户应该从中得到什么
- ChatGPT 不是保密渠道。提示词可能会被从事模型改进的人工承包商阅读。
- 移除用户名并不能移除上下文。用户自愿提供的细节本身就可能具有识别性。
- 按 OpenAI 自己的承认,脱敏并不完美——敏感信息仍可能到达审核员手中。
- 这种做法不止一家公司,Anthropic 也证实存在类似的人工审核。
- 与安全相关的聊天审核和与质量相关的提示词审核是两套不同的项目,后者会触及日常对话。
这一切并不会自动使这种做法变得不正当。改进一个数亿人依赖其回答严肃问题的系统,需要某种形式的反馈,而人类判断仍然是现有最有效的工具之一。问题在于,这种权衡是否以用户能够真正评估的方式被披露。
目前,答案似乎是否定的。一个人在聊天框中输入忏悔、医疗问题或职业危机时,并不会被告知审核队列中的某个承包商可能会读到它。弥合这一差距——通过更清晰的告知、更强的去标识化或更严格的过滤——是行业现在面临的考验,而评判标准将是用户在点击发送之前被允许知道多少。
本文基于 404 Media 的报道。阅读原文。
Originally published on 404media.co