एजेंटिक AI वहाँ पहुँच रहा है जहाँ गलतियाँ मरीज़ों में नापी जाती हैं
चिकित्सा कृत्रिम बुद्धिमत्ता को पारंपरिक रूप से एक नैदानिक परीक्षण की तरह आँका जाता रहा है। एक मॉडल को डेटासेट पर प्रशिक्षित किया जाता है, एक अलग रखे गए नमूने पर चिकित्सकों के विरुद्ध बेंचमार्क किया जाता है, और संवेदनशीलता, विशिष्टता या शुद्धता के किसी अन्य मापदंड पर स्कोर किया जाता है। यह पूरा दृष्टिकोण एक धारणा पर टिका है: मॉडल एक आउटपुट देता है, और एक इंसान उसकी व्याख्या करता है।
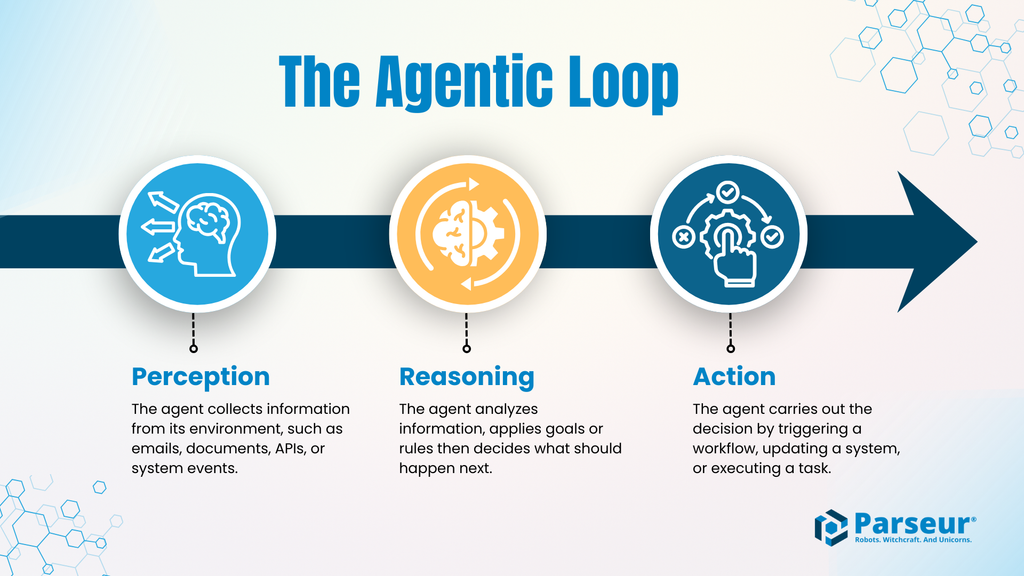
एजेंटिक AI इस धारणा को तोड़ देता है। ये सिस्टम कई चरणों में लक्ष्यों का पीछा करने के लिए बनाए जाते हैं — रिकॉर्ड निकालना, टेस्ट ऑर्डर करना, दस्तावेज़ीकरण का मसौदा तैयार करना, फ़ॉलो-अप शेड्यूल करना, और नई जानकारी आने पर योजना को संशोधित करना। 2 अक्टूबर 2026 को नेचर मेडिसिन में प्रकाशित "The missing links in agentic AI autonomy" शीर्षक वाला एक पेपर इससे पैदा होने वाली खाई पर निशाना साधता है। इसका विषय मॉडल की सटीकता नहीं, बल्कि भरोसा है: विशेष रूप से वह परिचालनात्मक और निर्णयात्मक भरोसा जो स्वायत्त सिस्टमों को देखभाल में सार्थक रूप से भाग लेने की अनुमति देने से पहले मौजूद होना चाहिए।
यह ढाँचा जानबूझकर उस तरीके से अलग हटता है जिस तरह से क्षेत्र आमतौर पर AI सुरक्षा पर बहस करता है। अधिकांश चर्चाएँ भरोसे को प्रदर्शन का एक परिणाम मानती हैं — बेहतर मॉडल बनाइए, और भरोसा अपने आप आ जाएगा। यह पेपर सुझाव देता है कि रिश्ता दूसरी दिशा में भी चलता है: ऐसी संरचनाओं के बिना जो भरोसे को मापने योग्य और अर्जित बनाएँ, उत्कृष्ट मॉडलों को भी सुरक्षित रूप से सौंपा नहीं जा सकता।
भरोसा दो तरह का, एक नहीं
पेपर की सबसे उपयोगी चाल भरोसे को दो श्रेणियों में बाँटना है। यह अंतर मायने रखता है क्योंकि दोनों बहुत अलग तरीकों से विफल होते हैं, और इन्हें एक मान लेने से यह छिप जाता है कि असली समस्याएँ कहाँ हैं।
परिचालनात्मक भरोसा
परिचालनात्मक भरोसा इस बारे में है कि कोई सिस्टम जिस माहौल में वास्तव में तैनात है, वहाँ विश्वसनीय रूप से वही करता है जो वह करने का दावा करता है। क्या वह सही डेटा स्रोतों तक पहुँच सकता है? जब कोई रिकॉर्ड गायब हो, कोई क्वेरी टाइम आउट हो जाए, या कोई इंटरफ़ेस बदल जाए, तो क्या वह शालीनता से विफल होता है? क्या वह ऐसे तरीकों से क्षीण होता है जो निगरानी करने वाला इंसान देख सके, या चुपचाप आत्मविश्वास भरा बेतुका आउटपुट देता रहता है? ये इंजीनियरिंग के सवाल लगते हैं, लेकिन नैदानिक सेटिंग में इनका नैदानिक महत्व होता है। जो सिस्टम चुपचाप एक लैब परिणाम खो देता है, वह केवल खराबी वाला नहीं है; वह संभावित रूप से हानिकारक है।
निर्णयात्मक भरोसा
निर्णयात्मक भरोसा अधिक संकीर्ण और स्थापित करना कठिन है। यह इस बारे में है कि किसी सिस्टम के निर्णय — कौन-सी कार्रवाई करनी है, किस क्रम में, और सबसे महत्वपूर्ण, कब रुकना है — भरोसे के योग्य हैं या नहीं। कोई सिस्टम परिचालनात्मक रूप से निर्दोष हो सकता है और फिर भी ऐसे निर्णय ले सकता है जिन्हें कोई चिकित्सक सिरे से खारिज कर दे। इसके विपरीत, कमज़ोर ढाँचे वाला सिस्टम एक संकीर्ण खिड़की में अच्छी तरह तर्क कर सकता है जहाँ कुछ नहीं टूटता। इन दोनों को एक ही चर मानना, जैसा कि मौजूदा बहस का बड़ा हिस्सा करता है, इस तथ्य को धुँधला कर देता है कि एक को ठीक करने से दूसरे के लिए कुछ नहीं होता।

स्वायत्तता जोखिम की गणना क्यों बदल देती है
एक पारंपरिक नैदानिक AI टूल किसी वर्कफ़्लो के भीतर बैठा रहता है और इंतज़ार करता है। वह एक सवाल का जवाब देता है और जवाब की समीक्षा हो जाती है। एजेंटिक सिस्टम कुछ अलग करते हैं: वे एक सूत्र थामे रहते हैं। वे मध्यवर्ती चुनाव करते हैं, जिनमें से कुछ परिणामकारी होते हैं, और वे चुनाव संचयी होते जाते हैं। नाममात्र रूप से प्रभारी व्यक्ति को अंत में केवल सारांश दिख सकता है।
यही संचयन भरोसे के सवाल को दार्शनिक के बजाय तात्कालिक बनाता है। बिना किसी चेकपॉइंट के सिस्टम जितना अधिक कदम उठाता है, उतने ही अधिक स्थान बनते हैं जहाँ त्रुटि घुस सकती है और उतने ही अधिक आगे के निर्णय उसे विरासत में पा लेते हैं। एकल भविष्यवाणी के लिए काम करने वाली मानवीय निगरानी अपने आप दोपहर भर में उठाए गए दस कार्रवाइयों की श्रृंखला तक नहीं बढ़ती।
स्वास्थ्य सेवा इसे और तीव्र कर देती है क्योंकि यह क्षेत्र उन विफलता विधाओं के प्रति असामान्य रूप से कठोर है जो एजेंटिक सिस्टम सबसे आसानी से दिखाते हैं: अति-आत्मविश्वास, विश्वसनीय लगने वाली मनगढ़ंत, और अपनी ही योग्यता की सीमा को पहचानने में कठिनाई। कोई चैटबॉट जो एक उद्धरण गढ़ लेता है, शर्मिंदगी की बात है। कोई सिस्टम जो एक दवा अंतःक्रिया गढ़ लेता है और उस पर कार्रवाई कर देता है, बिल्कुल अलग बात है।
छूटी हुई कड़ियाँ
यदि पेपर का तर्क यह है कि स्वायत्तता के लिए क्षमता से अधिक कुछ चाहिए, तो अगला स्वाभाविक सवाल यह है कि वास्तव में क्या अनुपस्थित है। पेपर जिस भूभाग को कवर करता है, उसमें कई अंतराल बार-बार आते हैं।
- कार्य से मेल खाता मूल्यांकन। स्थिर बेंचमार्क एकल उत्तर मापते हैं, निर्णयों के क्रम नहीं। यह आँकने की कोई परिपक्व प्रथा नहीं है कि किसी एजेंट की योजना उचित थी या नहीं, केवल यह कि उसका अंतिम आउटपुट किसी संदर्भ से मेल खाता था या नहीं।
- तर्क की लेखा-परीक्षा योग्यता। जब कोई सिस्टम कोई कार्रवाई करता है, तो उसके ऐसा करने का कारण का रिकॉर्ड अक्सर पतला होता है या बाद में पुनर्निर्मित किया जाता है। विश्वसनीय ट्रेस के बिना, निगरानी एक तमाशा बन जाती है।
- सुस्पष्ट एस्केलेशन। एजेंटिक सिस्टमों को स्पष्ट, विश्वसनीय बिंदुओं की आवश्यकता होती है जहाँ वे नियंत्रण वापस इंसान को सौंप दें। बहुत अधिक हैंडऑफ़ सिस्टम को बेकार बना देते हैं; बहुत कम उसे खतरनाक बना देते हैं, और सही सीमा संदर्भ पर निर्भर करती है।
- स्वायत्तता का पूर्वानुमान करने वाला शासन। उपकरणों और निदानों के इर्द-गिर्द बने नियामक ढाँचे ऐसे सिस्टमों पर सफ़ाई से लागू नहीं होते जिनका व्यवहार हर तैनाती संदर्भ के साथ बदलता है।
- साझा परिभाषाएँ। परिचालनात्मक बनाम निर्णयात्मक भरोसे की परिभाषा पर सहमत शब्दावली के बिना, संस्थान आपस में तुलना नहीं कर सकते, और हर तैनाती अलग-थलग अपने मानक फिर से गढ़ती है।

अर्जित स्वायत्तता वास्तव में कैसी दिखेगी
पेपर का अंतर्निहित नुस्खा यह है कि स्वायत्तता क्रमशः और साक्ष्य के आधार पर दी जानी चाहिए, बेंचमार्क स्कोर से मान नहीं ली जानी चाहिए। इसका तात्पर्य संस्थागत आदतों के एक काफ़ी माँग करने वाले समूह से है।
- ऐसी तैनातियाँ जो संकीर्ण, प्रतिवर्ती कार्रवाइयों से शुरू हों और साक्ष्य जमा होने पर ही दायरा बढ़ाएँ।
- ऐसी निगरानी जो समय के साथ निर्णय की गुणवत्ता पर नज़र रखे, केवल अपटाइम और लेटेंसी पर नहीं।
- स्पष्ट जवाबदेही: जब कोई स्वचालित कार्रवाई नुकसान पहुँचाए तो एक नामित इंसान या समिति ज़िम्मेदार हो।
- इतना कठोर दस्तावेज़ीकरण कि एक स्वतंत्र समीक्षक यह पुनर्निर्मित कर सके कि क्या हुआ और क्यों।
इसमें कुछ भी चमकदार नहीं है। यह वह जोड़ने वाला ऊतक है जो एक सक्षम सिस्टम को भरोसेमंद बनाता है, और यह ठीक वही परत है जिसे अक्सर छोड़ दिया जाता है जब अंतर्निहित मॉडल उत्साह पैदा करने के लिए पर्याप्त प्रभावशाली होता है।
असहज निष्कर्ष
नेचर मेडिसिन पेपर का सबसे चुनौतीपूर्ण निहितार्थ यह है कि एजेंटिक AI स्वायत्तता में छूटी कड़ियाँ शायद तकनीकी ही न हों। बेहतर मॉडल परिचालनात्मक भरोसा हासिल करना आसान बना देंगे — तेज़, अधिक विश्वसनीय, कम नाज़ुक। लेकिन निर्णयात्मक भरोसा उन सवालों पर निर्भर करता है जिन्हें कोई आर्किटेक्चर हल नहीं करता: जवाबदेह कौन है, स्वीकार्य जोखिम क्या माना जाए, कितनी निगरानी पर्याप्त है, और यह तय करने का अधिकार किसे है।
ये संस्थागत और नैदानिक सवाल हैं, और स्वास्थ्य सेवा के पास मानव चिकित्सकों के लिए इनका जवाब देने का दशकों का कठिनाई से अर्जित अनुभव है। आगे का काम उस अनुभव को ऐसे सिस्टमों तक बढ़ाना है जो केवल जवाब देने के बजाय कार्य करते हैं। जब तक ऐसा नहीं होता, चिकित्सा में अधिकांश एजेंटिक AI का ईमानदार वर्णन स्वायत्त नहीं है। वह अनिरीक्षित है, जो बिल्कुल अलग बात है।
यह लेख नेचर मेडिसिन की रिपोर्टिंग पर आधारित है। मूल लेख पढ़ें।
Originally published on nature.com