OpenAI एक ऐसी कार्यबल तैयार कर रहा है जिसका काम यह पढ़ना है कि लोग ChatGPT में क्या टाइप करते हैं। 404 Media की रिपोर्टिंग से पता चलता है कि कंपनी असली उपयोगकर्ता प्रॉम्प्ट की भारी धारा पर काम करने के लिए सैकड़ों कॉन्ट्रैक्टर नियुक्त कर रही है — ऐसी बातचीत जिसे चैटबॉट के 90 करोड़ से अधिक उपयोगकर्ता आम तौर पर यह मानकर चलते हैं कि वह उनके और मशीन के बीच ही रहती है।
इस आउटलेट ने जो समीक्षा किया वह कोई एक लीक हुआ मेमो नहीं था, बल्कि एक पूरा कागज़ी रिकॉर्ड था: आंतरिक निर्देश गाइड, समीक्षा टीमों द्वारा उपयोग किए जाने वाले Slack चैनल, असली ChatGPT प्रॉम्प्ट, और वह स्कोरिंग रूब्रिक जो कॉन्ट्रैक्टर मॉडल के जवाबों को ग्रेड करने के लिए लागू करते हैं। उस सामग्री का अधिकांश हिस्सा एक आंतरिक बैनर के तहत है जिसे आउटलेट "प्रोजेक्ट लिली" कहता है, और यह AI विकास के उस पक्ष को उजागर करता है जो लॉन्च ब्लॉग पोस्ट में शायद ही कभी दिखाई देता है।
प्रॉम्प्ट समीक्षा पाइपलाइन के अंदर
कागज़ पर इन टीमों का उद्देश्य सीधा-सरल है। कॉन्ट्रैक्टर असली उपयोगकर्ताओं द्वारा सबमिट किए गए प्रॉम्प्ट पढ़ते हैं, फिर ChatGPT द्वारा दिए गए जवाबों को रेट और आलोचनात्मक रूप से परखते हैं। यह फ़ीडबैक प्रशिक्षण प्रक्रिया में वापस भेजा जाता है, जिससे यह तय होता है कि अगली बार कोई समान अनुरोध आने पर मॉडल कैसा व्यवहार करेगा।
इसका दायरा अलग-अलग एक-पंक्ति वाले सवालों से कहीं व्यापक है। समीक्षकों को उपयोगकर्ता और चैटबॉट के बीच पूरी बातचीत दिखाई जा सकती है, जिसका मतलब है कि एक पूरा आगे-पीछे का संवाद — फ़ॉलो-अप, सुधार, साथ-साथ स्वेच्छा से दिए गए विवरण — किसी व्यक्ति के सामने से गुज़र सकता है। निर्देश गाइड यह तय करने के लिए कठोर मानक स्थापित करते हैं कि गुणवत्तापूर्ण आउटपुट क्या माना जाए, और एक उत्कृष्ट प्रतिक्रिया को वह बताते हैं जो उपयोगकर्ता के वास्तविक इरादे को समझती है, सटीक और उपयोगी मदद देती है, और उचित स्नेह के साथ स्पष्ट व स्वाभाविक ढंग से पढ़ी जाती है।
मात्रा ही मुद्दा है। प्रॉम्प्ट की निरंतर धारा पर काम करने वाले सैकड़ों समीक्षकों का मतलब है कि असली बातचीत बड़े पैमाने पर खपत की जा रही है, न कि कभी-कभार जाँच के लिए नमूने के रूप में ली जा रही है। ऐसी कंपनी के लिए जिसका उत्पाद रोज़ाना भारी संख्या में क्वेरीज़ संभालता है, वह मानवीय परत सुधार चक्र का एक स्थायी हिस्सा बन जाती है, न कि एक बार का ऑडिट।
करोड़ों लोगों के लिए एक गोपनीयता अंधा धब्बा
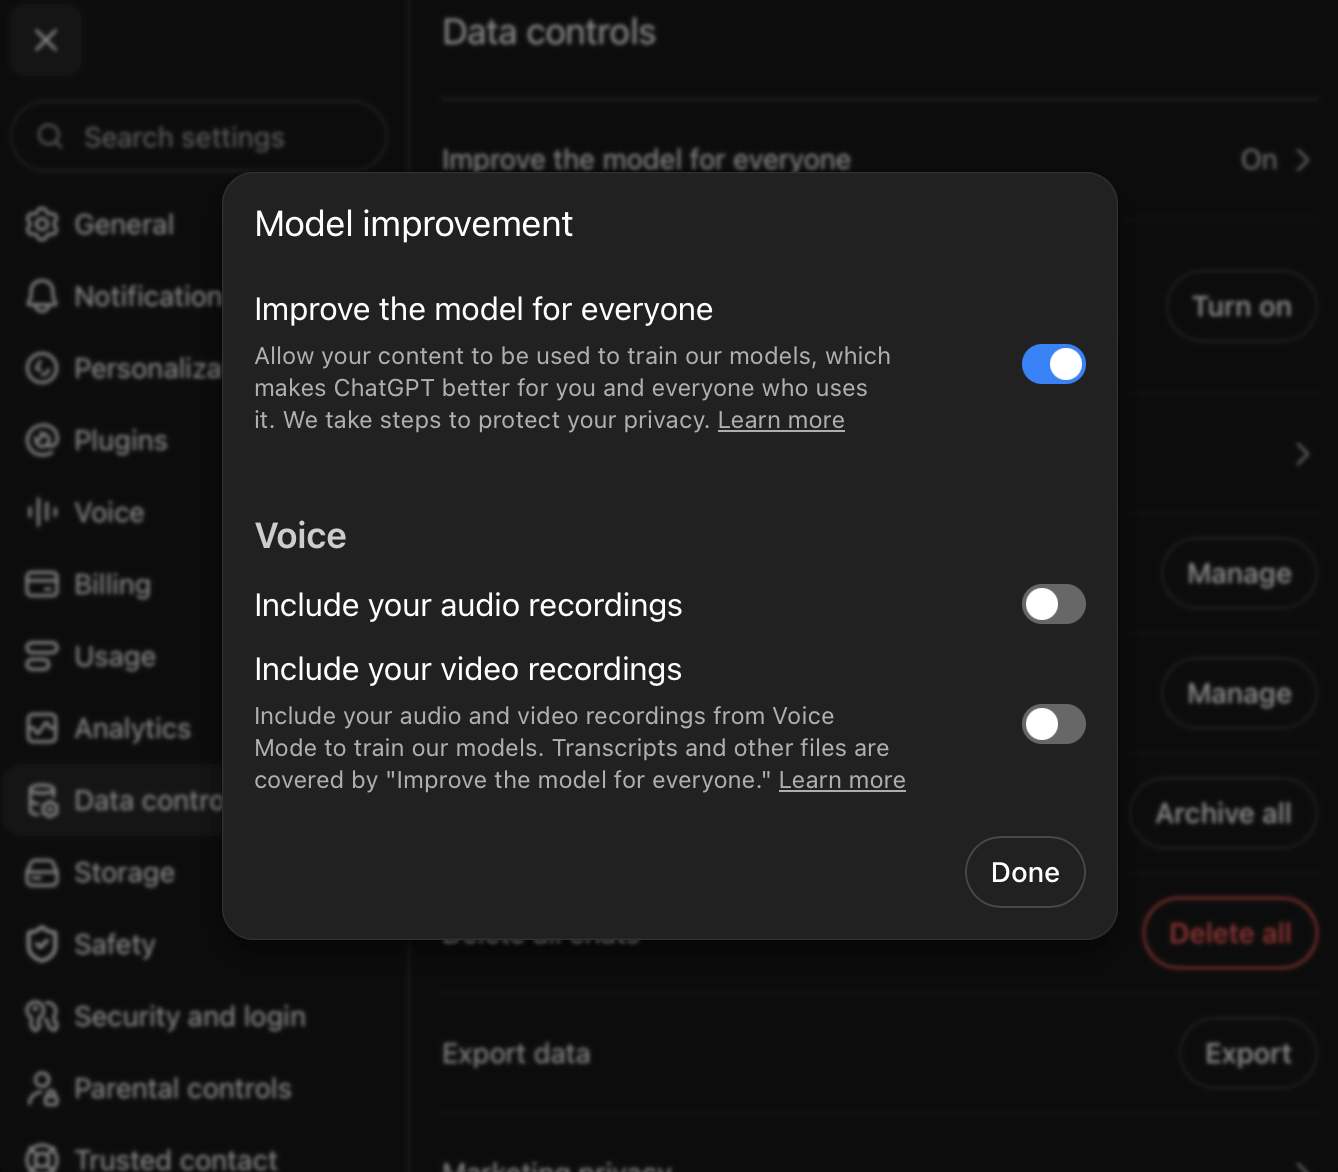
OpenAI समीक्षकों को उपयोगकर्ता नाम नहीं देता, और कंपनी का कहना है कि वह प्रॉम्प्ट में मानवीय नज़रों तक पहुँचने से पहले व्यक्तिगत विवरण हटाने का प्रयास करती है। लेकिन कंपनी ने यह भी स्वीकार किया है कि संवेदनशील जानकारी उस फ़िल्टरिंग से बचकर पढ़ने वाले लोगों तक पहुँच सकती है।
व्यवहार में यह अंतर बेहद मायने रखता है। खाते के स्तर पर गुमनामी, सारतः गुमनामी के समान नहीं है। अगर कोई प्रॉम्प्ट किसी निदान, तलाक, कर्ज़, कार्यस्थल के टकराव, या किसी निजी डर का वर्णन करता है, तो पहचान बनाने वाला मूल्य सामग्री में ही होता है, उससे जुड़े हैंडल में नहीं।
और लोग ठीक वही सामग्री लेकर आते हैं। ChatGPT एक थेरेपिस्ट का काउच, एक पेशेवर सहायक, और कुछ मामलों में एक डिजिटल साथी बन गया है। उपयोगकर्ता नियमित रूप से अपनी सेहत, रिश्तों, पैसे और चिंताओं के बारे में अंतरंग विवरण सौंप देते हैं — अक्सर ठीक इसलिए क्योंकि यह बातचीत निजी, तात्कालिक और बिना किसी निगरानी वाली लगती है।
"मुझे नहीं लगता कि वे कल्पना करेंगे"
धारणा और वास्तविकता के बीच का अंतर ही इस कहानी का केंद्र है। जब एक ऐसे व्यक्ति से पूछा गया जो प्रॉम्प्ट के साथ काम करता है कि क्या उसे लगता है कि ChatGPT उपयोगकर्ता समझते हैं कि इंसान उनकी बातचीत पढ़ सकते हैं, तो उसका जवाब सीधा था। उसने कहा नहीं, और जोड़ा कि उपयोगकर्ता यह कल्पना नहीं करेंगे कि कहीं कोई कॉन्ट्रैक्टर उनकी बातचीत का विश्लेषण कर रहा है।
यह अपेक्षा सतही तौर पर उचित है। चैट विंडो के साथ बातचीत करने वाले अधिकांश लोगों को कोई दृश्य संकेत नहीं मिलता कि कोई व्यक्ति बाद में गुणवत्ता सुधार कार्यक्रम के तहत उनके शब्दों को स्क्रॉल कर सकता है। मॉडल ट्यूनिंग के लिए प्रॉम्प्ट पढ़ना उस तरह से प्रचारित नहीं किया जाता जैसे किसी नए फ़ीचर या सुरक्षा नीति अपडेट को किया जाता है।
साइकोफ़ैंसी, मानवीकरण, और वास्तविक नुकसान
आंतरिक दस्तावेज़ यह भी उजागर करते हैं कि समीक्षकों से क्या सुधारने के लिए कहा जा रहा है। रिपोर्टिंग के अनुसार, कॉन्ट्रैक्टरों को यह सिखाया जाता है कि वे ChatGPT को खुद का मानवीकरण करने से रोकें — यानी खुद को ऐसे प्रस्तुत करने से जैसे वह भावनाओं या स्थायी आंतरिक जीवन वाला व्यक्ति हो — और इसकी साइकोफ़ैंसी को कम करें, यानी उपयोगकर्ताओं की चापलूसी करने और उनसे सहमत होने की सहज प्रवृत्ति, बजाय उन्हें चुनौती देने के।
ये महज़ सतही खामियाँ नहीं हैं। OpenAI के 4o मॉडल में अत्यधिक साइकोफ़ैंसी को मुकदमों में कई लोगों की आत्महत्याओं में योगदान देने वाले कारक के रूप में उद्धृत किया गया है। जब कोई सिस्टम इस तरह ट्यून किया जाता है कि वह व्यक्ति जो भी कहे उसे सही ठहराए, तो इसके परिणाम एक हल्के-फुल्के चिढ़ाने वाले चैटबॉट जवाब से बहुत आगे तक पहुँच सकते हैं। मानवीय समीक्षा परत, आंशिक रूप से, उस विफलता मोड को कम करने का एक प्रयास है।
सुरक्षा समीक्षा से अलग बात
इस काम को OpenAI द्वारा सार्वजनिक रूप से बताए गए सुरक्षा उपायों से अलग रखना उचित है। इनमें उन चैट की समीक्षा शामिल है जब कंपनी को ऐसे उपयोगकर्ता मिलते हैं जो अन्य लोगों को नुकसान पहुँचाने की योजना बना रहे प्रतीत होते हैं — एक संकीर्ण, संकट-केंद्रित हस्तक्षेप।
कॉन्ट्रैक्टरों द्वारा की जाने वाली प्रॉम्प्ट समीक्षा बिल्कुल अलग कार्य है, जिसका लक्ष्य आपातकालीन पहचान के बजाय रोज़मर्रा की जवाब गुणवत्ता है। यही कारण है कि यह इतनी सामान्य बातचीत को छूती है। कोई उपयोगकर्ता जो किसी कठिन संदेश का मसौदा तैयार करने में मदद माँग रहा है या किसी व्यक्तिगत निर्णय पर विचार कर रहा है, संकट में नहीं है और उसके पास यह अपेक्षा करने का कोई कारण नहीं है कि उसकी जाँच होगी, फिर भी उसकी बातचीत समीक्षा कतार में पहुँच सकती है।

Anthropic ने भी इसी प्रथा की पुष्टि की
OpenAI इस दृष्टिकोण में अकेला नहीं है। Anthropic ने 404 Media को पुष्टि की कि वह भी अपने मॉडलों को बेहतर बनाने के लिए मानवीय समीक्षा का उपयोग करता है, जो दर्शाता है कि असली उपयोगकर्ता इंटरैक्शन पढ़ना एक उद्योग-व्यापी प्रथा है, न कि किसी एक कंपनी का अलग-थलग प्रयोग। यह निष्कर्ष इस धारणा को जटिल बनाता है कि प्रदाता बदलने से अंतर्निहित गोपनीयता प्रश्न हल हो जाता है।
सुधार के भ्रम के पीछे का श्रम
यह रिपोर्टिंग AI मॉडलों के लगातार बेहतर होते जाने की एक लोकप्रिय व्याख्या को भी चुनौती देती है। सामान्य कहानी इंटरनेट टेक्स्ट की विशाल स्क्रैपिंग, अच्छी तनख्वाह वाले इंजीनियरिंग और शोध प्रतिभा, और अधिक सक्षम आर्किटेक्चर की क्रमिक पीढ़ियों को श्रेय देती है।
ये सभी मायने रखते हैं, लेकिन वे कुछ अधिक शांत और अक्सर अनदेखी की गई बात छोड़ देते हैं: बाहरी कॉन्ट्रैक्टर जिन्हें असली ChatGPT प्रतिक्रियाओं को बार-बार, बड़े पैमाने पर पढ़ने और रेट करने के लिए भुगतान किया जाता है। वह मानवीय श्रम उत्पाद में एक सार्थक इनपुट है, और यह काफी हद तक इस सार्वजनिक कथा के बाहर है कि फ्रंटियर सिस्टम कैसे आगे बढ़ते हैं।
उपयोगकर्ताओं को क्या समझना चाहिए
- ChatGPT कोई गोपनीय चैनल नहीं है। प्रॉम्प्ट को मॉडल सुधार पर काम करने वाले मानवीय कॉन्ट्रैक्टर पढ़ सकते हैं।
- उपयोगकर्ता नाम हटाना संदर्भ नहीं हटाता। उपयोगकर्ता द्वारा स्वेच्छा से दिए गए विवरण अपने आप में पहचान बनाने वाले हो सकते हैं।
- OpenAI की अपनी मान्यता के अनुसार रिडैक्शन अपूर्ण है — संवेदनशील जानकारी अभी भी समीक्षकों तक पहुँच सकती है।
- यह प्रथा एक कंपनी से आगे तक फैली है, Anthropic ने भी समान मानवीय समीक्षा की पुष्टि की है।
- सुरक्षा-संबंधी चैट समीक्षा और गुणवत्ता-संबंधी प्रॉम्प्ट समीक्षा अलग-अलग कार्यक्रम हैं, और बाद वाला नियमित बातचीत तक पहुँचता है।
इनमें से कोई भी बात इस प्रथा को अपने आप अनुचित नहीं बनाती। ऐसे सिस्टम को बेहतर बनाने के लिए, जिस पर करोड़ों लोग गंभीर सवालों के लिए भरोसा करते हैं, किसी न किसी रूप में फ़ीडबैक ज़रूरी है, और मानवीय निर्णय उपलब्ध सबसे प्रभावी उपकरणों में से एक बना हुआ है। सवाल यह है कि क्या इस अदला-बदली का खुलासा ऐसे तरीके से किया जाता है जिसे उपयोगकर्ता वास्तव में तौल सकें।
फ़िलहाल, जवाब ना में लगता है। कोई व्यक्ति जो चैट बॉक्स में कोई स्वीकारोक्ति, कोई चिकित्सीय सवाल, या कोई करियर संकट टाइप कर रहा है, उसे यह नहीं बताया जाता कि समीक्षा कतार में कोई कॉन्ट्रैक्टर उसे पढ़ सकता है। इस अंतर को पाटना — स्पष्ट सूचना, मज़बूत डी-आइडेंटिफ़िकेशन, या अधिक कठोर फ़िल्टरिंग के माध्यम से — वह परीक्षा है जिसका सामना अब उद्योग को करना है, और इसका मूल्यांकन इस बात से होगा कि भेजें दबाने से पहले उपयोगकर्ताओं को कितना जानने की अनुमति दी जाती है।
यह लेख 404 Media की रिपोर्टिंग पर आधारित है। मूल लेख पढ़ें।
Originally published on 404media.co
