Un problème de classification au cœur de la génétique de l'autisme
Au cours des deux dernières décennies, les généticiens ont constitué un catalogue long et toujours croissant de gènes liés au trouble du spectre de l'autisme. Ce catalogue a été extrêmement productif, mais il a aussi mis en évidence une lacune embarrassante : savoir quels gènes portent un risque n'explique pas automatiquement comment ces gènes produisent des résultats aussi variés. Deux individus peuvent porter des mutations dans le même gène et présenter des profils remarquablement différents, tandis que des mutations dans des gènes entièrement différents peuvent converger vers des traits similaires.
Un article publié dans Science — Volume 393, numéro 6817, pages 1250–1257, daté de septembre 2026 — s'attaque à cette lacune avec un titre qui énonce clairement sa méthode : « Transcriptome-based classification in mice with ASD-risk mutations ». Le cadrage signale un changement d'accent. Plutôt que de trier les animaux modèles uniquement selon la mutation qu'ils portent, le travail examine le transcriptome — l'ensemble complet des transcrits d'ARN produits dans une cellule ou un tissu — comme base pour les regrouper et les classer.
Pourquoi le transcriptome importe
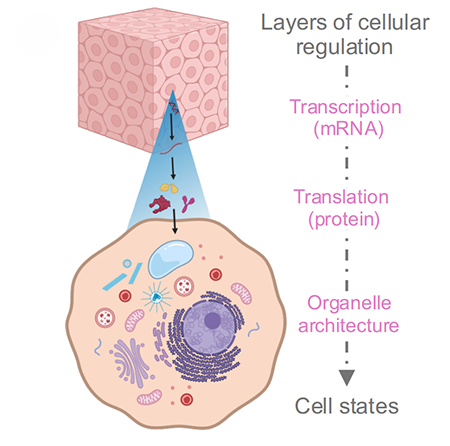
L'ADN est souvent décrit comme un plan, mais un plan qui n'est jamais lu ne produit rien. Le transcriptome est la lecture : il capture quels gènes sont activement transcrits, et à quels niveaux, à un moment donné dans un tissu donné. Parce qu'il se situe en aval à la fois de la variation génétique et de l'influence environnementale, il offre une vue plus dynamique de l'état biologique qu'un génotype seul.
Cette qualité rend la classification fondée sur le transcriptome conceptuellement attrayante pour les troubles neurodéveloppementaux. Si des mutations dans différents gènes de risque de TSA perturbent finalement des ensembles de voies biologiques qui se chevauchent, alors les profils d'expression pourraient révéler des regroupements que les données de séquence masquent. Des souris porteuses de mutations de risque distinctes pourraient, en principe, se regrouper non pas parce qu'elles partagent un gène, mais parce qu'elles partagent une conséquence moléculaire.
Du génotype à la signature moléculaire
La logique est à peu près la suivante. Prenez un ensemble de lignées de souris, chacune modifiée pour porter une mutation associée au risque d'autisme. Profilez l'expression génique dans le tissu pertinent — généralement les régions cérébrales impliquées dans le comportement social, la communication et les schémas de comportement répétitifs. Demandez ensuite si les signatures d'expression résultantes trient les animaux en groupes significatifs, et si ces groupes s'alignent sur quelque chose d'observable chez les animaux eux-mêmes.
Si un tel alignement existe, il donnerait aux chercheurs une prise moléculaire pour stratifier des modèles qui, autrement, ressemblent à une collection indifférenciée de mutations. Cela soulèverait également la possibilité que certaines interventions soient mieux adaptées aux profils moléculaires qu'à des noms de gènes spécifiques.

Pourquoi les modèles murins restent centraux
Les études humaines sur la génétique de l'autisme font face à de dures contraintes. Le tissu cérébral est rarement disponible pour le profilage moléculaire, les tailles d'échantillons pour les mutations rares sont petites, et l'influence de l'environnement, du moment du diagnostic et des conditions concomitantes est difficile à démêler. Les modèles murins ne résolvent pas ces problèmes, mais ils permettent des expériences contrôlées qui seraient impossibles chez l'humain.
Les lignées de souris modifiées permettent aux chercheurs d'introduire une mutation définie sur un fond génétique largement uniforme, d'élever les animaux dans des conditions standardisées et de profiler les tissus à des stades de développement précis. Le compromis est bien compris : les souris ne sont pas des humains en miniature, et des traits humains complexes tels que la communication sociale ne se transposent pas proprement au comportement des rongeurs. Tout schéma de classification construit chez la souris est donc un outil de génération d'hypothèses, non un outil diagnostique.
Le problème de l'hétérogénéité
Le trouble du spectre de l'autisme est défini par des critères comportementaux, et le mot « spectre » fait un vrai travail. La même étiquette couvre des individus ayant des besoins de soutien profonds et des individus qui vivent de manière indépendante, avec une large gamme de profils cognitifs, sensoriels et langagiers entre les deux. Génétiquement, la condition est tout aussi désordonnée, impliquant des mutations rares à fort impact, des variants communs à petit effet, et des combinaisons des deux.
Cette hétérogénéité est l'obstacle central à la traduction des découvertes génétiques en bénéfice clinique. Un traitement qui aide un sous-groupe biologique peut n'avoir aucun effet sur un autre, et moyenner les résultats sur un groupe non divisé peut masquer un effet réel. La classification — par la génétique, par le comportement, par des biomarqueurs ou par le transcriptome — est la stratégie que les chercheurs ont adoptée pour affronter ce problème.
Le sous-typage comme stratégie de recherche
La classification fondée sur le transcriptome appartient à un mouvement plus large vers le sous-typage moléculaire en psychiatrie et en neurosciences. L'attrait est simple : les données d'expression sont quantitatives, au niveau du tissu et relativement non biaisées, en ce sens qu'elles ne dépendent pas d'un chercheur décidant à l'avance quelle voie compte. Le risque est tout aussi simple. Les signatures transcriptomiques peuvent être bruitées, sensibles à l'âge, au sexe, au tissu et à la manipulation, et sujettes au surajustement lorsque les tailles d'échantillons sont modestes.

Lire le nouvel article en contexte
L'étude paraît dans l'une des revues scientifiques générales les plus lues, ce qui fixe des attentes de rigueur et de portée. Ses pages dans Science — 1250 à 1257 dans le Volume 393, numéro 6817 — la placent dans la couverture de septembre 2026 des sciences de la vie de la revue. Les lecteurs qui abordent ce travail devraient rechercher plusieurs choses : combien de lignées de souris et de mutations ont été profilées, quelles régions cérébrales ou quels tissus ont été échantillonnés, comment les signatures d'expression ont été définies et validées, et si les classes résultantes correspondent à une mesure comportementale ou physiologique.
Ils devraient aussi rechercher la convergence. Si la classification fait surface des voies déjà impliquées dans la biologie de l'autisme — fonction synaptique, synthèse protéique, régulation de la chromatine, signalisation immunitaire — cela renforcerait la confiance que les regroupements reflètent quelque chose de réel plutôt qu'un artefact du pipeline d'analyse. La divergence serait aussi intéressante, mais exigerait plus de preuves.
Ce qu'il faut surveiller ensuite
Les schémas de classification ne gagnent leur place que s'ils s'avèrent utiles. Les tests utiles sont pratiques : les classes prédisent-elles comment une lignée de souris répond à une intervention donnée ? Se répliquent-elles dans des cohortes indépendantes et dans d'autres laboratoires ? S'alignent-elles sur les données humaines, que ce soit à partir de tissus post-mortem, de modèles de cellules souches pluripotentes induites, ou d'études de cohortes humaines de plus en plus riches ?
Aucune de ces questions n'est tranchée par un seul article. Ce qu'une étude de ce type peut faire, c'est démontrer que l'approche est viable et vaut la peine d'être poursuivie — que le transcriptome porte suffisamment de structure pour organiser une collection génétiquement désordonnée d'animaux modèles en groupes cohérents. Que cette structure se traduise en meilleures expériences et, à terme, en un soutien mieux ciblé pour les personnes autistes est un projet plus long, et qui exigera la même convergence entre génétique, profilage moléculaire et observation clinique que le domaine poursuit depuis des années.
Points clés à retenir
- L'article de Science, publié dans le Volume 393, numéro 6817 (pages 1250–1257, septembre 2026), est intitulé « Transcriptome-based classification in mice with ASD-risk mutations ».
- L'approche classe les modèles murins par leurs profils d'expression génique plutôt que par la mutation de risque spécifique qu'ils portent.
- Le transcriptome se situe en aval à la fois de la variation génétique et de l'influence environnementale, ce qui en fait un candidat pour capturer l'état biologique.
- Les modèles murins permettent un profilage contrôlé et spécifique au stade, largement impossible dans la recherche sur le cerveau humain, mais ils génèrent des hypothèses plutôt qu'ils ne sont directement cliniques.
- La valeur de tout schéma de classification reposera sur la reproductibilité, la puissance prédictive et l'alignement éventuel avec les données humaines.
Cet article est basé sur un reportage de Science (AAAS). Lire l'article original.
Originally published on science.org