Les modèles de prédiction clinique nécessitent davantage qu’un résultat publié
Les modèles de prédiction clinique sont de plus en plus utilisés pour éclairer les décisions diagnostiques et pronostiques. Leur précision rapportée peut influencer la manière dont les cliniciens estiment les risques, priorisent les examens ou discutent des résultats probables avec les patients. Mais une nouvelle analyse publiée dans Nature Medicine soutient qu’une condition fondamentale pour évaluer ces modèles reste rare : l’accès au code analytique qui les sous-tend.
L’étude a examiné des articles de recherche en libre accès citant les cadres de communication TRIPOD ou TRIPOD+AI, qui concernent la présentation transparente des études de modèles prédictifs. Les chercheurs ont utilisé un processus assisté par un grand modèle de langage pour examiner la littérature, repérer les liens vers des dépôts et évaluer les dépôts auxquels ils pouvaient accéder à l’aide de 14 caractéristiques prédéfinies liées à la reproductibilité.
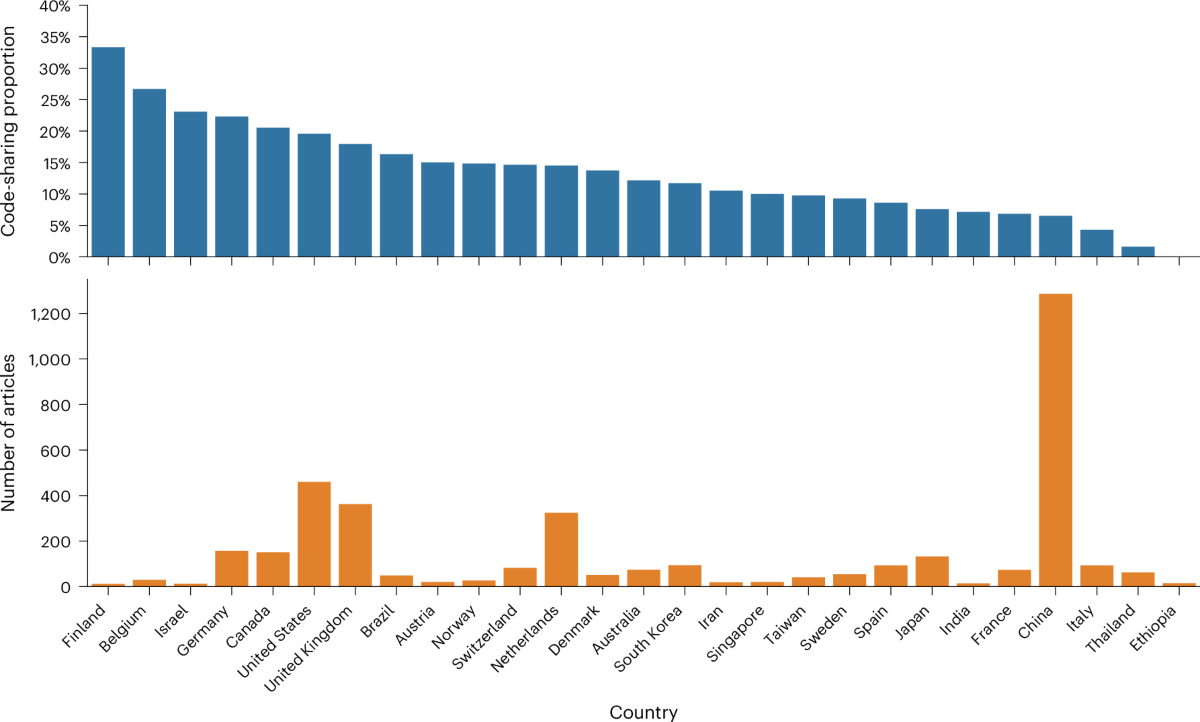
Sur les 3 967 articles examinés, 482 comportaient une déclaration indiquant que le code était partagé. Cela représente 12,2 % de l’échantillon. Ce résultat n’établit pas que toutes les études restantes ne disposaient pas d’un code accessible, mais il montre que les déclarations explicites de partage de code demeuraient exceptionnelles dans la littérature étudiée.
La disponibilité n’est pas synonyme de reproductibilité
Le point central des chercheurs est qu’un simple lien vers un dépôt ne suffit pas à rendre une analyse facile à vérifier ou à réutiliser. Ils ont constaté une grande variation des caractéristiques liées à la reproductibilité dans les dépôts évalués. En pratique, un autre chercheur peut avoir besoin de davantage que des fichiers sources pour comprendre si un modèle peut être recréé : la documentation, les informations sur les dépendances logicielles et une structure de projet exécutable peuvent toutes être importantes.
Cette distinction est particulièrement importante pour les travaux de prédiction clinique. Un modèle peut être développé à partir d’une cohorte spécifique, d’un processus de prétraitement et d’un ensemble de définitions des résultats. Si les étapes analytiques ne peuvent pas être examinées indépendamment, il devient plus difficile pour des chercheurs extérieurs d’évaluer comment les choix opérés dans le processus ont influencé les performances rapportées, ou si le travail peut être adapté et testé dans un autre contexte.
La revue a également constaté que la prévalence du partage de code variait fortement selon la revue et le pays. Le texte fourni de l’étude n’identifie pas les revues ou les pays en tête ou à la traîne, mais cette variation suggère que les normes et les attentes éditoriales influencent la décision des chercheurs de rendre leur travail disponible.

Une revue assistée par l’IA des pratiques de recherche
Les auteurs ont utilisé un processus assisté par un grand modèle de langage à des fins méthodologiques : examiner les articles pertinents, extraire les liens vers les dépôts et contribuer à évaluer ces dépôts au regard d’un ensemble de caractéristiques prédéfini. Cette approche a permis à l’équipe d’examiner des milliers d’articles, tandis que la mesure substantielle restait centrée sur des caractéristiques concrètes de la communication et des dépôts.
Son utilisation reflète également un défi plus large pour la gouvernance de la recherche. À mesure que le volume des publications augmente, les audits manuels des pratiques de transparence deviennent difficiles à mettre à l’échelle. Des processus automatisés, structurés et soigneusement conçus peuvent aider à cartographier ces pratiques, à condition que leurs résultats soient évalués selon des critères clairement définis. Dans ce cas, les critères portaient sur la disponibilité du code et sur des caractéristiques pertinentes pour la reproductibilité, plutôt que sur un jugement automatisé de la qualité scientifique d’un modèle donné.
Pourquoi cette lacune compte pour le déploiement
Les modèles cliniques sont destinés à éclairer des décisions réelles ; leur fiabilité et leur généralisabilité doivent donc être examinées attentivement. Un modèle qui semble efficace dans un article publié peut fonctionner différemment une fois mis en œuvre ailleurs, lorsque les populations de patients, la collecte des données et les processus cliniques diffèrent. L’évaluation indépendante du processus analytique constitue un moyen d’examiner les fondements de ces affirmations.
Le code ouvert ne peut pas résoudre tous les problèmes de reproductibilité. Les données des patients peuvent être restreintes pour des raisons de confidentialité et de droit, et les utilisateurs externes peuvent ne pas être en mesure de recréer exactement une analyse sans accès aux données originales. Même ainsi, un code analytique clair, des informations détaillées sur les dépendances et une documentation utilisable peuvent rendre le travail plus contrôlable et aider les chercheurs à comprendre ce qui serait nécessaire pour le tester de manière responsable avec un autre jeu de données.
Les auteurs présentent ces résultats comme un argument en faveur d’attentes plus claires qu’une simple déclaration attestant l’existence d’un code. Ils estiment que la documentation, la spécification des dépendances et une structure exécutable devraient faire partie de pratiques plus rigoureuses. Ces éléments peuvent réduire l’ambiguïté pour les lecteurs et pour les équipes qui tentent de reproduire ou d’étendre une étude.

TRIPOD-Code est le prochain objectif réglementaire
La revue a été menée pour éclairer TRIPOD-Code, une directive de communication axée sur la disponibilité du code et la reproductibilité. Les directives de communication ne garantissent pas à elles seules que les chercheurs publieront des projets complets et utilisables. Elles peuvent toutefois rendre les attentes visibles pour les auteurs, les évaluateurs et les revues, et créer un vocabulaire commun pour déterminer ce qui a été fourni.
Le résultat fournit un repère concret : dans cet échantillon de la littérature, environ un article sur huit seulement comportait une déclaration de partage de code. Dans un domaine où les modèles se rapprochent de l’usage clinique, les auteurs estiment qu’améliorer la qualité et la clarté du travail analytique partagé pourrait rendre la recherche plus exploitable et contribuer à une transposition plus sûre dans la pratique.
L’étude déplace donc l’attention de la simple mention du code dans un article vers la question de savoir si un lecteur indépendant pourrait comprendre et exécuter le processus analytique. C’est une exigence plus élevée, mais étroitement alignée sur les éléments nécessaires pour évaluer les modèles de prédiction clinique avant de s’y fier dans les soins.
Cet article s’appuie sur un reportage de Nature Medicine. Lire l’article original.
Originally published on nature.com


