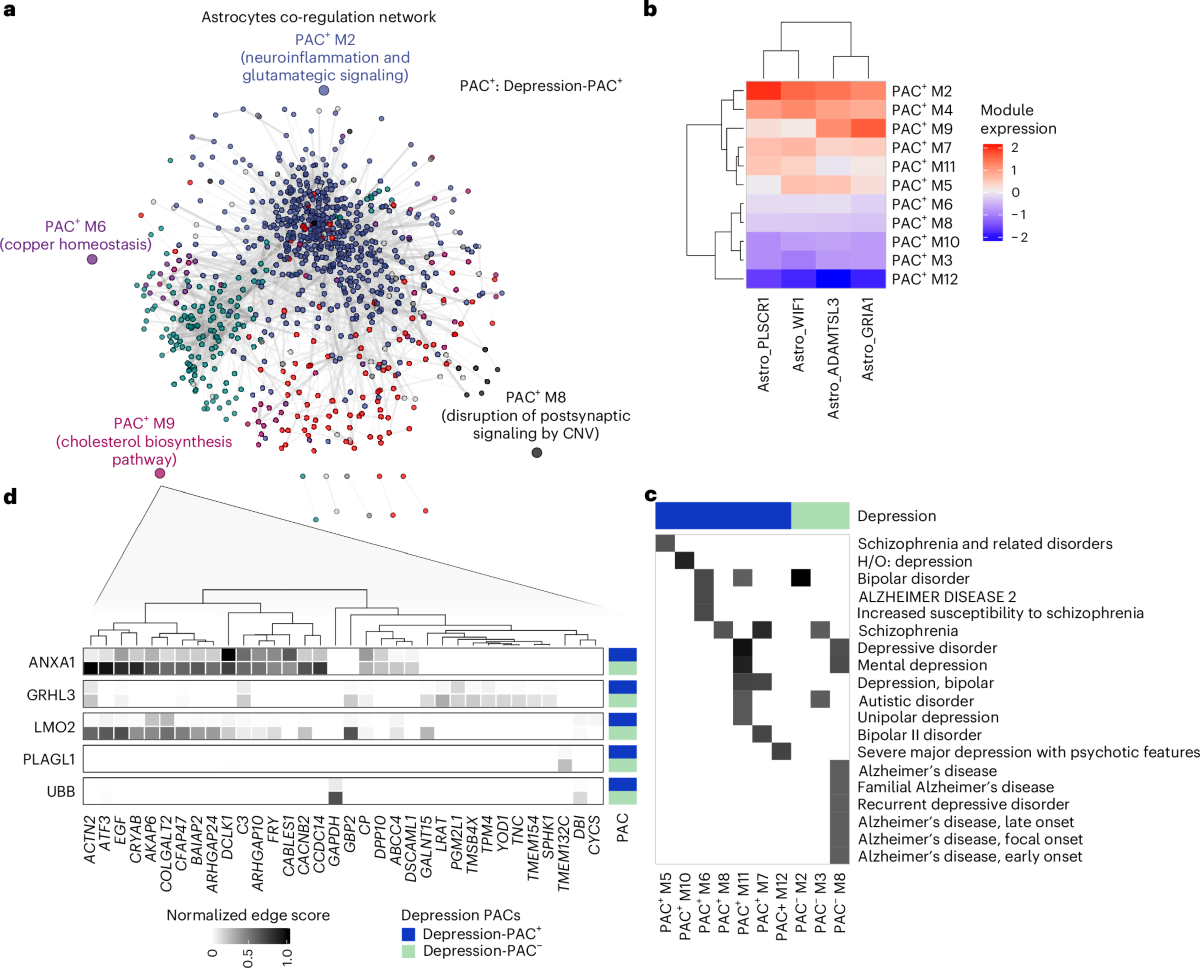
La enfermedad de Alzheimer es uno de los rompecabezas más obstinados de la medicina. Dos pacientes pueden llevar el mismo diagnóstico, obtener puntuaciones similares en las mismas pruebas de memoria y, aun así, diferir enormemente en qué células cerebrales fallan primero, qué vías moleculares se desvían y con qué rapidez sigue el deterioro. Un estudio publicado en línea en Nature Medicine el 23 de septiembre de 2026 sostiene que la inteligencia artificial puede ayudar a dar sentido a esa variabilidad a una escala que los métodos anteriores no podían alcanzar.
El artículo, titulado "AI-based characterization of Alzheimer's disease phenotypes from population-scale single-cell data", aplica análisis de aprendizaje automático a mediciones unicelulares extraídas de una cohorte de 584 donantes de cerebro — un grupo que incluye pacientes con enfermedad de Alzheimer junto con donantes de comparación. La ambición declarada es fácil de describir y difícil de ejecutar: en lugar de tratar el Alzheimer como una única afección uniforme, usar métodos computacionales para clasificar los perfiles moleculares de células individuales en fenotipos de enfermedad reconocibles.
Por qué el tejido cerebral en bloque difumina la imagen
Durante la mayor parte de la historia de la investigación del Alzheimer, los científicos han estudiado el tejido cerebral en bloque. Triturar una región de la corteza, medir la actividad promedio de miles de genes en millones de células y se obtiene un número limpio y reproducible. Pero un promedio es una mala descripción de un vecindario. Si una pequeña población de células inmunitarias está montando una respuesta inflamatoria mientras la mayoría de las neuronas simplemente se ocupan de sus asuntos, esa señal puede diluirse hasta volverse invisible. El mismo problema ocurre a la inversa: una medición dominada por el tipo celular más abundante puede enmascarar el comportamiento de todo lo demás.
Las tecnologías unicelulares cambiaron la aritmética. En lugar de una medición por región cerebral, los investigadores ahora pueden capturar la actividad génica en miles de células individuales o núcleos a la vez, dando a cada uno una identidad molecular. El resultado no es una única curva, sino una vasta y dispersa matriz de células y genes — un conjunto de datos cuyo tamaño mismo es precisamente lo que hace atractivo el aprendizaje automático.
Los tipos celulares que dominan la conversación
- Las neuronas portan la maquinaria eléctrica y sináptica de la que depende la memoria, y su vulnerabilidad selectiva en distintas regiones cerebrales es un rasgo definitorio de la enfermedad.
- Los astrocitos apoyan el metabolismo neuronal y ayudan a mantener la barrera hematoencefálica, y pueden pasar a estados reactivos que protegen o dañan el tejido circundante.
- La microglía son las células inmunitarias residentes del cerebro; sus estados de activación están entre las variables más estudiadas en la investigación del Alzheimer.
- Los oligodendrocitos y sus precursores envuelven los axones en mielina, y los cambios en el soporte de la sustancia blanca pueden alterar la rapidez con que se comunican los circuitos neuronales.
- Las células vasculares y de barrera revisten el suministro sanguíneo del cerebro, donde las fugas y los mecanismos de eliminación deteriorados se han implicado desde hace mucho en la progresión de la enfermedad.

Qué aporta realmente la IA
Una vez que un conjunto de datos contiene cientos de miles de células, cada una descrita por miles de genes, ningún humano puede examinarlo a simple vista. Los métodos de aprendizaje automático se usan para comprimir esa dimensionalidad, agrupar células con perfiles similares y buscar estructura que atraviese las categorías convencionales — por ejemplo, estados celulares que se sitúan entre dos tipos conocidos, o patrones a nivel de donante que solo emergen cuando se comparan cientos de individuos a la vez.
La palabra "characterization" en el título del artículo importa. Esto no es una afirmación de haber construido una prueba diagnóstica, ni una promesa de que un modelo pueda predecir quién desarrollará Alzheimer. Es un trabajo descriptivo y organizativo: tomar una enfermedad altamente heterogénea y preguntar si su presentación molecular se resuelve en un número menor de fenotipos coherentes que puedan nombrarse, compararse y, con el tiempo, ser objeto de intervención.
El peso de 584 donantes de cerebro
El tejido cerebral humano es un recurso escaso. Los programas de donantes requieren años de coordinación con familias, clínicos y patólogos, y cada espécimen llega con su propia historia de edad, genética, medicación e intervalo post mortem. Reunir una cohorte de 584 donantes es, por tanto, un logro logístico sustancial en sí mismo, y es la frase "population-scale" del título la que señala por qué el estudio puede intentar algo que una muestra pequeña no podría.
La escala compra potencia estadística. Los estados celulares raros, los cambios sutiles en la proporción de un tipo celular respecto a otro y las interacciones entre el riesgo genético y el comportamiento celular solo se vuelven detectables cuando se comparan suficientes donantes. También permite el tipo de replicación interna que necesitan los estudios de aprendizaje automático: un patrón encontrado en un subconjunto de donantes puede probarse contra otro antes de que nadie afirme que es real.

Por qué los fenotipos importan más que una única etiqueta
El desarrollo de fármacos para el Alzheimer ha estado marcado por la suposición de que una enfermedad requiere un mecanismo y un tratamiento. Esa suposición ha producido décadas de decepciones costosas. Si la afección es en realidad una familia de fenotipos moleculares relacionados pero distinguibles, entonces promediar los resultados de todos los pacientes podría ocultar beneficios genuinos en un subgrupo — y podría igualmente exponer a los pacientes a efectos secundarios de una terapia dirigida a la biología equivocada.
El pensamiento centrado primero en el fenotipo no es nuevo en oncología, donde el perfilado tumoral es práctica estándar antes de seleccionar el tratamiento. La pregunta que plantea esta línea de investigación es si la neurodegeneración puede abordarse de la misma manera, usando firmas celulares y moleculares en lugar de solo síntomas clínicos para definir quién es un paciente.
Límites y preguntas abiertas
El tejido post mortem ofrece una instantánea, a menudo tomada al final de una larga enfermedad. Puede revelar qué estados celulares acompañan a la enfermedad avanzada, pero no puede establecer fácilmente qué cambios ocurrieron primero o cuáles son causas y no consecuencias. Las cohortes de donantes también se sesgan de maneras bien conocidas por los investigadores: las personas que donan cerebros no son una muestra aleatoria de la población, y la propia enfermedad puede alterar los perfiles celulares de maneras no relacionadas con su causa raíz.
También está el peligro conocido de aplicar modelos potentes a una biología compleja. El aprendizaje automático puede encontrar estructura que refleja artefactos técnicos — diferencias en cómo se procesaron las muestras o en cómo se secuenciaron las células — en lugar de la enfermedad. La replicación independiente en cohortes separadas, y la validación con métodos complementarios, es lo que separa un patrón convincente de un hallazgo duradero.
Qué observar a continuación
- Replicación: si los mismos fenotipos reaparecen en colecciones de donantes independientes y en pacientes vivos muestreados mediante sangre o líquido cefalorraquídeo.
- Contexto espacial: si los estados celulares identificados en tejido disociado pueden mapearse de vuelta a sus vecindarios físicos, ya que la ubicación da forma a la función.
- Traslación clínica: si algún fenotipo corresponde a una diferencia medible en la progresión o en la respuesta al tratamiento.
- Compartición de datos: si los datos celulares subyacentes se publican en un formato que otros grupos puedan reutilizar, lo que determina con qué rapidez el campo puede construir sobre el resultado.
El resumen publicado del estudio es deliberadamente compacto, y el detalle sustantivo — qué fenotipos emergieron, cuán estables son y cómo se relacionan con marcadores genéticos y patológicos existentes — vive en el artículo completo. Lo que el resumen sí establece es la forma del esfuerzo: un intento impulsado por IA de reemplazar una única etiqueta contundente de Alzheimer por una descripción celular más precisa, aplicada a una escala que no era posible hace una década. Si esa descripción se sostiene se decidirá por la replicación, no por la elegancia del modelo.
Este artículo se basa en la cobertura de Nature Medicine. Lee el artículo original.
Originally published on nature.com


