La IA agéntica llega allí donde los errores se miden en pacientes
La inteligencia artificial médica se ha evaluado tradicionalmente como una prueba diagnóstica. Un modelo se entrena con un conjunto de datos, se compara con clínicos en una muestra reservada y se puntúa según la sensibilidad, la especificidad o alguna otra medida de corrección. Todo ese enfoque se apoya en una suposición: el modelo produce una salida y un ser humano la interpreta.
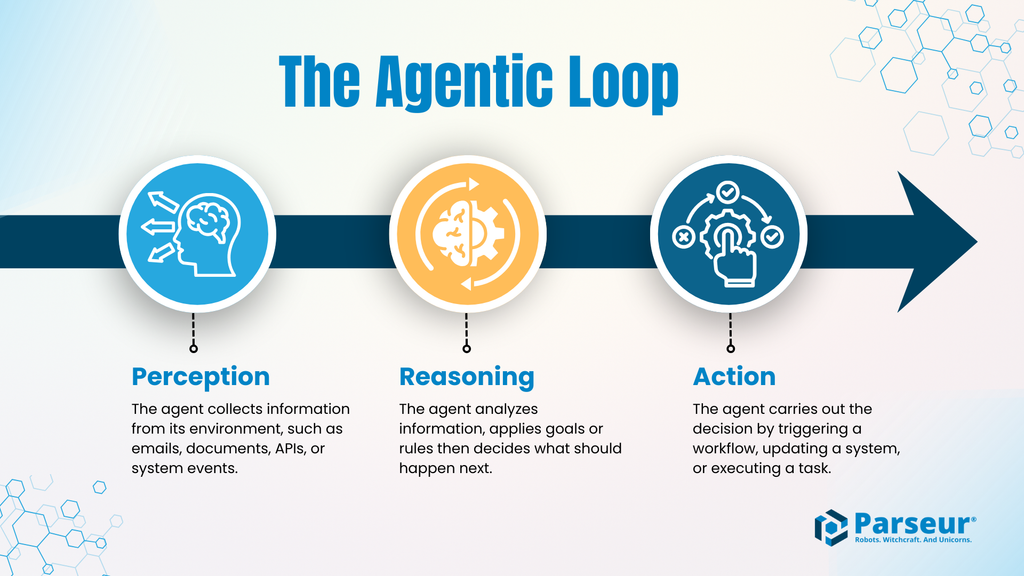
La IA agéntica rompe esa suposición. Estos sistemas están diseñados para perseguir objetivos a lo largo de múltiples pasos —recuperar historiales, solicitar pruebas, redactar documentación, programar seguimientos y revisar un plan a medida que llega nueva información—. Un artículo publicado en Nature Medicine el 2 de octubre de 2026, titulado "The missing links in agentic AI autonomy", apunta a la brecha que esto crea. Su tema no es la precisión del modelo, sino la confianza: concretamente, la confianza operativa y decisional que debe existir antes de que se pueda permitir que los sistemas autónomos participen de forma significativa en la atención.
El planteamiento se aparta deliberadamente de la forma en que el campo suele argumentar sobre la seguridad de la IA. La mayoría de los debates tratan la confianza como una consecuencia posterior al rendimiento: construye un modelo mejor y la confianza seguirá. Este artículo sugiere que la relación también funciona en sentido inverso: sin estructuras que hagan que la confianza sea medible y se gane, ni siquiera los modelos excelentes pueden delegarse de forma segura.
Dos tipos de confianza, no uno
El movimiento más útil del artículo es dividir la confianza en dos categorías. La distinción importa porque ambas fallan de maneras muy diferentes, y confundirlas oculta dónde están los problemas reales.
Confianza operativa
La confianza operativa tiene que ver con si un sistema hace lo que dice hacer, de forma fiable, en el entorno donde realmente se despliega. ¿Puede acceder a las fuentes de datos correctas? ¿Falla de forma controlada cuando falta un registro, una consulta agota el tiempo de espera o cambia una interfaz? ¿Se degrada de maneras que un humano supervisor puede ver, o produce en silencio sinsentidos con seguridad? Parecen cuestiones de ingeniería, pero en un entorno clínico conllevan peso clínico. Un sistema que pierde silenciosamente un resultado de laboratorio no es solo defectuoso; es potencialmente dañino.
Confianza decisional
La confianza decisional es más estrecha y más difícil de establecer. Se refiere a si los juicios que hace un sistema —qué acción tomar, en qué secuencia y, de forma crítica, cuándo detenerse— merecen ser objeto de confianza. Un sistema puede ser operativamente impecable y aun así tomar decisiones que un clínico rechazaría de plano. A la inversa, un sistema con una infraestructura frágil puede razonar bien dentro de una ventana estrecha en la que nada se rompe. Tratar estos aspectos como una sola variable, como hace buena parte de la conversación actual, oculta el hecho de que arreglar uno no hace nada por el otro.

Por qué la autonomía cambia el cálculo del riesgo
Una herramienta convencional de IA clínica se sitúa dentro de un flujo de trabajo y espera. Responde a una pregunta y la respuesta se revisa. Los sistemas agénticos hacen algo diferente: mantienen un hilo. Toman decisiones intermedias, algunas de las cuales son trascendentales, y esas decisiones se acumulan. La persona nominalmente a cargo puede ver solo el resumen al final.
Esa acumulación es lo que hace que la cuestión de la confianza sea urgente en lugar de filosófica. Cada paso adicional que da un sistema sin un punto de control multiplica el número de lugares por donde puede entrar un error y el número de decisiones posteriores que lo heredan. La supervisión humana que funciona para una única predicción no escala automáticamente a una cadena de diez acciones realizadas a lo largo de una tarde.
La atención sanitaria agudiza esto aún más porque el ámbito es inusualmente implacable con los modos de fallo que los sistemas agénticos exhiben con mayor facilidad: exceso de confianza, fabricación verosímil y dificultad para reconocer el límite de su propia competencia. Un chatbot que inventa una cita es vergonzoso. Un sistema que inventa una interacción medicamentosa y actúa en consecuencia es algo completamente distinto.
Los eslabones perdidos
Si el argumento del artículo es que la autonomía requiere más que capacidad, la siguiente pregunta natural es qué falta en realidad. Varias brechas se repiten a lo largo del terreno que abarca el artículo.
- Evaluación que se ajuste a la tarea. Los benchmarks estáticos miden respuestas únicas, no secuencias de decisiones. No existe una práctica madura para puntuar si el plan de un agente era razonable, solo si su salida final coincidió con una referencia.
- Auditabilidad del razonamiento. Cuando un sistema realiza una acción, el registro de por qué lo hizo suele ser escaso o reconstruido a posteriori. Sin rastros fiables, la supervisión se convierte en teatro.
- Escalado bien definido. Los sistemas agénticos necesitan puntos claros y fiables en los que devuelvan el control a un humano. Demasiados traspasos hacen que el sistema sea inútil; demasiado pocos lo hacen peligroso, y el umbral correcto depende del contexto.
- Gobernanza que anticipe la autonomía. Los marcos regulatorios construidos en torno a dispositivos y diagnósticos no se corresponden limpiamente con sistemas cuyo comportamiento cambia con cada contexto de despliegue.
- Definiciones compartidas. Sin un vocabulario acordado sobre qué cuenta como confianza operativa frente a decisional, las instituciones no pueden comparar notas, y cada despliegue reinventa sus propios estándares de forma aislada.

Cómo sería realmente una autonomía ganada
La prescripción implícita del artículo es que la autonomía debe concederse de forma incremental y respaldada por evidencia, no darse por supuesta a partir de puntuaciones de benchmarks. Eso implica un conjunto bastante exigente de hábitos institucionales.
- Despliegues que comienzan con acciones estrechas y reversibles y amplían el alcance solo a medida que se acumula evidencia.
- Monitorización que sigue la calidad de las decisiones a lo largo del tiempo, no solo el tiempo de actividad y la latencia.
- Responsabilidad clara: un humano o un comité designado responsable cuando una acción automatizada causa daño.
- Documentación lo bastante rigurosa como para que un revisor independiente pueda reconstruir qué ocurrió y por qué.
Nada de esto es glamuroso. Es el tejido conectivo que convierte un sistema capaz en uno digno de confianza, y es precisamente la capa que tiende a omitirse cuando el modelo subyacente es lo bastante impresionante como para generar entusiasmo.
La conclusión incómoda
La implicación más desafiante del artículo de Nature Medicine es que los eslabones perdidos en la autonomía de la IA agéntica pueden no ser técnicos en absoluto. Los mejores modelos harán que la confianza operativa sea más fácil de lograr: más rápida, más fiable, menos frágil. Pero la confianza decisional depende de cuestiones que ninguna arquitectura resuelve: quién es responsable, qué cuenta como riesgo aceptable, cuánta supervisión es suficiente y quién decide.
Son cuestiones institucionales y clínicas, y la atención sanitaria tiene décadas de experiencia duramente ganada respondiéndolas para profesionales humanos. El trabajo por delante es extender esa experiencia a sistemas que actúan en lugar de limitarse a responder. Hasta que eso ocurra, la descripción honesta de la mayor parte de la IA agéntica en medicina no es autónoma. Es no supervisada, que es algo completamente distinto.
Este artículo se basa en la cobertura de Nature Medicine. Lea el artículo original.

Originally published on nature.com

