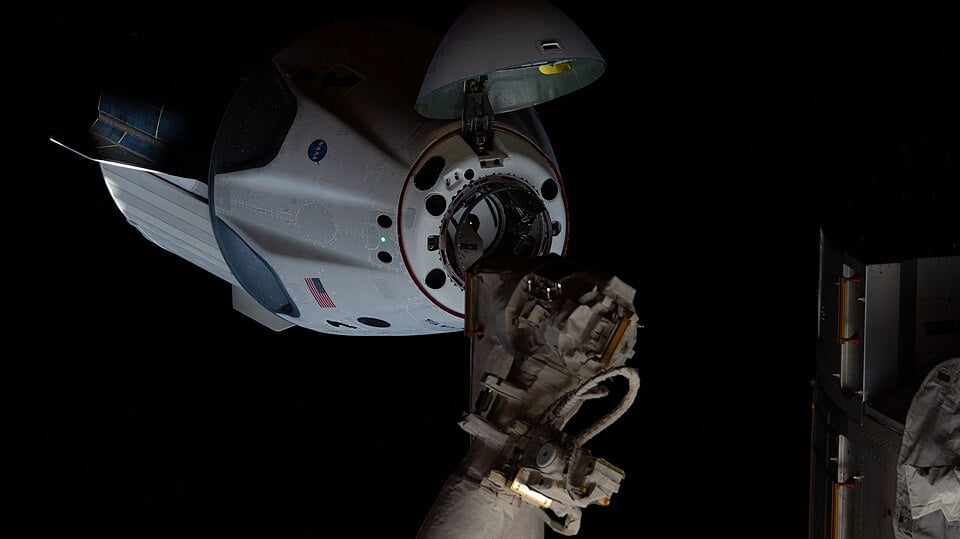
Der schwierigste Parkplatz im Sonnensystem
Das Andocken eines Raumfahrzeugs an die Internationale Raumstation sieht in Animationen wie ein langsames, anmutiges Ballett aus. Die Realität kommt einem physikalischen Albtraum mit hohem Einsatz näher. Die Station umkreist die Erde mit etwa 28.000 Kilometern pro Stunde, und eine sich nähernde Kapsel muss diese Geschwindigkeit erreichen, während sie in einen Andockport mit Toleranzen im Zentimeterbereich gleitet. Wie der Universe-Today-Autor Andy Tomaswick es formulierte, ist es, als fahre man mit 28.000 km/h über eine Autobahn und parke parallel in eine offene Garage eines mehrere Milliarden Dollar teuren Labors ein, das sich mit derselben Geschwindigkeit bewegt.
Die Orbitalmechanik fügt grausame Wendungen hinzu, mit denen Autofahrer auf der Erde nie konfrontiert werden. Wenn ein Pilot versucht, vorwärts zu beschleunigen, driftet das Raumfahrzeug tatsächlich nach oben. Es gibt keine Luftreibung, die das Fahrzeug auf natürliche Weise abbremst. Und die Folgen eines Fehlschlags sind katastrophal: Eine Kollision könnte alle an Bord sowohl des ankommenden Fahrzeugs als auch der Station töten, und das entstehende Trümmerfeld könnte Dutzende Satelliten und sogar Menschen am Boden bedrohen.
Jahrzehntelang haben sich Luft- und Raumfahrtingenieure auf fest einprogrammierte physikalische Gleichungen und menschliche Piloten verlassen, die diese korrigieren. Nun schlägt ein neues Preprint-Papier von Forschern der Stanford University, das auf arXiv verfügbar ist, einen anderen Ansatz vor. Das Team entwickelt eine KI, die eine Reihe von „mentalen Simulationen“ durchführt – eine Fähigkeit, die laut den Forschern grundlegend verändern könnte, wie künftige Raumfahrzeuge miteinander interagieren. Ihr System heißt Out-of-this-World Model, kurz OWM.
Wie Raumfahrzeuge heute andocken – und wo es scheitert
Um zu verstehen, warum OWM wichtig ist, hilft es, den konventionellen Werkzeugkasten für die Navigation im niedrigen Erdorbit (LEO) zu kennen. Traditionelle Navigationscomputer führen einen Guidance-, Navigation- and Control-Algorithmus (GNC) aus. Sie verwenden außerdem ein mathematisches Werkzeug namens Extended Kalman Filter, das Daten von GPS-Empfängern und Startrackern aufnimmt und die erforderlichen Schubdüsen-Betriebszyklen ausgibt, um das Fahrzeug zu steuern.
Kalman-Filter und das Video-Problem
Kalman-Filter sind leistungsstark, aber sie sind schlecht darin, Hochgeschwindigkeitsvideos zu verarbeiten. Diese Einschränkung treibt Ingenieure zu traditionellen Computer-Vision-Techniken. Im Weltraum stehen diese Techniken jedoch vor einer ernsten Hürde: Sie sind fragil. Wenn Sonnenlicht von einem Solararray reflektiert wird oder wenn ein Teil des Ziels plötzlich im Schatten liegt, können die Computer-Vision-Algorithmen völlig aus dem Tritt geraten. Ein Andockport, der einen Moment lang klar sichtbar war, kann im nächsten Moment zu einer unkenntlichen Form werden.
Warum Reinforcement Learning strauchelt
Maschinelles Lernen klingt nach der perfekten Lösung, und Forscher haben es versucht. Sie begannen, Reinforcement-Learning-Algorithmen (RL) anzuwenden – dieselbe Methodenfamilie, die Computern bekanntermaßen beigebracht hat, Schach und Dota zu gewinnen. Doch RL hat eine enge Komfortzone: Es ist hervorragend, wenn die Regeln fest und spezifisch sind. Ändert man die Regeln, etwa indem man vertauscht, auf welcher Seite der ISS sich der Andockport befindet, wissen die Algorithmen nicht mehr, was zu tun ist. Ein Andockmanöver, das in einer Konfiguration einwandfrei funktionierte, kann in einer anderen vollständig scheitern.
Das Out-of-this-World Model betritt die Bühne
Die Antwort des Stanford-Teams ist ein „World Model“. Statt eine einzelne Regelmenge auswendig zu lernen oder sich auf fragile Merkmalserkennung zu verlassen, baut ein World Model eine interne Repräsentation der Umgebung auf und nutzt sie, um mentale Simulationen durchzuführen. Das Raumfahrzeug kann gewissermaßen von möglichen Zukünften träumen – sich vorstellen, wie seine Triebwerke seine Flugbahn verändern, wie die Station bei ihrer Rotation erscheinen wird und wie sich die Lichtverhältnisse verschieben könnten –, bevor es sich für einen Schub entscheidet.
Dies ist eine bedeutende Abkehr sowohl von klassischer GNC als auch von reinem RL. Klassische Algorithmen hängen von handgefertigten Gleichungen ab, die für jede Mission abgestimmt werden müssen. RL-Agenten hängen von umfangreichem Training in einer engen Domäne ab. Ein World Model zielt auf Generalisierung ab: Indem es ein prädiktives Modell davon lernt, wie die Welt funktioniert, kann es sich anpassen, wenn sich das Szenario ändert, etwa bei einer anderen Ausrichtung des Andockports oder unerwarteten Schatten.
Die Baseball-Analogie: Denken ohne Gleichungen
Die Forscher erklären das Konzept mit einer Analogie, die nichts mit Raketen zu tun hat: einem Baseball- oder Cricketspieler, der einen Flugball fängt. Wenn ein Outfielder sich bewegt, um einen Ball zu fangen, beginnt er nicht sofort, partielle Differentialgleichungen zu lösen. Stattdessen verlässt er sich auf ein intuitives, prädiktives Modell davon, wie sich der Ball bewegen wird – eine aus Erfahrung aufgebaute mentale Simulation. Er läuft, passt sich an und fängt den Ball, ohne jemals eine Flugbahn auf Papier zu berechnen.
Ein World Model gibt einem Raumfahrzeug etwas Ähnliches. Statt bei jedem Schritt explizit die Gleichungen der Orbitalbewegung zu lösen, kann die KI Ergebnisse intern simulieren. Sie kann sich ihren Weg durch einen Andockanflug „erträumen“ und hypothetische Aktionen gegen ihr erlerntes Modell von Physik und Wahrnehmung testen. Wenn die mentale Simulation eine Kollision oder eine verfehlte Ausrichtung vorhersagt, kann das System korrigieren, bevor das Manöver in der realen Welt schiefgeht.

Was das für künftige Raumfahrzeuge bedeuten könnte
Die Implikationen reichen über das Andocken an die ISS hinaus. Während immer mehr Raumfahrzeuge autonom operieren – Satelliten warten, Strukturen im Orbit montieren oder Verkehr in überfüllten Orbitalbahnen navigieren –, wird die Fähigkeit, über neuartige Situationen zu schlussfolgern, unerlässlich. Fest einprogrammierte Gleichungen und fragile Computer Vision dürften kaum in eine Zukunft skalieren, in der Fahrzeuge kooperieren, Trümmer vermeiden und sich an Bedingungen anpassen müssen, die kein Ingenieur vollständig vorhergesehen hat.
Das Stanford-Papier ist ein Preprint, was bedeutet, dass es noch nicht peer-reviewed wurde, und der Quelltext beschreibt weder die Architektur des OWM noch Trainingsdaten oder Leistungsbenchmarks. Doch die Kernidee ist überzeugend: Bringt Raumfahrzeugen bei, ein mentales Modell ihrer Welt aufzubauen, und lasst sie dann in ihren Köpfen üben, bevor sie Triebwerke zünden. Wenn es funktioniert, könnte das Andocken weniger ein nervenaufreibender Parallelpark-Job und mehr Routine werden – eine, bei der das Raumfahrzeug bereits tausend Arten imagined hat, wie der Anflug schiefgehen könnte, und einen Weg hindurch gefunden hat.
Vorerst bleibt das Problem so entmutigend wie eh und je. Geschwindigkeiten bei 28.000 km/h abzugleichen, Orbitaldrift zu kompensieren und eine katastrophale Kollision zu vermeiden, sind keine Herausforderungen, die über Nacht verschwinden. Doch die Stanford-Forscher wetten darauf, dass die nächste Generation von Raumfahrzeugen sich nicht nur ihren Weg zur Station errechnen wird. Sie werden sich ihren Weg dorthin erträumen.
Dieser Artikel basiert auf einer Reportage von Universe Today. Lesen Sie den Originalartikel.
Originally published on universetoday.com