Klinische Prognosemodelle brauchen mehr als ein veröffentlichtes Ergebnis
Klinische Prognosemodelle werden zunehmend eingesetzt, um diagnostische und prognostische Entscheidungen zu unterstützen. Die berichtete Genauigkeit kann beeinflussen, wie Ärztinnen und Ärzte Risiken einschätzen, Untersuchungen priorisieren oder mit Patientinnen und Patienten über wahrscheinliche Ergebnisse sprechen. Eine neue Analyse in Nature Medicine argumentiert jedoch, dass eine grundlegende Voraussetzung für die Bewertung solcher Modelle weiterhin selten erfüllt ist: der Zugang zum analytischen Code, der ihnen zugrunde liegt.
Die Studie untersuchte frei zugängliche Forschungsartikel, in denen die Berichtsrahmenwerke TRIPOD oder TRIPOD+AI zitiert wurden. Diese betreffen die transparente Berichterstattung über Studien zu Prognosemodellen. Die Forschenden nutzten eine durch ein Large Language Model unterstützte Pipeline, um die Literatur zu sichten, Repository-Links zu identifizieren und die abrufbaren Repositories anhand von 14 vordefinierten Merkmalen zur Reproduzierbarkeit zu bewerten.
Von den 3.967 untersuchten Artikeln enthielten 482 eine Erklärung, dass der Code geteilt wurde. Das entspricht 12,2 % der Stichprobe. Daraus folgt nicht, dass jede verbleibende Studie keinen zugänglichen Code hatte. Es zeigt jedoch, dass ausdrückliche Angaben zur gemeinsamen Nutzung von Code in der untersuchten Literatur weiterhin die Ausnahme waren.
Verfügbarkeit ist nicht dasselbe wie Reproduzierbarkeit
Der zentrale Punkt der Forschenden lautet, dass ein Repository-Link allein eine Analyse nicht leicht überprüfbar oder wiederverwendbar macht. Bei den bewerteten Repositories stellten sie erhebliche Unterschiede bei den reproduzierbarkeitsbezogenen Merkmalen fest. In der Praxis benötigt eine andere Forschende oder ein anderer Forschender möglicherweise mehr als Quelldateien, um zu verstehen, ob ein Modell rekonstruiert werden kann: Dokumentation, Informationen zu Softwareabhängigkeiten und eine ausführbare Projektstruktur können ebenfalls entscheidend sein.
Diese Unterscheidung ist für klinische Prognosearbeiten besonders wichtig. Ein Modell kann auf Basis einer bestimmten Kohorte, eines Vorverarbeitungsprozesses und einer Reihe von Ergebnisdefinitionen entwickelt worden sein. Wenn die analytischen Schritte nicht unabhängig eingesehen werden können, ist es für externe Forschende schwieriger zu beurteilen, wie Entscheidungen im Arbeitsablauf die berichtete Leistung beeinflusst haben oder ob die Arbeit in einem anderen Umfeld angepasst und getestet werden kann.
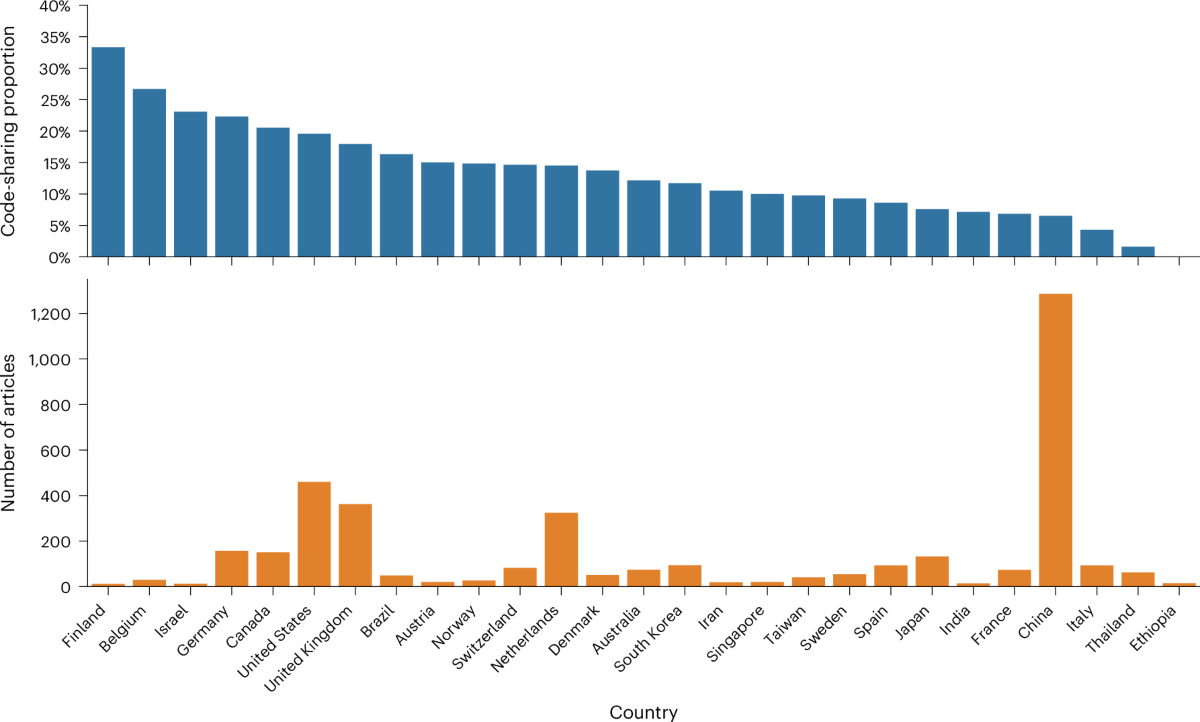
Die Übersichtsarbeit zeigte außerdem, dass der Anteil geteilter Codes je nach Fachzeitschrift und Land stark variierte. Der bereitgestellte Studientext nennt nicht, welche Zeitschriften oder Länder führend oder zurückliegend waren. Die Unterschiede legen jedoch nahe, dass Normen und redaktionelle Erwartungen beeinflussen, ob Forschende ihre Arbeit zugänglich machen.

Eine KI-gestützte Untersuchung der Forschungspraxis
Die Autorinnen und Autoren setzten einen durch ein Large Language Model unterstützten Prozess methodisch ein: zur Sichtung relevanter Artikel, zur Extraktion von Repository-Links und zur Unterstützung bei der Bewertung von Repositories anhand eines vordefinierten Merkmalskatalogs. So konnte das Team Tausende Arbeiten untersuchen, während die inhaltliche Messung auf konkreten Merkmalen der Berichterstattung und der Repositories blieb.
Der Einsatz spiegelt auch eine umfassendere Herausforderung für die Forschungsgovernance wider. Mit wachsendem Publikationsvolumen lassen sich manuelle Prüfungen von Transparenzpraktiken nur schwer skalieren. Strukturierte, sorgfältig entwickelte automatisierte Pipelines können dabei helfen, diese Praktiken zu erfassen, sofern ihre Ergebnisse anhand klar definierter Kriterien bewertet werden. In diesem Fall bezogen sich die Kriterien auf die Verfügbarkeit von Code und auf Merkmale, die für die Reproduzierbarkeit relevant sind, nicht auf ein automatisiertes Urteil über die wissenschaftliche Qualität eines einzelnen Modells.
Warum die Lücke für die Implementierung wichtig ist
Klinische Modelle sollen Entscheidungen in der realen Welt unterstützen. Daher müssen ihre Zuverlässigkeit und Generalisierbarkeit genau geprüft werden. Ein Modell, das in einer veröffentlichten Arbeit wirksam erscheint, kann bei der Implementierung an einem anderen Ort anders funktionieren, wenn sich Patientengruppen, Datenerhebung und klinische Abläufe unterscheiden. Die unabhängige Prüfung des Analyseprozesses ist eine Möglichkeit, die Grundlage solcher Aussagen zu untersuchen.
Offener Code kann nicht jedes Reproduzierbarkeitsproblem lösen. Patientendaten können aus Gründen des Datenschutzes und des Rechts eingeschränkt sein, und externe Nutzerinnen und Nutzer können eine Analyse ohne Zugriff auf die Originaldaten möglicherweise nicht exakt nachbilden. Klarer analytischer Code, Angaben zu Abhängigkeiten und nutzbare Dokumentation können die Arbeit dennoch besser überprüfbar machen und Forschenden helfen zu verstehen, was erforderlich wäre, um sie verantwortungsvoll mit einem anderen Datensatz zu testen.
Die Autorinnen und Autoren verstehen die Ergebnisse als Beleg für klarere Erwartungen, die über eine einfache Erklärung der Code-Existenz hinausgehen. Dokumentation, die Spezifikation von Abhängigkeiten und eine ausführbare Struktur sollten ihrer Ansicht nach Teil einer besseren Praxis sein. Diese Elemente können Unklarheiten für Leserinnen und Leser sowie für Teams verringern, die eine Studie reproduzieren oder erweitern möchten.

TRIPOD-Code ist das nächste politische Ziel
Die Übersichtsarbeit wurde durchgeführt, um TRIPOD-Code zu informieren, eine Berichtsleitlinie mit Schwerpunkt auf Codeverfügbarkeit und Reproduzierbarkeit. Berichtsleitlinien garantieren nicht selbst, dass Forschende vollständige und nutzbare Projekte veröffentlichen. Sie können jedoch Erwartungen für Autorinnen und Autoren, Gutachtende und Zeitschriften sichtbar machen und eine gemeinsame Sprache schaffen, um festzustellen, was bereitgestellt wurde.
Das Ergebnis liefert einen konkreten Maßstab: In dieser Literaturstichprobe enthielt nur etwa jede achte Arbeit eine Erklärung zur gemeinsamen Nutzung von Code. In einem Bereich, in dem Modelle auf eine klinische Nutzung zusteuern, argumentieren die Autorinnen und Autoren, dass eine bessere Qualität und Klarheit geteilter Analysearbeiten die Forschung nutzbarer machen und eine sicherere Übertragung in die Praxis unterstützen könnten.
Die Studie verlagert den Fokus daher von der bloßen Erwähnung von Code hin zur Frage, ob eine unabhängige Leserin oder ein unabhängiger Leser den Analyseablauf verstehen und ausführen könnte. Das ist ein höherer Maßstab, entspricht aber eng der Evidenz, die nötig ist, um klinische Prognosemodelle zu beurteilen, bevor man sich in der Versorgung auf sie verlässt.
Dieser Artikel basiert auf einer Berichterstattung von Nature Medicine. Originalartikel lesen.
Originally published on nature.com