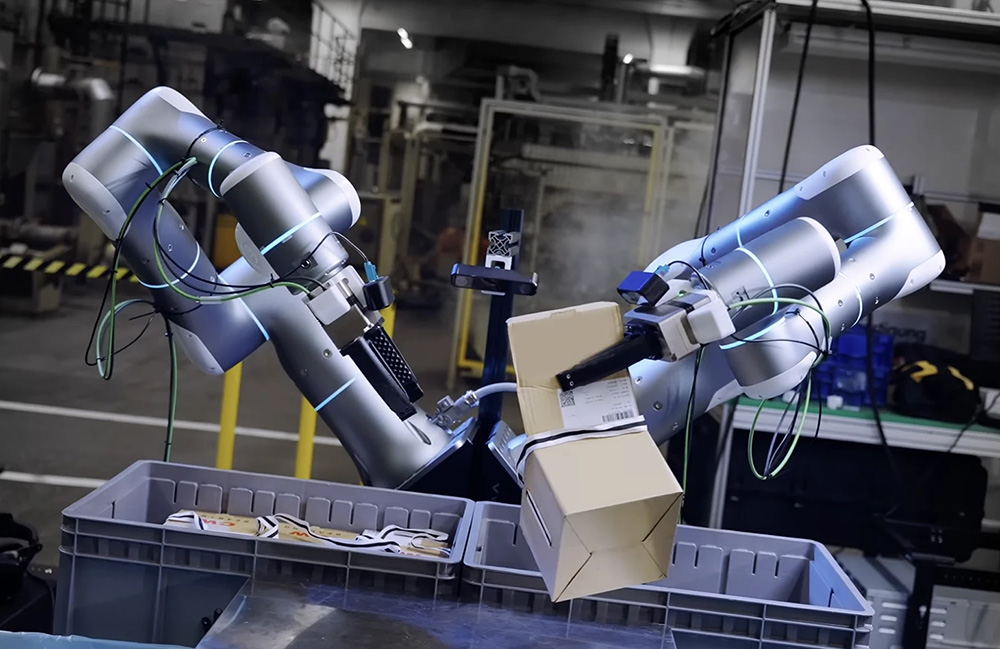
Eine breitere Datengrundlage für Roboter
Rhoda AI geht davon aus, dass Roboter wesentlich größere und vielfältigere Trainingsdaten benötigen, um außerhalb kontrollierter Demonstrationen zuverlässig zu arbeiten. Das Unternehmen nutzt Videos im Internetmaßstab, um Modelle für Bewegung, Physik und physische Interaktion zu trainieren.
Rhoda beendete Anfang 2026 eine 18-monatige Geheimhaltungsphase mit 450 Millionen US-Dollar in einer Serie-A-Finanzierung. Nach eigenen Angaben arbeitet das Unternehmen mit Kunden aus Automobilindustrie, Fertigung, Logistik und E-Commerce am Einsatz seines Direct-Video-Action-Modells DVA.
Warum Video im Mittelpunkt steht
Teleoperation kann Demonstrationen liefern, aber nicht unbedingt die Menge und Vielfalt, die für autonome Manipulation erforderlich sind. Rhoda setzt auf Video, weil es Beispiele für Bewegung, Objektinteraktion und wechselnde Szenen in großem Umfang enthält.

So funktioniert Direct Video Action
Das DVA-Modell verarbeitet eine Historie von Videobildern, Aktions- und Sprach-Tokens, sagt eine nahe Videoszene voraus und übersetzt sie in Roboteraktionen. Nach Angaben des Unternehmens prognostiziert es die nächsten hundert Millisekunden und erzeugt anschließend ausführbare Befehle.
Mobilität und Manipulation verbinden
Rhoda zufolge kombiniert mobile DVA Mobilität und Manipulation in einer einzigen Policy. Das ist für Roboter gedacht, die sich durch eine Anlage bewegen und zugleich mit Objekten interagieren müssen.
Die größere Frage der Robotik
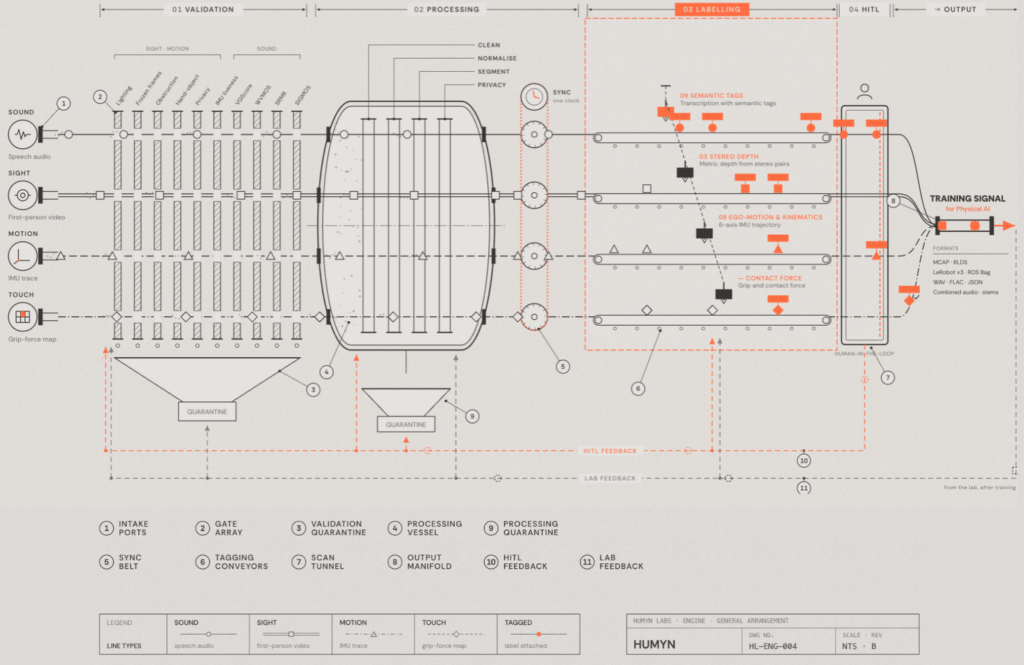
Der Ansatz spiegelt den Trend zu Foundation-Model-Training in der Robotik wider. Video kann ein breites Vorwissen über Bewegung und Interaktion liefern. Entscheidend wird jedoch sein, ob Roboter bei wechselnden Umgebungen, Objekten und Betriebsbedingungen zuverlässig bleiben.
Dieser Artikel basiert auf einer Meldung von The Robot Report. Originalartikel lesen.
Originally published on therobotreport.com