Agentische KI kommt dort an, wo Fehler in Patienten gemessen werden
Medizinische künstliche Intelligenz wurde traditionell wie ein diagnostischer Test beurteilt. Ein Modell wird auf einem Datensatz trainiert, gegen Kliniker an einer zurückgehaltenen Stichprobe verglichen und anhand von Sensitivität, Spezifität oder einem anderen Korrektheitsmaß bewertet. Dieser gesamte Ansatz beruht auf einer Annahme: Das Modell erzeugt eine Ausgabe, und ein Mensch interpretiert sie.
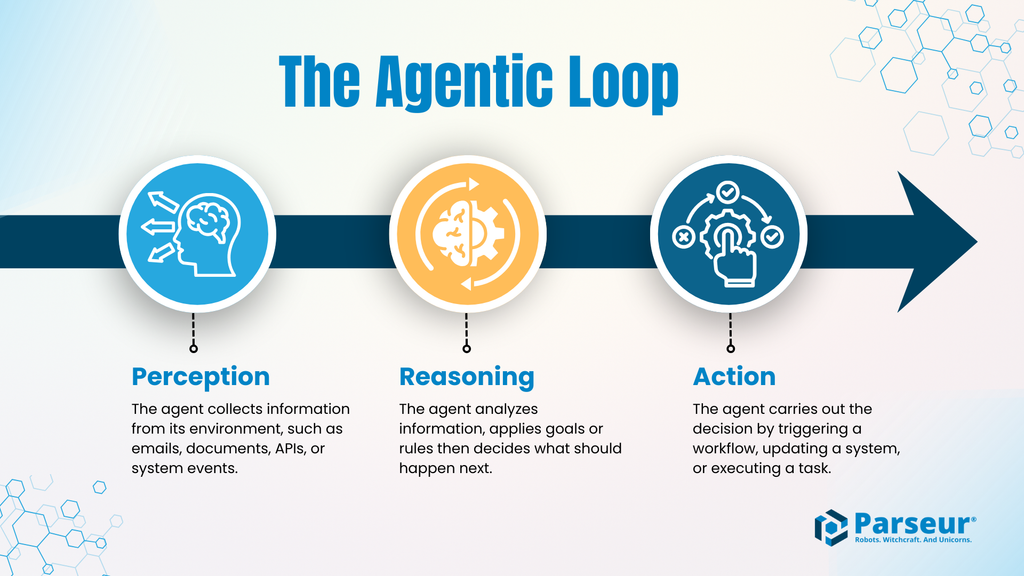
Agentische KI bricht diese Annahme. Diese Systeme sind darauf ausgelegt, Ziele über mehrere Schritte hinweg zu verfolgen – Akten abzurufen, Tests anzuordnen, Dokumentation zu entwerfen, Nachsorgetermine zu planen und einen Plan zu überarbeiten, wenn neue Informationen eintreffen. Ein am 2. Oktober 2026 in Nature Medicine veröffentlichtes Paper mit dem Titel „The missing links in agentic AI autonomy“ nimmt die dadurch entstehende Lücke ins Visier. Sein Gegenstand ist nicht die Modellgenauigkeit, sondern Vertrauen: genauer gesagt das operationale und das dezisionale Vertrauen, das vorhanden sein muss, bevor autonome Systeme sinnvoll an der Versorgung teilnehmen dürfen.
Diese Rahmung ist eine bewusste Abkehr von der Art und Weise, wie das Feld üblicherweise über KI-Sicherheit diskutiert. Die meisten Debatten behandeln Vertrauen als nachgelagerte Folge von Leistung – baue ein besseres Modell, und das Vertrauen wird folgen. Dieses Paper legt nahe, dass die Beziehung auch in die andere Richtung verläuft: Ohne Strukturen, die Vertrauen messbar und verdient machen, können selbst hervorragende Modelle nicht sicher delegiert werden.
Zwei Arten von Vertrauen, nicht eine
Der nützlichste Schachzug des Papers besteht darin, Vertrauen in zwei Kategorien zu unterteilen. Die Unterscheidung ist wichtig, weil die beiden auf sehr unterschiedliche Weise versagen, und ihre Vermischung verbirgt, wo die eigentlichen Probleme liegen.
Operationales Vertrauen
Operationales Vertrauen betrifft die Frage, ob ein System zuverlässig das tut, was es zu tun vorgibt, und zwar in der Umgebung, in der es tatsächlich eingesetzt wird. Kann es die richtigen Datenquellen erreichen? Versagt es kontrolliert, wenn eine Akte fehlt, eine Abfrage zeitlich ausläuft oder sich eine Schnittstelle ändert? Verschlechtert es sich in einer Weise, die ein beaufsichtigender Mensch erkennen kann, oder erzeugt es still und leise selbstsicheren Unsinn? Das mögen technische Fragen sein, doch im klinischen Umfeld tragen sie klinisches Gewicht. Ein System, das stillschweigend ein Laborergebnis verliert, ist nicht bloß fehlerhaft; es kann potenziell schaden.
Dezisionales Vertrauen
Dezisionales Vertrauen ist enger gefasst und schwieriger zu etablieren. Es betrifft die Frage, ob die Urteile, die ein System fällt – welche Handlung ergriffen wird, in welcher Reihenfolge und, entscheidend, wann es aufhört – es verdienen, sich auf sie zu verlassen. Ein System kann operational makellos sein und dennoch Entscheidungen treffen, die ein Kliniker rundweg ablehnen würde. Umgekehrt kann ein System mit wackeliger Infrastruktur in einem engen Fenster, in dem nichts kaputtgeht, gut reasoning betreiben. Diese beiden als eine einzige Variable zu behandeln, wie es ein Großteil der aktuellen Diskussion tut, verdeckt die Tatsache, dass die Behebung des einen nichts für das andere bewirkt.

Warum Autonomie das Risikokalkül verändert
Ein konventionelles klinisches KI-Werkzeug sitzt in einem Workflow und wartet. Es beantwortet eine Frage, und die Antwort wird überprüft. Agentische Systeme tun etwas anderes: Sie halten einen Faden. Sie treffen Zwischenentscheidungen, von denen einige folgenreich sind, und diese Entscheidungen summieren sich. Die Person, die nominell die Verantwortung trägt, sieht möglicherweise nur die Zusammenfassung am Ende.
Diese Kumulation macht die Vertrauensfrage dringlich statt philosophisch. Jeder zusätzliche Schritt, den ein System ohne Kontrollpunkt unternimmt, vervielfacht die Zahl der Stellen, an denen ein Fehler eindringen kann, und die Zahl der nachgelagerten Entscheidungen, die ihn erben. Menschliche Aufsicht, die für eine einzelne Vorhersage funktioniert, skaliert nicht automatisch auf eine Kette von zehn Handlungen, die über einen Nachmittag hinweg ausgeführt werden.
Das Gesundheitswesen verschärft dies zusätzlich, weil die Domäne ungewöhnlich wenig Nachsicht mit genau jenen Fehlermodi zeigt, die agentische Systeme am ehesten aufweisen: Selbstüberschätzung, plausibel klingende Fabrikation und Schwierigkeiten, die Grenzen der eigenen Kompetenz zu erkennen. Ein Chatbot, der eine Quelle erfindet, ist peinlich. Ein System, das eine Medikamenteninteraktion erfindet und danach handelt, ist etwas ganz anderes.
Die fehlenden Glieder
Wenn die Argumentation des Papers lautet, dass Autonomie mehr als Leistungsfähigkeit erfordert, ist die naheliegende nächste Frage, was tatsächlich fehlt. Mehrere Lücken tauchen im gesamten vom Paper behandelten Terrain wiederholt auf.
- Evaluation, die zur Aufgabe passt. Statische Benchmarks messen einzelne Antworten, nicht Sequenzen von Entscheidungen. Es gibt keine ausgereifte Praxis dafür, zu bewerten, ob der Plan eines Agenten vernünftig war, sondern nur dafür, ob seine endgültige Ausgabe mit einer Referenz übereinstimmte.
- Auditierbarkeit des Reasonings. Wenn ein System eine Handlung vornimmt, ist die Aufzeichnung darüber, warum es dies tat, oft dünn oder nachträglich rekonstruiert. Ohne vertrauenswürdige Spuren wird Aufsicht zum Theater.
- Wohldefinierte Eskalation. Agentische Systeme brauchen klare, zuverlässige Punkte, an denen sie die Kontrolle an einen Menschen zurückgeben. Zu viele Übergaben machen das System nutzlos; zu wenige machen es gefährlich, und der richtige Schwellenwert ist kontextabhängig.
- Governance, die Autonomie vorwegnimmt. Regulatorische Rahmenwerke, die um Geräte und Diagnostika herum aufgebaut sind, lassen sich nicht sauber auf Systeme übertragen, deren Verhalten sich mit jedem Einsatzkontext ändert.
- Gemeinsame Definitionen. Ohne vereinbarte Begrifflichkeit dafür, was als operationales versus dezisionales Vertrauen zählt, können Institutionen sich nicht austauschen, und jeder Einsatz erfindet seine eigenen Standards isoliert neu.
Wie verdiente Autonomie tatsächlich aussehen würde
Die implizite Vorschrift des Papers lautet, dass Autonomie schrittweise und evidenzbasiert gewährt werden sollte, nicht aufgrund von Benchmark-Ergebnissen angenommen. Das impliziert eine recht anspruchsvolle Reihe institutioneller Gepflogenheiten.
- Einsätze, die mit engen, umkehrbaren Handlungen beginnen und den Umfang erst erweitern, wenn Evidenz sich ansammelt.
- Monitoring, das die Entscheidungsqualität über die Zeit verfolgt, nicht nur Verfügbarkeit und Latenz.
- Klare Rechenschaft: ein benannter Mensch oder ein Gremium, das verantwortlich ist, wenn eine automatisierte Handlung Schaden verursacht.
- Dokumentation, die rigoros genug ist, dass ein unabhängiger Prüfer rekonstruieren kann, was geschah und warum.
Nichts davon ist glamourös. Es ist das Bindegewebe, das ein leistungsfähiges System in ein vertrauenswürdiges verwandelt, und genau diese Schicht wird tendenziell übersprungen, wenn das zugrunde liegende Modell beeindruckend genug ist, um Begeisterung zu erzeugen.
Die unbequeme Schlussfolgerung
Die herausforderndste Implikation des Nature-Medicine-Papers ist, dass die fehlenden Glieder in der Autonomie agentischer KI möglicherweise überhaupt nicht technisch sind. Bessere Modelle werden operationales Vertrauen leichter erreichbar machen – schneller, zuverlässiger, weniger brüchig. Doch dezisionales Vertrauen hängt von Fragen ab, die keine Architektur löst: Wer ist rechenschaftspflichtig, was gilt als akzeptables Risiko, wie viel Aufsicht ist genug, und wer entscheidet darüber.
Das sind institutionelle und klinische Fragen, und das Gesundheitswesen verfügt über Jahrzehnte hart erarbeiteter Erfahrung damit, sie für menschliche Praktizierende zu beantworten. Die vor uns liegende Arbeit besteht darin, diese Erfahrung auf Systeme auszudehnen, die handeln statt bloß zu antworten. Bis das geschieht, lautet die ehrliche Beschreibung der meisten agentischen KI in der Medizin nicht autonom. Sie ist unbeaufsichtigt, was etwas völlig anderes ist.
Dieser Artikel basiert auf Berichterstattung von Nature Medicine. Lesen Sie den Originalartikel.
Originally published on nature.com