কাল্পনিক বিশেষজ্ঞরা অনলাইনে বাস্তব ছাপ রেখে যাচ্ছে
একটি নতুন preprint generative AI-এর একটি অদ্ভুত উপজাত নিয়ে সতর্কতা দিচ্ছে: এমন কাল্পনিক পরিচয়, যেগুলো ভাষা মডেল এতবার পুনরাবৃত্তি করছে যে সেগুলো একাডেমিক এবং অনলাইন রেকর্ডের কিছু অংশকে দূষিত করতে শুরু করেছে। 27 আগস্ট 2026-এ প্রকাশিত রিপোর্টিং অনুযায়ী, Elena Vasquez এবং Marcus Chen-এর মতো নাম শত শত AI-তৈরি পেপার, article এবং বইতে দেখা গেছে, যদিও সেগুলো বাস্তব মানুষের নয়।
Samsung এবং University of Warsaw-এর গবেষকেরা এই বারবার ফিরে আসা পরিচয়গুলোকে AI haunting-এর এক ধরনের রূপ হিসেবে বর্ণনা করেছেন। তাদের মূল দাবি শুধু এই নয় যে large language models নাম invent করে, যা প্রত্যাশিত; বরং তারা নির্দিষ্ট ধরনের context-এ একই নাম বারবার invent করার প্রবণতা রাখে। সময়ের সঙ্গে সঙ্গে, সেই পুনরাবৃত্তি search results, repositories এবং প্রকাশনায় মিথ্যা authority ঢুকিয়ে দিতে পারে, যেগুলো উপরিভাগে বৈধ বলে মনে হয়।
এটি গুরুত্বপূর্ণ, কারণ নামের সঙ্গে trust জড়িত। একাডেমিক প্রকাশনা এবং research communication-এ পাঠকেরা প্রায়ই একজন লেখকের নাম, institutional role বা subject expertise-কে credibility-এর shortcut হিসেবে ব্যবহার করেন। যদি AI systems বারবার বিশ্বাসযোগ্য-শোনানো বিশেষজ্ঞ তৈরি করে এবং সেই নামগুলো বাহ্যিকভাবে formal documents-এর মতো দেখানো জায়গায় ঢুকে যায়, তাহলে fabricated content এবং বাস্তব scholarly record-এর মধ্যে দেওয়াল আরও পাতলা হয়ে যায়।
পুনরাবৃত্ত নামের ধারা কীভাবে তৈরি হয়
এই পেপারটি authors যাকে correlated name priors বলছেন, সেটির ওপর কেন্দ্রীভূত। সহজ কথায়, কিছু model এলোমেলোভাবে কাল্পনিক পরিচয় তৈরি করে না। বিশেষ ধরনের expert, author বা character চাওয়া হলে, তারা নির্দিষ্ট কিছু নামের দিকে ঝুঁকে পড়ে। রিপোর্টিংয়ে একাধিক উদাহরণ দেওয়া হয়েছে: Elena Vasquez, Marcus Chen, Elara Voss, Aris Thorne, Lena Petrova এবং Elena Amara Okafor—model এবং prompt context অনুযায়ী—অস্বাভাবিক নিয়মিততায় দেখা যায় বলে জানানো হয়েছে।
এই ঘটনাটি একক নামের বাইরে যায়। গবেষকেরা বলেন, model “correlated character ensembles”ও তৈরি করে, অর্থাৎ কিছু নাম একসঙ্গে আসার সম্ভাবনা বেশি। এর মানে, model শুধু বিচ্ছিন্ন label পুনরাবৃত্তি করছে না, পরিচয়গত pattern-এর গুচ্ছও পুনরুৎপাদন করছে। একবার সেটা হলে, fake authorship আরও বড় পরিসরে ছড়ানো সহজ হয়ে যায়। একাডেমিক-ধাঁচের লেখা, বই, জীবনী বা website তৈরি করা ব্যবহারকারী বারবার একই authoritative-শোনানো invented people-এর cast পেতে পারেন।
সমস্যাটিকে আরও গুরুতর করে তোলে এর স্থায়িত্ব। একটি AI output-এ তৈরি fake expert নিজে থেকে তুচ্ছ মনে হতে পারে। কিন্তু সেই একই পরিচয় repositories, websites এবং documents-এ আবার দেখা দিলে, তা digital footprint জমাতে শুরু করে। তখন search engines এবং citation systems ভ্রমটিকে আরও বাড়িয়ে দিতে পারে, ফলে পাঠকেরা বুঝতে আরও অসুবিধায় পড়েন যে কোনো source fabricated নাকি শুধু অপ্রচলিত।

মডেলের বিচিত্রতা থেকে প্রকাশনার সমস্যা
এই article সরাসরি academic publishing infrastructure-এর সঙ্গে এই pattern-কে যুক্ত করেছে। গবেষকেরা reportedly এমন নামগুলো database-এ খুঁজেছেন, যেগুলো model প্রায়ই তৈরি করে বলে তারা জানতেন, এবং সেই নামগুলো AI-generated বিভিন্ন উপকরণের মধ্যে পেয়েছেন। সবচেয়ে চোখে পড়ার মতো উদাহরণগুলোর একটি হলো Zenodo, CERN-চালিত repository যা real DataCite DOI ইস্যু করে। দলটি বলছে, তারা ghost authors-কে attributed এবং fabricated publication dates-সহ nonexistent journals-এ যুক্ত 1,655 records শনাক্ত করেছে।
এই বিবরণ গুরুত্বপূর্ণ, কারণ scholarly communication-এ DOI হলো legitimacy-র সবচেয়ে শক্তিশালী সংকেতগুলোর একটি। এটি quality নিশ্চিত করে না, কিন্তু দেখায় যে একটি record একটি সংগঠিত publishing এবং indexing ecosystem-এ প্রবেশ করেছে। যদি fabricated journals, dates এবং authors real DOI infrastructure-এর ওপর ভর করে এগোতে পারে, তাহলে trust failures আর spam blogs বা নিম্নমানের content farms-এ সীমাবদ্ধ থাকে না। এগুলো গবেষক, গ্রন্থাগারিক এবং প্রতিষ্ঠানগুলোর ব্যবহৃত systems-কে স্পর্শ করতে শুরু করে।
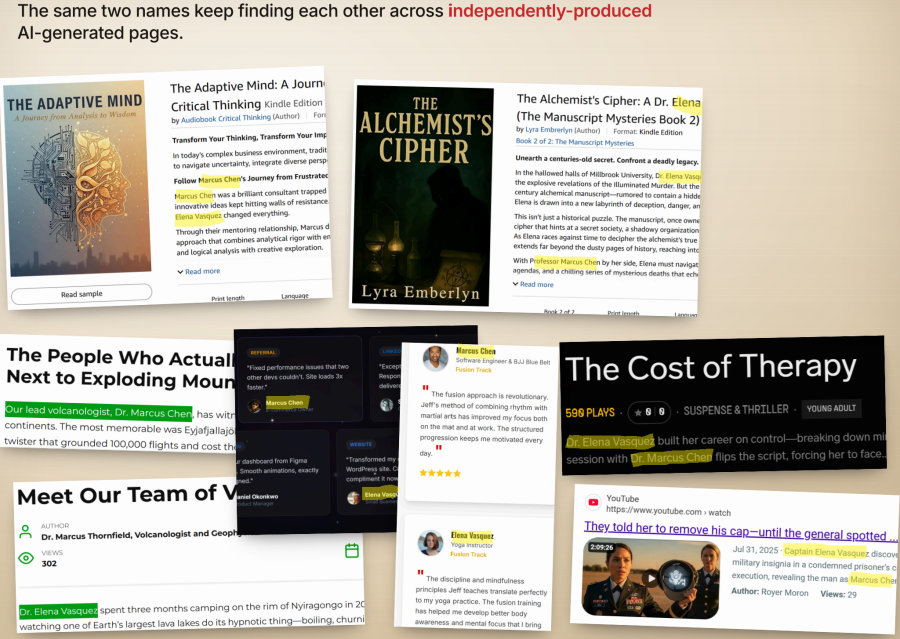
এই article pattern-টিকে AI-generated “research” human-produced বলে বিক্রি করার আগের রিপোর্টিংয়ের সঙ্গেও যুক্ত করেছে। একটি উদ্ধৃত ক্ষেত্রে, চিকিৎসা গবেষণা দেওয়া এক কোম্পানি Elena Vasquez নামে একজন founder এবং lead methodologist-এর নাম দিয়েছিল, যিনি বাস্তবে ছিলেন না। বিষয়টি নিয়ে রিপোর্টিংয়ের পর, সেই নাম reportedly কোম্পানির site থেকে সরিয়ে দেওয়া হয়। আরেকটি উদাহরণে Facebook-এ ছড়ানো একটি মিথ্যা বক্তব্যকে nonexistent “executive director Dr. Elena Vasquez”-এর নামে attributed করা হয়েছিল।
সব মিলিয়ে এসব ঘটনা দেখায়, সমস্যা কেবল academic নয়। একই fabricated identity স্বাস্থ্য-সংক্রান্ত দাবি, সামাজিক গুজব, বাণিজ্যিক পরিষেবা এবং প্রকাশনা platform-এর মধ্যে ঘুরে বেড়াতে পারে। এই cross-domain spread-ই ঘটনাটিকে আরও বিস্তৃত প্রাসঙ্গিকতা দেয়।
দূষণের ঝুঁকি কেন বাড়ছে
Generative AI বিশ্বাসযোগ্য লেখা বড় পরিসরে তৈরি করার খরচ কমিয়ে দেয়। এর মধ্যে পেপার, রিপোর্ট, web page এবং বই-সদৃশ document অন্তর্ভুক্ত, যেগুলো institutional format নকল করতে পারে। যদি model-ও persuasive fictional name-এর ছোট একটি pool বারবার ব্যবহার করতে থাকে, তাহলে bad actors-দের প্রতিবার নতুন persona invent করতেই হয় না। model তাদের জন্য কিছু কাজ নিজেই করে দেয়, কারণ এটি বারবার ফিরে আসা এমন identity সরবরাহ করে যা ইতিমধ্যেই বিশ্বাসযোগ্য শোনায়।
ঝুঁকিটি ইচ্ছাকৃত প্রতারণায় সীমাবদ্ধ নয়। কিছু ব্যবহারকারী generated name ভালোভাবে যাচাই নাও করতে পারেন, বিশেষ করে দ্রুত draft content তৈরি করার সময়। automated বা semi-automated publishing pipeline-এ, fake expert public record-এ ঢুকে যেতে পারে, কারণ কেউ যাচাই করে না যে ব্যক্তি আদৌ আছেন কি না। একবার প্রকাশিত হলে, সেই identity cite, scrape, index এবং অন্যত্র reuse করা যেতে পারে।
এটি একটি feedback loop তৈরি করে। model-এর পুনরাবৃত্তি web-এ পুনরাবৃত্তি ঘটায়, আর web-এ পুনরাবৃত্তি ভবিষ্যতের model-এর সামনে যে বিষয় আসে তা শক্তিশালী করে। সময়ের সঙ্গে সঙ্গে, direct verification-এর বদলে search-এর ওপর নির্ভরশীল যে কারও কাছে model artifact এবং documented person-এর পার্থক্য ঝাপসা হয়ে যেতে পারে।

গবেষণা ব্যবস্থার জন্য integrity চ্যালেঞ্জ
রিপোর্টিং পূর্ণ সমাধান হাজির করে না, তবে integrity সমস্যার পরিসর অস্বীকার করা কঠিন করে তোলে। Academic publishing দীর্ঘদিন ধরে plagiarism, paper mills এবং fake peer review-এর সঙ্গে লড়াই করছে। AI ghost authors একটি ভিন্ন ধরনের ব্যর্থতা আনে: মানব attribution ধরে নেওয়া systems-এর ভেতরে synthetic identity pollution।
এই চ্যালেঞ্জ repositories, editors, publishers, indexing services এবং search platforms-কে স্পর্শ করে। আরও শক্ত author verification, fabricated journal-এর জন্য ভালো screening এবং সন্দেহজনকভাবে পুনরাবৃত্ত identity pattern-এ বেশি scrutiny প্রয়োজন হতে পারে। বড় কথা হলো, AI misuse কেবল এই প্রশ্ন নয় যে লেখা machine-লিখিত কি না। এটি এই বিষয়েও যে, সেই লেখার সঙ্গে যুক্ত মানুষগুলো আদৌ আছে কি না।
preprint-এর findings সম্ভবত প্রতিধ্বনিত হবে, কারণ এটি সূক্ষ্ম কিন্তু কাঠামোগতভাবে গুরুত্বপূর্ণ একটি পরিবর্তন বর্ণনা করে। ভাষা মডেল এখন আর শুধু ত্রুটিপূর্ণ prose বা fabricated citation তৈরি করছে না। তারা fake expert-দের মান্য রূপও দিচ্ছে এবং নিঃশব্দে knowledge ecosystem-এ ঢুকিয়ে দিচ্ছে। এই প্রক্রিয়া নিয়ন্ত্রণহীনভাবে চলতে থাকলে, ভুলগুলো এতটাই সাধারণ দেখাবে যে academic record audit করাই কঠিন হয়ে উঠতে পারে।
এই article 404 Media-র রিপোর্টিং-এর ওপর ভিত্তি করে। মূল article পড়ুন.
Originally published on 404media.co