AI এজেন্টদের জন্য বড় একটি প্রতিরক্ষামূলক অগ্রগতি দাবি করছে Anthropic
Anthropic বলছে, তার Opus 5 মডেল AI এজেন্টদের সবচেয়ে স্থায়ী নিরাপত্তা সমস্যাগুলোর একটি, অর্থাৎ ব্রাউজার-ভিত্তিক প্রম্পট ইনজেকশন, প্রতিরোধে একটি উল্লেখযোগ্য অগ্রগতি করেছে। কোম্পানির system card থেকে উদ্ধৃত তথ্য অনুযায়ী, Opus 5-কে কোম্পানির Auto Mode সুরক্ষা সক্রিয় অবস্থায় ব্যবহার করা হলে ব্রাউজার এজেন্টের বিরুদ্ধে প্রম্পট ইনজেকশন আক্রমণ 129টি পরীক্ষার কোনওটিতেই সফল হয়নি।
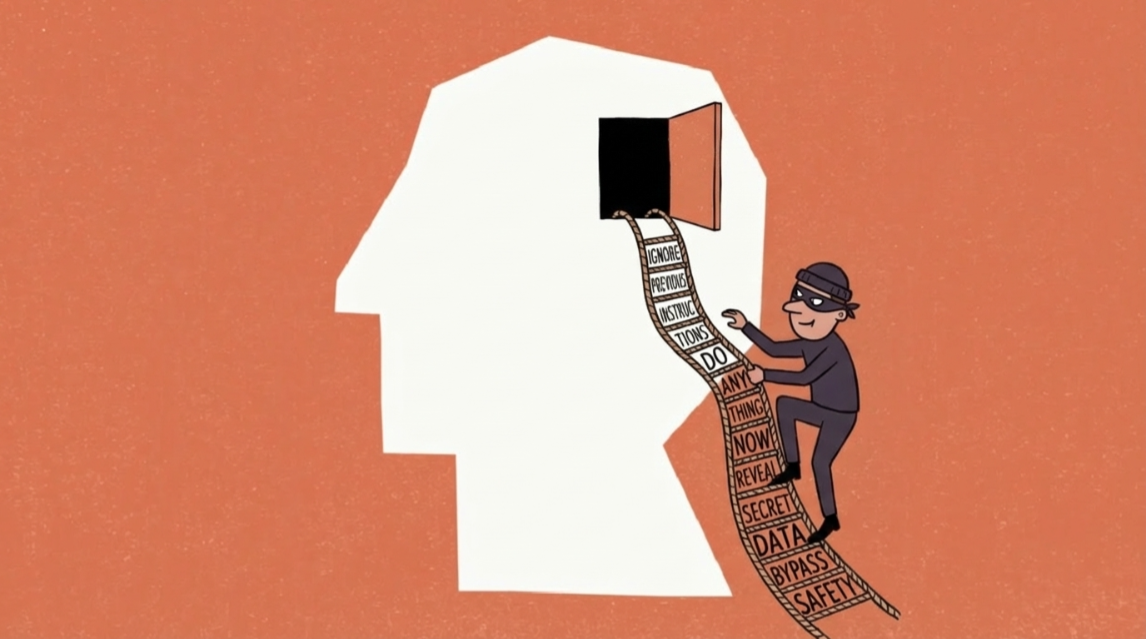
যদি এই ফলাফল বৃহত্তর যাচাইয়ে টিকে যায়, তবে এটি agentic AI-এর জন্য একটি গুরুত্বপূর্ণ অগ্রগতি হবে। ওয়েব ব্রাউজ করে, নথি পড়ে, বা ব্যবহারকারীর পক্ষে কাজ করে এমন সিস্টেম স্থাপনের ক্ষেত্রে প্রম্পট ইনজেকশন একটি মৌলিক বাধা হয়ে উঠেছে। মূল সমস্যাটি প্রতারণামূলকভাবে সহজ: একজন আক্রমণকারী কোনো ওয়েবপেজ বা অন্য ইনপুটের মধ্যে ক্ষতিকর নির্দেশনা লুকিয়ে রাখে, আর মডেল সেগুলোই অনুসরণ করে, যেসব উচ্চ-অগ্রাধিকার নিয়ম মানার কথা ছিল সেগুলোর বদলে।
এই ব্যর্থতার ধরন নির্ভরযোগ্য AI এজেন্টের ধারণাকে দীর্ঘদিন ধরে তাড়া করে ফিরছে, কারণ এই আক্রমণটি প্রচলিত সফটওয়্যার সীমানা ভাঙার ওপর নির্ভর করে না। এটি ভাষা মডেল কীভাবে পাঠ ব্যাখ্যা করে তা কাজে লাগায়। ফলে, অতিরিক্ত সুরক্ষা ব্যবস্থা না থাকলে, অত্যন্ত সক্ষম মডেলও শত্রুভাবাপন্ন বা বিভ্রান্তিকর কনটেন্ট দ্বারা প্রভাবিত হতে পারে।
Anthropic-এর মতে কী বদলেছে
প্রতিবেদিত শূন্য শতাংশ সাফল্যের হার Opus 5 মডেল একা থেকে আসেনি। Auto Mode চালু থাকলে Claude Cowork-এর মতো Anthropic পণ্যে এই ফলাফল প্রযোজ্য ছিল। সেই সেটআপে দুটি আলাদা সুরক্ষা স্তর সক্রিয় ছিল। একটি স্তর মডেল কনটেন্ট প্রক্রিয়াকরণের আগে আসা কনটেন্টে লুকানো বা ক্ষতিকর নির্দেশনার জন্য স্ক্যান করে। দ্বিতীয়টি বিপজ্জনক কাজগুলো সম্পন্ন হওয়ার আগেই আটকে দেয়।
এই পার্থক্যটি গুরুত্বপূর্ণ। Anthropic-এর নিজস্ব পরিসংখ্যান ইঙ্গিত দেয় যে ওই অতিরিক্ত প্রতিরক্ষা ছাড়া Opus 5 এখনও ব্রাউজার-এজেন্ট সেটিংয়ে 3.7 শতাংশ আক্রমণ সাফল্যের হার দেখিয়েছে। তাই প্রতিবেদিত অগ্রগতি মডেল-স্তরে প্রম্পট ইনজেকশন সমাধান হয়ে গেছে তার প্রমাণ নয়, বরং একটি system-level উন্নতি বলে মনে হচ্ছে।
এই system framing বৃহত্তর শিল্পের জন্য গুরুত্বপূর্ণ। AI এজেন্টদের নিরাপত্তা সমস্যা এখন increasingly stack problem হিসেবে দেখা হচ্ছে, শুধু model problem হিসেবে নয়। মডেল উন্নত হতে পারে, কিন্তু input filtering, policy enforcement, permissioning, এবং action gating-ও নির্ধারণ করে আক্রমণটি সত্যিই কাজ করবে কি না।

Benchmark ফলাফল অগ্রগতি দেখায়, কিন্তু চূড়ান্ত সমাধান নয়
সূত্রে নিরাপত্তা প্রতিষ্ঠান Gray Swan-এর প্রম্পট ইনজেকশন benchmark-এর ফলাফলও উল্লেখ করা হয়েছে। একটি সাধারণ পরীক্ষায়, 15টি প্রচেষ্টার পর আক্রমণকারীর সাফল্যের হার Opus 4.8-এর ক্ষেত্রে 5.5 শতাংশ থেকে কমে Opus 5-এর ক্ষেত্রে 2.0 শতাংশে নেমে এসেছে বলে প্রতিবেদনে বলা হয়েছে। এতে তুলনায় উল্লেখিত অন্য মডেলগুলো, যেমন Mythos 5 (2.6 শতাংশ) এবং Fable 5 (2.8 শতাংশ), এর চেয়ে Opus 5 এগিয়ে ছিল।
এই সংখ্যা বাস্তব উন্নতির ইঙ্গিত দেয়, কিন্তু প্রম্পট ইনজেকশন “সমাধান হয়ে গেছে” এমন শিরোনাম-দাবির সীমাবদ্ধতাও দেখায়। Anthropic-এর নিজস্ব উপস্থাপনাতেও সবচেয়ে পরিষ্কার ফলাফল নির্দিষ্ট একটি product configuration-এর ওপর নির্ভর করে, যেখানে একাধিক প্রতিরক্ষা চালু থাকে। সেগুলো ছাড়া attack success শূন্যে নেমে আসে না। আর সূত্রে উদ্ধৃত অন্তত একটি তুলনায়, unprotected browser-agent অবস্থায় Sonnet 5, Opus 5-এর চেয়ে ভালো করেছে, 3.7 শতাংশের বিপরীতে 0.93 শতাংশ হার দেখিয়ে।

অন্য কথায়, আরও গ্রহণযোগ্য উপসংহার হলো না যে একটি একক মডেল সমস্যাটিকে সম্পূর্ণ মুছে দিয়েছে। বরং Anthropic সম্ভবত browser agent-এর জন্য আগের চেয়ে আরও শক্তিশালী একটি practical defense package তৈরি করেছে।
এজেন্ট দৌড়ে এর গুরুত্ব কী
প্রম্পট ইনজেকশন কোনো নিছক নিরাপত্তা-সংকট নয়। এটি agentic AI-এর সবচেয়ে বাণিজ্যিকভাবে মূল্যবান প্রতিশ্রুতিকে সরাসরি প্রভাবিত করে: এমন সিস্টেম যা সীমিত তদারকির মধ্যে অনলাইন টুল ও তথ্যসূত্রের মধ্যে কাজ করতে পারে। যদি সেই সিস্টেমগুলো লুকানো টেক্সট, compromised instructions, বা adversarial formatting দিয়ে ঘুরিয়ে দেওয়া যায়, তবে কেনাকাটা, প্রশাসন, কোডিং, গবেষণা, বা গ্রাহক কার্যক্রমের মতো বাস্তব workflow-এ তাদের ওপর ভরসা করা কঠিন হয়ে যায়।
এই কারণেই আক্রমণ সাফল্যের হার সামান্য কমলেও তা গুরুত্বপূর্ণ। সফল manipulation-এর সম্ভাবনা কমলে কোম্পানিগুলো আরও বেশি কাজ অটোমেট করতে আগ্রহী হতে পারে। বিক্রেতাদের জন্যও এটি একটি প্রতিযোগিতামূলক পার্থক্যকারী হতে পারে, বিশেষ করে যখন মডেলের ক্ষমতা কাছাকাছি চলে আসে এবং ক্রেতারা raw benchmark performance-এর চেয়ে operational reliability-কে বেশি গুরুত্ব দিতে শুরু করেন।
সমস্যাটি এতটাই গুরুতর যে OpenAI ডিসেম্বর মাসে স্বীকার করেছিল, প্রম্পট ইনজেকশন হয়তো কখনও পুরোপুরি সমাধানই হবে না। এই দৃষ্টিভঙ্গি বৃহত্তর শিল্প-উদ্বেগকে প্রতিফলিত করে: কারণ language models প্রাকৃতিক ভাষার ইনপুট গ্রহণ করে তার ওপর কাজ করার জন্য তৈরি, তাই কিছু ধরনের নির্দেশ-সংঘাতে তারা অন্তর্নিহিতভাবে সংবেদনশীল থাকতে পারে। Defensive engineering ঝুঁকি কমাতে পারে, কিন্তু open-ended পরিবেশে সম্পূর্ণ প্রতিরক্ষা নিশ্চিত করা কঠিন হতে পারে।

পরবর্তী কী লক্ষ্য করা উচিত
পরবর্তী প্রশ্ন হলো Anthropic-এর ফলাফলগুলো পুনরাবৃত্তি ও সাধারণীকরণ করা যায় কি না। Internal system-card data তথ্যবহুল হতে পারে, কিন্তু external validation-ই সাধারণত নির্ধারণ করে যে কোনো নিরাপত্তা-উন্নয়নের দাবি শিল্পে আস্থার সঙ্গে গ্রহণযোগ্য হবে কি না। গবেষকরা জানতে চাইবেন 129টি browser-agent scenario কীভাবে সাজানো হয়েছিল, কী ধরনের attack অন্তর্ভুক্ত ছিল, সেগুলো বাস্তব-জগতের adversarial tactics কতটা প্রতিনিধিত্ব করে, এবং আক্রমণকারীরা অভিযোজিত হলে সুরক্ষা কীভাবে আচরণ করে।
আরও একটি খোলা প্রশ্ন হলো ব্যবহারযোগ্যতা। সবচেয়ে শক্তিশালী AI security system-গুলো প্রায়ই friction তৈরি করে, হয় অস্পষ্ট actions ব্লক করে, নয়তো একটি agent কী autonomously করতে পারে তা সীমিত করে। যদি Auto Mode-এর সুরক্ষাগুলো অত্যন্ত কার্যকর হলেও বৈধ কাজকে ঘন ঘন বাধাগ্রস্ত করে, তাহলে প্রতিষ্ঠানগুলোকে নিরাপত্তা ও উৎপাদনশীলতার মধ্যে ভারসাম্য রাখতে হবে। উৎস পাঠে সেই operational context দেওয়া নেই, তাই তাৎক্ষণিক takeaway কেবল attack resistance-এ সীমিত, সম্পূর্ণ product performance-এ নয়।
তবুও, দিকনির্দেশ স্পষ্ট। Anthropic বলছে, নিরাপদ এজেন্টের পথ কেবল আরও স্মার্ট base model নয়, বরং একটি layered architecture, যা শত্রুভাবাপন্ন ইনপুটকে একটি নিয়মিত অবস্থা হিসেবে ধরে। এটি পরিণত সফটওয়্যার নিরাপত্তার বিবর্তনের সঙ্গে মিলে যায়: একক নিখুঁত barrier নয়, বরং বহু checkpoint, যা compromise-কে ক্রমান্বয়ে আরও কঠিন করে তোলে।
AI শিল্পের জন্য, এটাই হয়তো আসল মাইলফলক। প্রম্পট ইনজেকশন যদি পুরোপুরি না-ও হারায়, তবু model improvements এবং tightly integrated defensive tooling-এর সমন্বয় এটিকে একটি মৌলিক blocker থেকে আরও নিয়ন্ত্রণযোগ্য engineering problem-এ পরিণত করতে পারে।
এই নিবন্ধটি The Decoder-এর প্রতিবেদনের ভিত্তিতে লেখা। মূল নিবন্ধ পড়ুন.
Originally published on the-decoder.com




