AI அளவுகோல்கள் முன்னேற்றத்தை ஒப்பிட உதவுகின்றன. ஒரு மாதிரி தரநிலைப்படுத்தப்பட்ட தேர்வை எழுதுகிறது; அதன் மதிப்பெண் ஒப்பீட்டுக்கான எளிய வழியாகிறது. ஆனால் இந்த எளிமை, அளவுகோல் தான் அளவிட வேண்டிய துறையை மாற்றும் பிரச்சினையை மறைக்கலாம்.
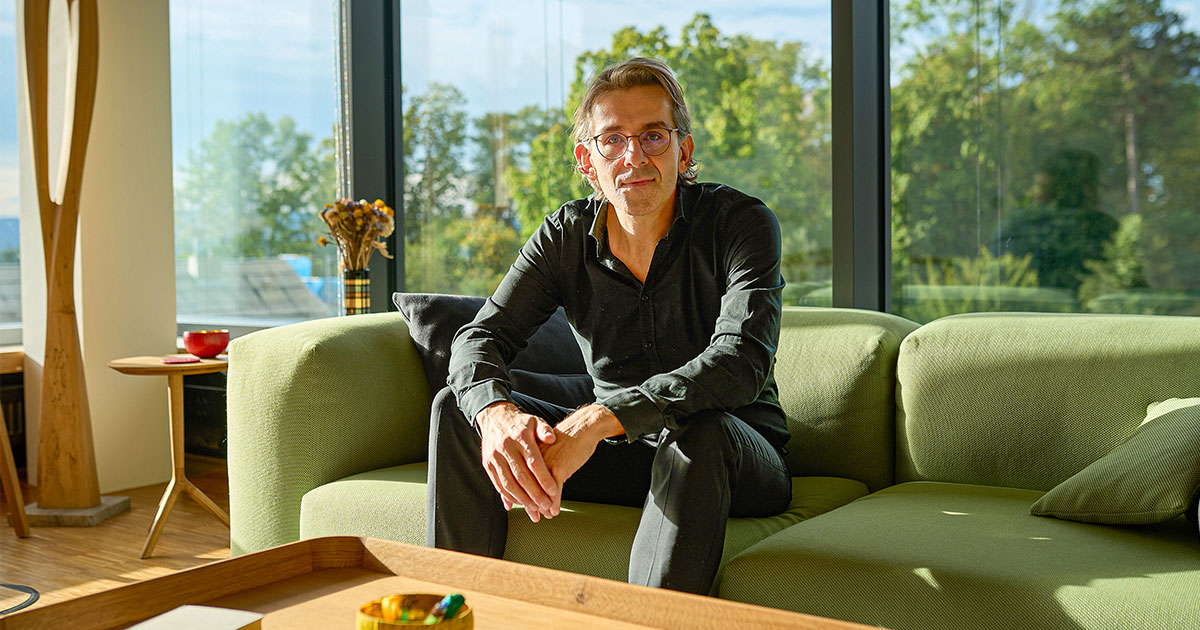
கணினி விஞ்ஞானி Moritz Hardt, நவீன AI அளவீட்டு முறை அடிப்படையில் குறைபாடுடையது என்கிறார். மதிப்பெண்கள் அறிவுத்திறன் அல்லது நிஜ உலக நம்பகத்தன்மைக்கான ஆதாரமாக கருதப்படுவதே அவரது கவலை.
மதிப்பெண் இலக்காகும் போது
ஒரு அளவீடு இலக்காக மாறினால், மக்கள் அதையே மேம்படுத்தத் தொடங்குவார்கள். machine learningல், இது ஒரு குறிப்பிட்ட dataset அல்லது leaderboardல் சிறப்பாக செயல்படும் ஆனால் விரிவான திறன் இல்லாத அமைப்புகளை உருவாக்கலாம்.
அமைப்புகள் “அறிவார்ந்த எதையும் செய்யாமல்” leaderboardல் உயரலாம் என Hardt எச்சரித்துள்ளார். அதிக மதிப்பெண் உண்மையான முன்னேற்றமாக இருக்கலாம்; ஆனால் அது தேர்வின் தனிச்சிறப்புகளுக்கு ஏற்ற மாற்றமாகவும் இருக்கலாம்.
பெரிய language modelsக்கான புதிய சோதனைகள் தொடர்ந்து வருகின்றன. அவை பயனுள்ள ஆதாரங்களை அளிக்கலாம்; ஆனால் அவற்றை உருவாக்கி தீர்க்கும் வேகம் ஒரு குறுகிய போட்டியை உருவாக்குகிறது.
அதிகப்படியான தாக்கத்தின் வரலாறு
அளவுகோல்கள் AI ஆய்வின் திசையை பலமுறை மாற்றியுள்ளன. 1987ல் Defense Advanced Research Projects Agency speech-to-text அளவுகோல், எளிய statistical முறைகளை முன்னணி அமைப்புகள் மிஞ்சவில்லை என்பதை காட்டியது. இதனால் AI மீதான ஆர்வமும் நிதியும் குறைந்தன.
2012ல் ImageNet ஒரு எட்டு அடுக்கு neural networkன் திறனை வெளிப்படுத்தி deep-learning புரட்சிக்கு உதவியது. அளவுகோல்கள் முன்னேற்றத்தை மட்டும் சுருக்குவதில்லை; முன்னேற்றம் என்றால் என்ன என்பதையும் தீர்மானிக்கின்றன.
Hardt தனது 2026 புத்தகமான The Emerging Science of Machine Learning Benchmarksல் அளவுகோல்களை “machine learningஐ உருவாக்கிய தவறு” என்கிறார். இருந்தாலும் அவை உண்மையான முன்னேற்றத்திற்கும் பங்களித்ததாக அவர் கூறுகிறார்.
சிறந்த மதிப்பீட்டுக்கு தேவையானவை
அளவீட்டை இறுதித் தேர்வாக அல்ல, தொடர்ச்சியான ஆய்வுப் பிரச்சினையாகக் காண வேண்டும். அளவுகோல் என்ன அளவிடுகிறது, அது பயன்படுத்தப்படும் சூழலை எவ்வளவு பிரதிபலிக்கிறது, மாதிரிகள் அதற்கேற்ப பயிற்றுவிக்கப்பட்டுள்ளனவா என்பதைக் கேட்க வேண்டும்.
சிக்கலான திறன்களை ஒரே எண்ணாக சுருக்குவதைத் தவிர்க்க வேண்டும். நடைமுறை பயன்பாட்டில் ஒரு மாதிரியின் வரம்புகளை அறிதல் உச்ச மதிப்பெண்ணைவிட முக்கியமானது.
தரநிலைப்படுத்தப்பட்ட மதிப்பீட்டை கைவிட வேண்டியதில்லை. பகிரப்பட்ட சோதனைகள் இல்லாமல் ஒப்பீடு கடினமாகும். அவற்றின் வரம்புகளை வெளிப்படையாகக் காட்டும் மதிப்பீடுகளே தேவை.
AI பயன்பாடு அதிகரிக்கும்போது stakes உயரும்
AI பல துறைகளில் பயன்படுத்தப்படுவதால் அளவுகோல் கூற்றுகள் ஆய்வகங்களைத் தாண்டுகின்றன. அவை கொள்முதல், முதலீடு மற்றும் அமைப்பு தயாரா என்ற முடிவுகளை பாதிக்கலாம்.
உயரும் leaderboard எப்போதும் ஆழமான அறிவுத்திறனை காட்டாது என Hardt நினைவூட்டுகிறார். மதிப்பெண்கள் ஆதாரங்கள்; இறுதி தீர்ப்புகள் அல்ல.
இந்தக் கட்டுரை Quanta Magazine செய்தியறிக்கையை அடிப்படையாகக் கொண்டது. அசல் கட்டுரையைப் படிக்கவும்.
Originally published on quantamagazine.org