Un réseau mondial prend forme
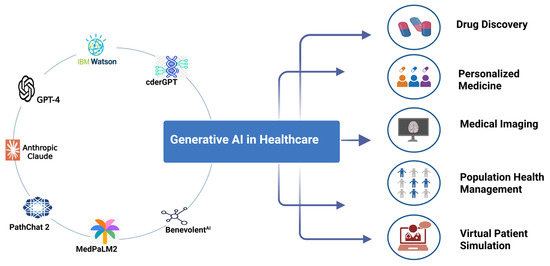
La revue Nature Medicine a publié un avis annonçant un nouveau réseau international appelé MAGIC, consacré à l'évaluation de l'intelligence artificielle générative en santé mondiale. La date de publication est le 6 octobre 2026, et le titre lui-même définit la portée de l'initiative : « MAGIC: an international network for evaluating generative artificial intelligence in global health ». Ce cadrage situe l'effort à l'intersection de deux domaines en évolution rapide : l'IA générative, qui comprend les grands modèles de langage et d'autres systèmes capables de créer du texte, des images ou du code, et la santé mondiale, où les décisions affectent des millions de personnes dans des contextes très variés.
Ce que le titre rend clair, c'est que MAGIC n'est pas présenté comme un outil unique, un modèle ou un essai clinique. Il est décrit comme un réseau. Ce choix compte. L'évaluation de l'IA en santé n'est pas un benchmark ponctuel ; c'est un processus continu impliquant de nombreux types d'expertise, de sources de données et de contextes locaux. Un réseau international est une manière d'organiser ce travail au-delà des frontières, des institutions et des disciplines.
Pourquoi l'évaluation est le défi central
L'IA générative est rapidement passée des laboratoires de recherche à des outils auxquels les cliniciens, les chercheurs et les responsables de la santé peuvent accéder. L'attrait est évident : ces systèmes peuvent résumer la littérature, rédiger des communications aux patients, soutenir le diagnostic, traduire des langues et aider au tri de l'information. Mais les risques sont également importants. En santé, une réponse assurée mais erronée peut causer un préjudice. Un modèle qui performe bien dans un pays peut échouer dans un autre en raison de différences de langue, de schémas pathologiques, de recommandations cliniques ou d'infrastructures.
L'évaluation est le pont entre une démonstration prometteuse et un outil sûr et utile. Elle pose la question de savoir si un système fait ce qu'il prétend, pour qui, dans quelles conditions et à quel coût. Pour la santé mondiale, ces questions deviennent encore plus exigeantes. De nombreux systèmes de santé disposent de ressources limitées pour l'évaluation technologique. Les données peuvent être rares ou non représentatives. Les cadres réglementaires peuvent être naissants. Un réseau comme MAGIC, comme l'indique son titre, est positionné pour combler ces lacunes par la collaboration plutôt que par des tests isolés.

Ce que « international » devrait signifier en pratique
Un réseau international peut apporter de la valeur de plusieurs manières. Il peut réduire les doublons en partageant les méthodes et les résultats d'évaluation. Il peut comparer les performances des modèles entre pays et langues. Il peut aider à renforcer les capacités locales afin que l'évaluation ne soit pas quelque chose qui est fait aux pays à revenu faible et intermédiaire, mais avec eux. Et il peut créer des canaux pour que les conclusions parviennent aux ministères de la santé, aux régulateurs et aux cliniciens de première ligne.
Mais le mot international soulève aussi des attentes. Un réseau international de nom seulement risquerait de reproduire les inégalités existantes. Une véritable collaboration internationale exige un leadership diversifié, un financement équitable et une attention à la souveraineté des données. L'annonce de publication ne fournit pas encore de détails sur l'adhésion, la gouvernance ou la méthodologie, de sorte que ces questions restent ouvertes. Néanmoins, le titre fixe un standard : si MAGIC doit évaluer l'IA générative pour la santé mondiale, il doit s'engager dans les contextes où les défis de santé mondiale sont les plus aigus.
Dimensions clés de l'évaluation
- Exactitude et fiabilité : le système produit-il des résultats corrects et cohérents pour la tâche à laquelle il est destiné ?
- Sécurité et modes de défaillance : comment se comporte-t-il lorsqu'il est incertain, lorsque les données d'entrée sont ambiguës ou lorsque les enjeux sont élevés ?
- Biais et équité : les performances et les bénéfices sont-ils répartis équitablement entre les populations, les langues et les systèmes de santé ?
- Utilité clinique : l'utilisation du système améliore-t-elle les décisions, les flux de travail ou les résultats pour les patients par rapport à la pratique existante ?
- Transparence et reproductibilité : des groupes indépendants peuvent-ils comprendre comment l'évaluation a été réalisée et la reproduire ?
- Gouvernance et responsabilité : qui est responsable lorsqu'un outil d'IA générative cause un préjudice, et comment les préoccupations sont-elles signalées et traitées ?
Le problème du rythme
Les modèles d'IA générative sont fréquemment mis à jour. Un système évalué ce mois-ci peut être remplacé ou affiné le mois suivant. Cela crée un défi pour tout réseau d'évaluation. Les benchmarks statiques deviennent rapidement obsolètes. Les régulateurs et les systèmes de santé ont besoin de moyens pour évaluer les modèles en continu, et pas seulement à un moment donné.
Un réseau international pourrait aider en élaborant des protocoles d'évaluation adaptatifs, des normes de reporting partagées et des mécanismes de surveillance après déploiement. Il pourrait également créer un vocabulaire commun pour décrire les capacités et les limites des modèles, ce qui faciliterait la compréhension par les non-spécialistes de ce qu'un outil peut et ne peut pas faire. Rien de tout cela n'est facile, mais l'alternative — une évaluation non coordonnée et opaque — est pire.
La santé mondiale n'est pas un marché unique
L'une des plus grandes erreurs en technologie de la santé est de traiter « mondial » comme synonyme de « général ». Les systèmes de santé diffèrent par leur charge de morbidité, leur main-d'œuvre, leurs chaînes d'approvisionnement, leurs normes culturelles et leurs cadres juridiques. Un outil d'IA générative conçu pour un hôpital bien doté en ressources peut être inutilisable dans une clinique rurale avec une électricité intermittente et une connectivité limitée. Un modèle principalement entraîné en anglais peut mal performer dans d'autres langues. L'évaluation doit donc être spécifique au contexte, même lorsque les méthodes sont partagées.
La structure internationale de MAGIC, telle que signalée par son titre, suggère une conscience de ce problème. Le modèle de réseau permet des études locales qui alimentent des comparaisons plus larges. Il crée également des opportunités de collaboration sud-sud, où des pays confrontés à des contraintes similaires peuvent apprendre les uns des autres plutôt que de toujours se tourner vers les pays à revenu élevé pour la validation.
Publication dans Nature Medicine : ce que cela signale
Apparaître dans Nature Medicine donne à l'initiative une visibilité auprès des cliniciens, des chercheurs et des décideurs politiques. Le public de la revue est large, couvrant la science fondamentale, la recherche clinique et la santé publique. Une publication dans cette revue peut aider à rassembler les parties prenantes et à signaler que l'évaluation de l'IA générative est une question scientifique et politique sérieuse, et non une simple curiosité technique.
En même temps, un avis de publication n'est pas un ensemble de résultats. L'extrait disponible pour MAGIC fournit le titre, la revue et la date de publication. Il ne décrit pas d'études spécifiques, d'institutions partenaires, de sources de financement ou de conclusions. Les lecteurs doivent donc considérer l'annonce comme le début d'une conversation, et non comme une conclusion. La valeur du réseau dépendra de ce qu'il produit : protocoles, jeux de données, évaluations et orientations pratiques que les systèmes de santé peuvent utiliser.
Ce qu'il faut surveiller ensuite
Plusieurs questions détermineront si MAGIC tient ses promesses. Qui le dirigera, et comment le leadership sera-t-il réparti entre les régions ? Comment gérera-t-il la confidentialité des données et la propriété intellectuelle ? Ses évaluations seront-elles indépendantes des entreprises dont les modèles sont testés ? Comment impliquera-t-il les communautés et les patients, et pas seulement les chercheurs et les technologues ? Et comment traduira-t-il les conclusions en politiques et en pratiques ?
Les réponses ne viendront pas d'un seul article. Elles émergeront au fil du temps, à travers les décisions de gouvernance, les choix de financement et les premières productions publiques du réseau. Pour l'instant, le titre seul établit une ambition importante : évaluer l'IA générative pour la santé mondiale par la collaboration internationale. C'est une ambition nécessaire. L'IA générative façonne déjà la manière dont les gens accèdent à l'information sanitaire et l'interprètent. Les systèmes qui soutiennent ce travail doivent être soumis à des normes rigoureuses, transparentes et pertinentes à l'échelle mondiale.
L'essentiel
MAGIC se présente comme un réseau international pour évaluer l'intelligence artificielle générative en santé mondiale, publié dans Nature Medicine le 6 octobre 2026. Sa prémisse centrale — que l'évaluation doit être coordonnée au-delà des frontières — est solide. Le travail difficile reste à faire : bâtir la confiance, partager les méthodes, affronter les inégalités et suivre le rythme de modèles qui changent plus vite que les cycles d'évaluation traditionnels. Si MAGIC y parvient, il offrira quelque chose dont le domaine a un besoin urgent : non pas un autre benchmark isolé, mais une infrastructure durable pour juger quand l'IA générative est sûre et utile en santé mondiale.
Cet article est basé sur un reportage de Nature Medicine. Lire l'article original.
Originally published on nature.com


