OpenAI constitue une main-d'œuvre dont le travail consiste à lire ce que les gens tapent dans ChatGPT. Un reportage de 404 Media révèle que l'entreprise recrute des centaines de sous-traitants chargés de traiter un flux important de requêtes réelles d'utilisateurs — des conversations que les plus de 900 millions d'utilisateurs du chatbot supposent généralement rester entre eux et la machine.
Ce que le média a examiné n'était pas une simple note interne divulguée, mais toute une trace documentaire : des guides d'instructions internes, des canaux Slack utilisés par les équipes de révision, de véritables requêtes ChatGPT et la grille de notation que les sous-traitants appliquent pour évaluer les réponses du modèle. Une grande partie de ce matériel se trouve sous une bannière interne que le média appelle le « Projet Lily », et il éclaire une facette du développement de l'IA qui apparaît rarement dans les billets de blog de lancement.
Au cœur du pipeline de révision des requêtes
L'objectif de ces équipes est simple sur le papier. Les sous-traitants lisent les requêtes soumises par de vrais utilisateurs, puis notent et critiquent les réponses produites par ChatGPT. Ces retours sont ensuite réinjectés dans le processus d'entraînement, façonnant le comportement du modèle la prochaine fois qu'une demande comparable se présente.
La portée est plus large que des questions isolées d'une seule ligne. Les évaluateurs peuvent se voir présenter des conversations entières entre un utilisateur et le chatbot, ce qui signifie qu'un échange complet — les relances, les corrections, les détails livrés en cours de route — peut défiler devant une personne. Les guides d'instructions fixent un standard exigeant pour ce qui constitue une réponse de qualité, décrivant une excellente réponse comme une réponse qui comprend l'intention réelle de l'utilisateur, apporte une aide précise et utile, et se lit clairement et naturellement avec un degré approprié de chaleur.
Le volume est justement le point clé. Des centaines d'évaluateurs traitant un flux continu de requêtes signifient que de véritables conversations sont consommées à grande échelle, et non échantillonnées occasionnellement pour des contrôles ponctuels. Pour une entreprise dont le produit traite un flux quotidien énorme de requêtes, cette couche humaine devient une partie permanente du cycle d'amélioration plutôt qu'un audit ponctuel.

Un angle mort de la vie privée pour des centaines de millions de personnes
OpenAI ne transmet pas les noms d'utilisateur aux évaluateurs, et l'entreprise affirme s'efforcer de retirer les données personnelles des requêtes avant qu'elles n'atteignent des yeux humains. Mais l'entreprise a reconnu que des informations sensibles peuvent malgré tout survivre à ce filtrage et parvenir jusqu'aux personnes qui les lisent.
Cette distinction compte énormément en pratique. L'anonymat au niveau du compte n'est pas la même chose que l'anonymat sur le fond. Si une requête décrit un diagnostic, un divorce, une dette, un conflit au travail ou une peur intime, la valeur identifiante réside dans le contenu lui-même, et non dans le pseudonyme qui y est attaché.
Et c'est précisément ce contenu que les gens apportent. ChatGPT est devenu un divan de thérapeute, un assistant professionnel et, dans certains cas, un compagnon numérique. Les utilisateurs confient régulièrement des détails intimes sur leur santé, leurs relations, leur argent et leurs inquiétudes — souvent précisément parce que l'interaction semble privée, instantanée et non observée.
« Je ne pense pas qu'ils l'imaginent »
L'écart entre la perception et la réalité est au cœur de cette affaire. Interrogé pour savoir s'il croyait que les utilisateurs de ChatGPT comprenaient que des humains pouvaient lire leurs conversations, une personne qui travaille sur les requêtes a été directe. Il a répondu non, ajoutant que les utilisateurs n'imaginaient pas qu'un sous-traitant quelque part analyse les conversations.
Cette attente est raisonnable à première vue. La plupart des personnes qui interagissent avec une fenêtre de chat ne voient aucun signal indiquant qu'une personne pourrait plus tard parcourir leurs mots dans le cadre d'un programme d'amélioration de la qualité. La lecture des requêtes pour le réglage du modèle n'est tout simplement pas annoncée comme peut l'être une nouvelle fonctionnalité ou une mise à jour de politique de sécurité.

Sycophancie, anthropomorphisme et préjudices réels
Les documents internes révèlent aussi ce que les évaluateurs sont chargés de corriger. Selon le reportage, les sous-traitants sont formés à détourner ChatGPT de l'anthropomorphisme — se présenter comme s'il était une personne dotée de sentiments ou d'une vie intérieure persistante — et à réduire sa sycophancie, la tendance réflexe à flatter et à approuver les utilisateurs plutôt qu'à les contredire.
Ce ne sont pas des défauts cosmétiques. La sycophancie excessive du modèle 4o d'OpenAI a été citée dans des procès comme facteur contributif dans les suicides de plusieurs personnes. Lorsqu'un système est réglé pour valider tout ce qu'une personne dit, les conséquences en aval peuvent aller bien au-delà d'une réponse de chatbot légèrement irritante. La couche de révision humaine est, en partie, une tentative d'atténuer ce mode de défaillance.
Pas la même chose que la révision de sécurité
Il convient de distinguer ce travail des mesures de sécurité qu'OpenAI a décrites publiquement. Celles-ci incluent l'examen des conversations lorsque l'entreprise détecte des utilisateurs qui semblent planifier de nuire à autrui — une intervention étroite, axée sur les crises.
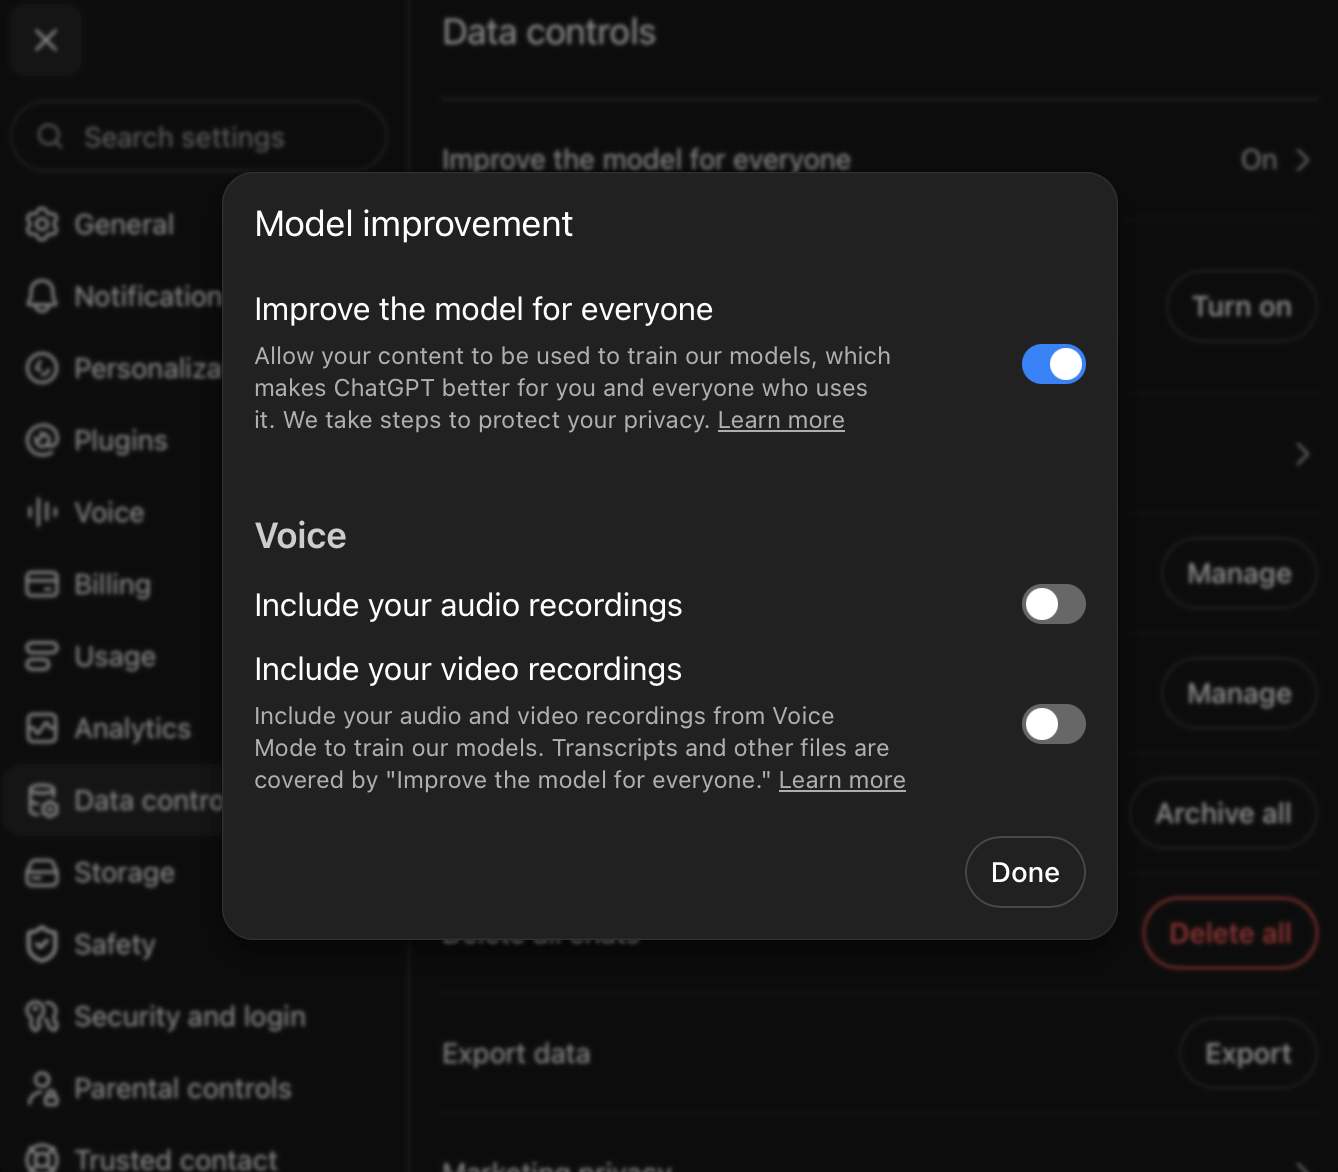
La révision des requêtes effectuée par les sous-traitants est une fonction tout à fait différente, visant la qualité des réponses au quotidien plutôt que la détection d'urgences. C'est précisément pourquoi elle touche tant de conversations ordinaires. Un utilisateur qui demande de l'aide pour rédiger un message difficile ou pour réfléchir à une décision personnelle n'est pas en crise et n'a aucune raison de s'attendre à un examen, et pourtant son échange peut atterrir dans une file de révision.

Anthropic confirme la même pratique
OpenAI n'est pas seul à adopter cette approche. Anthropic a confirmé à 404 Media qu'elle utilise elle aussi la révision humaine pour améliorer ses modèles, ce qui indique que la lecture d'interactions réelles d'utilisateurs est une pratique du secteur plutôt qu'une expérience isolée d'une seule entreprise. Cette constatation complique toute hypothèse selon laquelle changer de fournisseur résoudrait la question sous-jacente de la vie privée.
Le travail derrière l'illusion de l'amélioration
Le reportage remet aussi en question une explication répandue de la raison pour laquelle les modèles d'IA ne cessent de s'améliorer. Le récit habituel attribue ces progrès à l'aspiration massive de textes sur Internet, à des ingénieurs et chercheurs bien rémunérés, et à des générations successives d'architectures plus performantes.
Tous ces éléments comptent, mais ils en omettent un, plus discret et souvent négligé : des sous-traitants externes payés pour lire et noter de vraies réponses de ChatGPT, encore et encore, en volume. Ce travail humain constitue un apport significatif au produit, et il reste largement en dehors du récit public sur la manière dont les systèmes de pointe progressent.
Ce que les utilisateurs doivent retenir
- ChatGPT n'est pas un canal confidentiel. Les requêtes peuvent être lues par des sous-traitants humains travaillant à l'amélioration du modèle.
- Supprimer les noms d'utilisateur ne supprime pas le contexte. Les détails qu'un utilisateur livre peuvent être identifiants en eux-mêmes.
- La censure est imparfaite de l'aveu même d'OpenAI — des informations sensibles peuvent encore parvenir aux évaluateurs.
- La pratique dépasse une seule entreprise, Anthropic confirmant une révision humaine similaire.
- La révision des conversations liée à la sécurité et la révision des requêtes liée à la qualité sont des programmes distincts, et le second touche des conversations de routine.
Rien de tout cela ne rend automatiquement la pratique illégitime. Améliorer un système sur lequel des centaines de millions de personnes comptent pour des questions sérieuses exige une forme de retour d'information, et le jugement humain reste l'un des outils les plus efficaces disponibles. La question est de savoir si ce compromis est divulgué d'une manière que les utilisateurs peuvent réellement peser.
Pour l'instant, la réponse semble être non. Une personne qui tape une confession, une question médicale ou une crise professionnelle dans une fenêtre de chat n'est pas informée qu'un sous-traitant dans une file de révision pourrait la lire. Combler cet écart — par un avis plus clair, une dé-identification renforcée ou un filtrage plus rigoureux — est le test auquel le secteur est désormais confronté, et il sera jugé à la mesure de ce que les utilisateurs sont autorisés à savoir avant d'appuyer sur envoyer.
Cet article est basé sur un reportage de 404 Media. Lire l'article original.
Originally published on 404media.co


