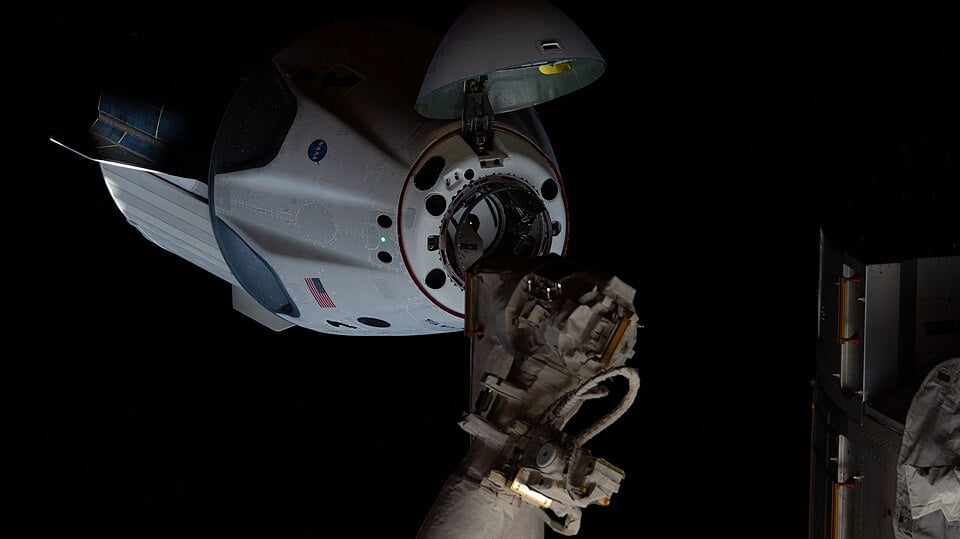
أصعب عملية ركن سيارة في النظام الشمسي
يبدو الالتحام بمحطة الفضاء الدولية، في الرسوم المتحركة، أشبه بباليه بطيء ورشيق. لكن الواقع أقرب إلى كابوس فيزيائي عالي المخاطر. تدور المحطة بسرعة تقارب 28,000 كيلومتر في الساعة، وعلى الكبسولة المقتربة أن تطابق هذه السرعة بينما تنزلق إلى منفذ الالتحام بحدود تفاوت تُقاس بالسنتيمترات. وكما وصفه الكاتب في Universe Today آندي توماسفيك، فإن الأمر يشبه السير على طريق سريع بسرعة 28,000 كم/س وركن السيارة بالتوازي داخل مرآب مفتوح على مختبر بتكلفة مليارات الدولارات يتحرك بالسرعة نفسها.
تضيف الميكانيكا المدارية تعقيدات قاسية لا يواجهها السائقون على الأرض. فإذا حاول الطيار التسريع إلى الأمام، فإن المركبة الفضائية تنحرف فعلياً إلى الأعلى. ولا يوجد احتكاك هوائي يبطئ المركبة تلقائياً. وعواقب الفشل كارثية: فقد يؤدي الاصطدام إلى مقتل كل من على متن المركبة الزائرة والمحطة، ويمكن أن يهدد حقل الحطام الناتج عشرات الأقمار الاصطناعية وحتى الأشخاص على الأرض.
لعقود، اعتمد مهندسو الفضاء على معادلات فيزيائية مبرمجة بشكل صارم وطيارين بشريين لتصحيحها. والآن، تقترح ورقة بحثية أولية جديدة من باحثين في ستانفورد، متاحة على arXiv، نهجاً مختلفاً. يعمل الفريق على بناء ذكاء اصطناعي ينفذ سلسلة من "المحاكاات الذهنية" — وهي قدرة يقولون إنها قد تغيّر جذرياً طريقة تفاعل المركبات الفضائية المستقبلية مع بعضها. ويُسمى نظامهم نموذج خارج هذا العالم، أو OWM.
كيف تلتحم المركبات الفضائية اليوم — وأين ينهار ذلك
لتقدير أهمية OWM، من المفيد فهم مجموعة الأدوات التقليدية للملاحة في المدار الأرضي المنخفض (LEO). تشغّل حواسيب الملاحة التقليدية خوارزمية التوجيه والملاحة والتحكم (GNC). كما تستخدم أداة رياضية تُسمى مرشح كالمان الموسّع، الذي يستوعب بيانات من مستقبلات GPS ومتتبعات النجوم ويُخرج دورات تشغيل الدفع اللازمة لتوجيه المركبة.
مرشحات كالمان ومشكلة الفيديو
مرشحات كالمان قوية، لكنها سيئة للغاية في معالجة الفيديو عالي السرعة. وهذا القيد يدفع المهندسين نحو تقنيات الرؤية الحاسوبية التقليدية. لكن في الفضاء، تواجه تلك التقنيات عقبة خطيرة: فهي هشة. فإذا انعكس ضوء الشمس عن مصفوفة شمسية، أو إذا غُطي جزء من الهدف فجأة بالظل، فقد تختل خوارزميات الرؤية الحاسوبية تماماً. وقد يتحول منفذ الالتحام الذي كان واضحاً في لحظة إلى شكل غير قابل للتعرف عليه في اللحظة التالية.
لماذا تتعثر خوارزميات التعلم المعزز
يبدو التعلم الآلي حلاً مثالياً، وقد جرّبه الباحثون. بدأوا بتطبيق خوارزميات التعلم المعزز (RL) — وهي العائلة نفسها من الأساليب التي علّمت الحواسيب الشهيرة الفوز في الشطرنج وDota. لكن RL له منطقة راحة ضيقة: فهو يتفوق عندما تكون القواعد ثابتة ومحددة. غيّر القواعد، مثل تبديل الجهة التي يقع فيها منفذ الالتحام على محطة الفضاء الدولية، ولن تعرف الخوارزميات ما تفعله. فمناورة التحام نجحت بلا عيب في تكوين واحد قد تفشل تماماً في تكوين آخر.
هنا يأتي نموذج خارج هذا العالم
جواب فريق ستانفورد هو "نموذج عالم". فبدلاً من حفظ مجموعة واحدة من القواعد أو الاعتماد على كشف سمات هش، يبني نموذج العالم تمثيلاً داخلياً للبيئة ويستخدمه لتنفيذ محاكاات ذهنية. ويمكن للمركبة الفضائية، فعلياً، أن تحلم بمستقبلات محتملة — متخيلة كيف ستغيّر دافعاتها مسارها، وكيف ستبدو المحطة وهي تدور، وكيف قد تتغير ظروف الإضاءة — قبل أن تلتزم بعملية دفع.
هذا خروج ذو دلالة عن كل من GNC الكلاسيكي وRL الخالص. تعتمد الخوارزميات الكلاسيكية على معادلات مصنوعة يدوياً يجب ضبطها لكل مهمة. ويعتمد وكلاء RL على تدريب مكثف في نطاق ضيق. أما نموذج العالم فيهدف إلى التعميم: فمن خلال تعلم نموذج تنبؤي لكيفية عمل العالم، يمكنه التكيف عندما يتغير السيناريو، مثل اتجاه مختلف لمنفذ الالتحام أو ظلال غير متوقعة.
تشبيه البيسبول: التفكير دون معادلات
يشرح الباحثون المفهوم بتشبيه لا علاقة له بالصواريخ: لاعب بيسبول أو كريكيت يلتقط كرة عالية. عندما يتحرك لاعب الميدان لالتقاط الكرة، فإنه لا يبدأ فوراً في حل معادلات تفاضلية جزئية. بل يعتمد على نموذج حدسي تنبؤي لمسار الكرة — محاكاة ذهنية مبنية على الخبرة. يركض ويعدّل ويعترض الكرة دون أن يحسب مساراً على الورق أبداً.
يمنح نموذج العالم المركبة الفضائية شيئاً مشابهاً. فبدلاً من حل معادلات الحركة المدارية صراحة في كل خطوة، يمكن للذكاء الاصطناعي محاكاة النتائج داخلياً. ويمكنه أن "يحلم" بطريقه عبر اقتراب الالتحام، مختبراً أفعالاً افتراضية مقابل نموذجه المتعلم للفيزياء والإدراك. وإذا تنبأت المحاكاة الذهنية باصطدام أو اختلال في المحاذاة، يمكن للنظام أن يعدّل قبل أن تسوء المناورة في العالم الحقيقي.

ما قد يعنيه هذا للمركبات الفضائية المستقبلية
تمتد الآثار إلى ما هو أبعد من الالتحام بمحطة الفضاء الدولية. فمع تشغيل مزيد من المركبات الفضائية ذاتياً — لخدمة الأقمار الاصطناعية، أو تجميع الهياكل في المدار، أو التنقل في ممرات مدارية مزدحمة — تصبح القدرة على التفكير في مواقف جديدة أمراً أساسياً. وقد لا تتوسع المعادلات المبرمجة بشكل صارم والرؤية الحاسوبية الهشة إلى مستقبل يجب فيه على المركبات أن تتعاون وتتجنب الحطام وتتكيف مع ظروف لم يتوقعها أي مهندس بالكامل.
ورقة ستانفورد هي ورقة أولية، أي أنها لم تخضع بعد لمراجعة الأقران، ولا يوضح النص المصدر بنية OWM أو بيانات التدريب أو معايير الأداء. لكن الفكرة الجوهرية مقنعة: علّم المركبات الفضائية أن تبني نموذجاً ذهنياً لعالمها، ثم دعها تتدرب في رأسها قبل أن تشغّل الدافعات. وإذا نجح ذلك، فقد يصبح الالتحام أقل شبهاً بعملية ركن سيارة بالتوازي تثير التوتر، وأكثر شبهاً بروتين — روتين تكون فيه المركبة الفضائية قد تخيلت ألف طريقة قد يسوء بها الاقتراب ووجدت مساراً عبرها.
وفي الوقت الحالي، تظل المشكلة مرهبة كما كانت دائماً. فمطابقة السرعات عند 28,000 كم/س، والتعويض عن الانحراف المداري، وتجنب اصطدام كارثي، ليست تحديات تختفي بين ليلة وضحاها. لكن باحثي ستانفورد يراهنون على أن الجيل التالي من المركبات الفضائية لن يحسب طريقه إلى المحطة فحسب. بل سيحلم طريقه إليها.
يعتمد هذا المقال على تقرير من Universe Today. اقرأ المقال الأصلي.
Originally published on universetoday.com