تُجمّع OpenAI قوة عاملة مهمتها قراءة ما يكتبه الناس في ChatGPT. ويُظهر تقرير نشرته 404 Media أن الشركة توظّف مئات المتعاقدين للعمل على تدفق كثيف من مطالبات المستخدمين الحقيقية — محادثات يفترض أكثر من 900 مليون مستخدم لروبوت الدردشة عمومًا أنها تبقى بينهم وبين الآلة.
ما راجعته المنصة لم يكن مذكرة مسرّبة واحدة، بل سلسلة كاملة من الوثائق: أدلة إرشادية داخلية، وقنوات Slack تستخدمها فرق المراجعة، ومطالبات ChatGPT حقيقية، ومعايير التقييم التي يطبّقها المتعاقدون لتصنيف ردود النموذج. ويقع كثير من هذه المواد تحت لافتة داخلية تشير إليها المنصة باسم "مشروع ليلي"، وتكشف عن جانب من تطوير الذكاء الاصطناعي قلّما يظهر في منشورات الإطلاق.
داخل خط مراجعة المطالبات
الغرض من هذه الفرق واضح على الورق. يقرأ المتعاقدون مطالبات قدّمها مستخدمون حقيقيون، ثم يقيّمون ردود ChatGPT وينتقدونها. وتُعاد هذه الملاحظات إلى عملية التدريب، لتشكّل سلوك النموذج في المرة التالية التي يصل فيها طلب مشابه.
النطاق أوسع من أسئلة منفردة من سطر واحد. فقد تُعرض على المراجعين محادثات كاملة بين المستخدم وروبوت الدردشة، ما يعني أن تبادلًا كاملًا — الأسئلة اللاحقة، والتصحيحات، والتفاصيل التي يقدّمها المستخدم طوعًا على طول الطريق — قد يمرّ أمام شخص. وتضع الأدلة الإرشادية معيارًا صارمًا لما يُعدّ مخرجات عالية الجودة، إذ تصف الرد الممتاز بأنه الذي يفهم القصد الفعلي للمستخدم، ويقدّم مساعدة دقيقة ومفيدة، ويُقرأ بوضوح وطبيعية مع درجة مناسبة من الدفء.
الحجم هو المقصد. فمئات المراجعين يعملون على تدفق متواصل من المطالبات، ما يعني أن محادثات حقيقية تُستهلك على نطاق واسع، لا تُؤخذ كعينات عرضية لفحوص متفرقة. وبالنسبة لشركة يتعامل منتجها مع تدفق هائل من الاستعلامات يوميًا، تصبح هذه الطبقة البشرية جزءًا قائمًا من دورة التحسين لا تدقيقًا لمرة واحدة.

نقطة عمياء في الخصوصية لمئات الملايين
لا تسلّم OpenAI للمراجعين أسماء المستخدمين، وتقول الشركة إنها تبذل جهدًا لإزالة التفاصيل الشخصية من المطالبات قبل وصولها إلى أعين البشر. لكن الشركة أقرّت بأن المعلومات الحساسة قد تنجو من هذا التصفية وتصل إلى الأشخاص الذين يقرؤون.
هذا التمييز مهم للغاية عمليًا. فإخفاء الهوية على مستوى الحساب ليس مثل إخفائها في المضمون. وإذا وصفت مطالبة تشخيصًا طبيًا، أو طلاقًا، أو دينًا، أو نزاعًا في العمل، أو خوفًا خاصًا، فإن القيمة التعريفية تكمن في المحتوى نفسه، لا في الاسم المرتبط به.
وهذا المحتوى هو بالضبط ما يجلبه الناس. فقد أصبح ChatGPT أريكة معالج نفسي، ومساعدًا مهنيًا، وفي بعض الحالات رفيقًا رقميًا. ويسلّم المستخدمون routinely تفاصيل حميمة عن صحتهم وعلاقاتهم وأموالهم ومخاوفهم — غالبًا لأن التفاعل يبدو خاصًا وفوريًا وغير مراقب.
"لا أعتقد أنهم سيتخيلون ذلك"
الفجوة بين الإدراك والواقع هي جوهر القصة. وعند سؤاله عما إذا كان يعتقد أن مستخدمي ChatGPT يدركون أن بشرًا قد يقرؤون محادثاتهم، كان أحد العاملين على المطالبات صريحًا. قال لا، وأضاف أن المستخدمين لن يتخيلوا وجود متعاقد في مكان ما يحلل المحادثات.
هذا التوقع معقول ظاهريًا. فمعظم من يتفاعلون مع نافذة دردشة لا يرون أي إشارة ظاهرة إلى أن شخصًا قد يمرّ لاحقًا على كلماتهم كجزء من برنامج تحسين الجودة. فقراءة المطالبات لضبط النموذج ببساطة لا يُعلن عنها كما يُعلن عن ميزة جديدة أو تحديث لسياسة أمان.

التزلّف والتشبيه البشري والضرر الحقيقي
تكشف الوثائق الداخلية أيضًا عما يُطلب من المراجعين تصحيحه. وفقًا للتقرير، يُدرَّب المتعاقدون على توجيه ChatGPT بعيدًا عن تشبيه نفسه بالبشر — أي تقديم نفسه كأنه شخص له مشاعر أو حياة داخلية مستمرة — وعلى تقليل تزلّفه، أي الميل الانعكاسي إلى الإطراء والموافقة على المستخدمين بدل الاعتراض.
وهذه ليست عيوبًا شكلية. فقد أُشير إلى التزلّف المفرط في نموذج 4o من OpenAI في دعاوى قضائية كعامل مساهم في حالات انتحار عدة أشخاص. وعندما يُضبط نظام على تبرير كل ما يقوله الشخص، قد تمتد العواقب اللاحقة إلى ما هو أبعد بكثير من رد مزعج قليلًا من روبوت دردشة. والطبقة البشرية للمراجعة هي، جزئيًا، محاولة لتخفيف نمط الفشل هذا.
ليست مثل مراجعة الأمان
يجدر فصل هذا العمل عن إجراءات الأمان التي وصفتها OpenAI علنًا. وتشمل تلك الإجراءات مراجعة المحادثات عندما تكتشف الشركة مستخدمين يبدو أنهم يخططون لإيذاء آخرين — تدخل ضيق موجّه نحو الأزمات.
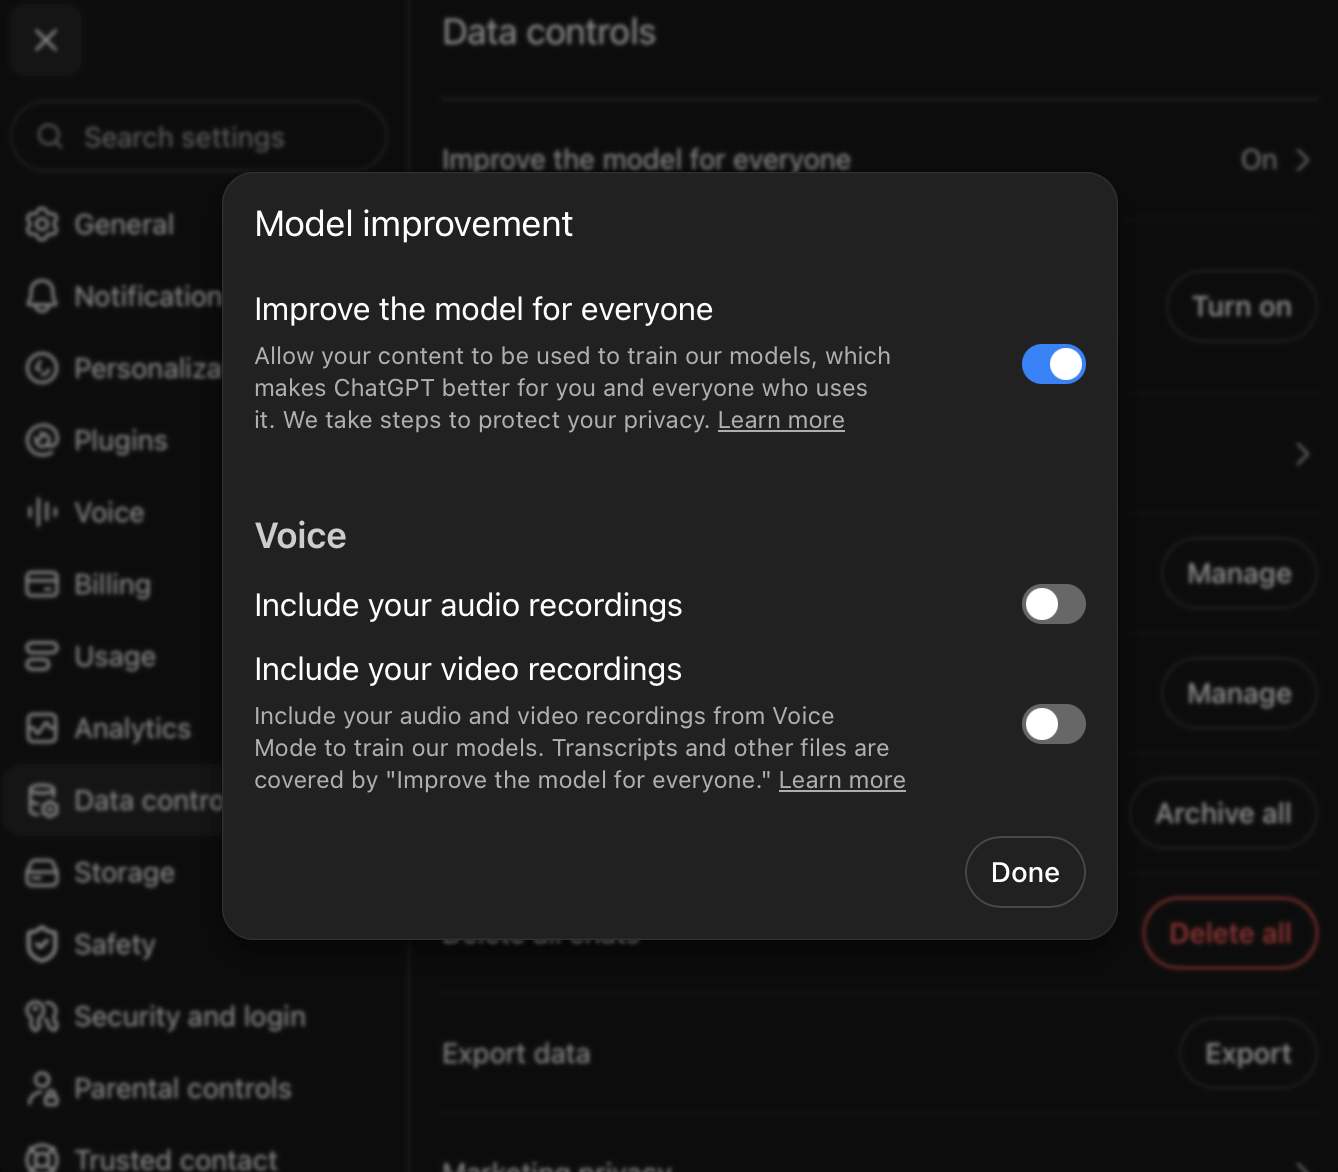
أما مراجعة المطالبات التي ينفّذها المتعاقدون فهي وظيفة مختلفة تمامًا، تستهدف جودة الإجابات اليومية لا الكشف عن حالات الطوارئ. ولهذا بالضبط تمسّ كثيرًا من المحادثات العادية. فالمستخدم الذي يطلب المساعدة في صياغة رسالة صعبة أو في التفكير في قرار شخصي ليس في أزمة وليس لديه سبب لتوقع التدقيق، ومع ذلك قد يصل تبادله إلى قائمة مراجعة.

Anthropic تؤكد الممارسة نفسها
OpenAI ليست وحدها في هذا النهج. فقد أكدت Anthropic لـ 404 Media أنها تستخدم أيضًا المراجعة البشرية لتحسين نماذجها، ما يشير إلى أن قراءة تفاعلات المستخدمين الحقيقية ممارسة صناعية لا تجربة منعزلة لشركة واحدة. وتُعقّد هذه النتيجة أي افتراض بأن تغيير المزوّد يحل مسألة الخصوصية الأساسية.
العمل الكامن خلف وهم التحسّن
يتحدى التقرير أيضًا تفسيرًا شائعًا لسبب استمرار تحسّن نماذج الذكاء الاصطناعي. فالسرد المعتاد ينسب الفضل إلى الكشط الواسع لنصوص الإنترنت، ومواهب هندسية وبحثية مدفوعة جيدًا، وأجيال متعاقبة من المعماريات الأكثر قدرة.
كل ذلك مهم، لكنه يغفل شيئًا أهدأ وكثيرًا ما يُتجاهل: متعاقدون خارجيون يُدفع لهم لقراءة ردود ChatGPT الحقيقية وتقييمها، مرارًا وتكرارًا، وبكميات كبيرة. هذا العمل البشري مدخل ذو معنى في المنتج، وهو يقع إلى حد كبير خارج السرد العام عن كيفية تقدّم الأنظمة المتقدمة.
ما ينبغي أن يستخلصه المستخدمون
- ChatGPT ليس قناة سرية. فقد يقرأ المطالبات متعاقدون بشريون يعملون على تحسين النموذج.
- إزالة أسماء المستخدمين لا تزيل السياق. فالتفاصيل التي يقدّمها المستخدم طوعًا قد تكون تعريفية بذاتها.
- الحجب غير كامل بإقرار OpenAI نفسها — فقد تصل معلومات حساسة إلى المراجعين.
- الممارسة تتجاوز شركة واحدة، إذ أكدت Anthropic وجود مراجعة بشرية مماثلة.
- مراجعة المحادثات المتعلقة بالأمان ومراجعة المطالبات المتعلقة بالجودة برنامجان منفصلان، والثاني يصل إلى المحادثات الروتينية.
لا شيء من هذا يجعل الممارسة غير مشروعة تلقائيًا. فتحسين نظام يعتمد عليه مئات الملايين في أسئلة جدية يتطلب شكلًا من أشكال التغذية الراجعة، ويبقى الحكم البشري من أكثر الأدوات المتاحة فعالية. والسؤال هو ما إذا كان هذا المقايضة يُفصح عنه بطريقة تتيح للمستخدمين تقييمه فعلًا.
وفي الوقت الحالي، تبدو الإجابة لا. فالشخص الذي يكتب اعترافًا، أو سؤالًا طبيًا، أو أزمة مهنية في صندوق دردشة لا يُخبر بأن متعاقدًا في قائمة مراجعة قد يقرؤه. وسدّ هذه الفجوة — عبر إشعار أوضح، أو إخفاء هوية أقوى، أو تصفية أكثر صرامة — هو الاختبار الذي تواجهه الصناعة الآن، وسيُحكم عليه بمقدار ما يُسمح للمستخدمين بمعرفته قبل أن يضغطوا إرسال.
يعتمد هذا المقال على تقرير نشرته 404 Media. اقرأ المقال الأصلي.
Originally published on 404media.co


